| 编辑推荐: |
本文介绍招商局狮子山人工智能实验室发布的具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」:MoE 架构、总参数约35B、每 Token 仅激活约3B,通过"能力蓝图—能力编译—监督核验—评测反哺"的数据引擎,在十项具身基准上实现全部指标提升,并附四道公开基准题目的对比解析,希望对你的学习有帮助。
本文来自于微信公众号「量子位」,由火龙果软件Alice编辑推荐。 |
|
日常生活里人类的直觉判断,放到机器人身上往往会变成棘手难题:画面中物体位置更高,并不等同于它在真实三维空间里处于更高位置;更换拍摄角度后家具外观发生改变,但它仍是同一个物体;画面内物体发生位移,可能是物体本身在移动,也可能只是相机镜头在转动。视角变化混淆物体身份、误判相机运动、错估任务进度,都会直接造成机器人执行失败。
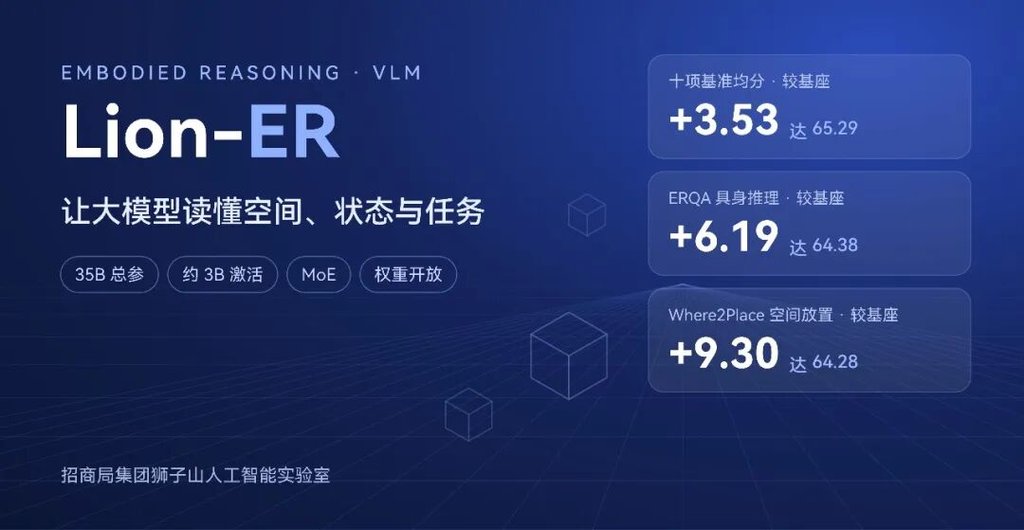
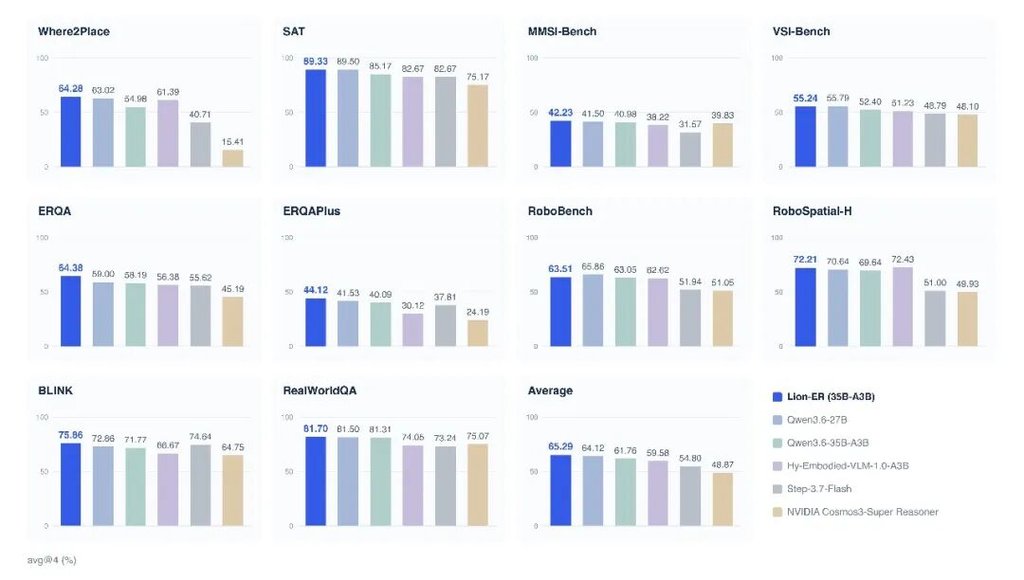
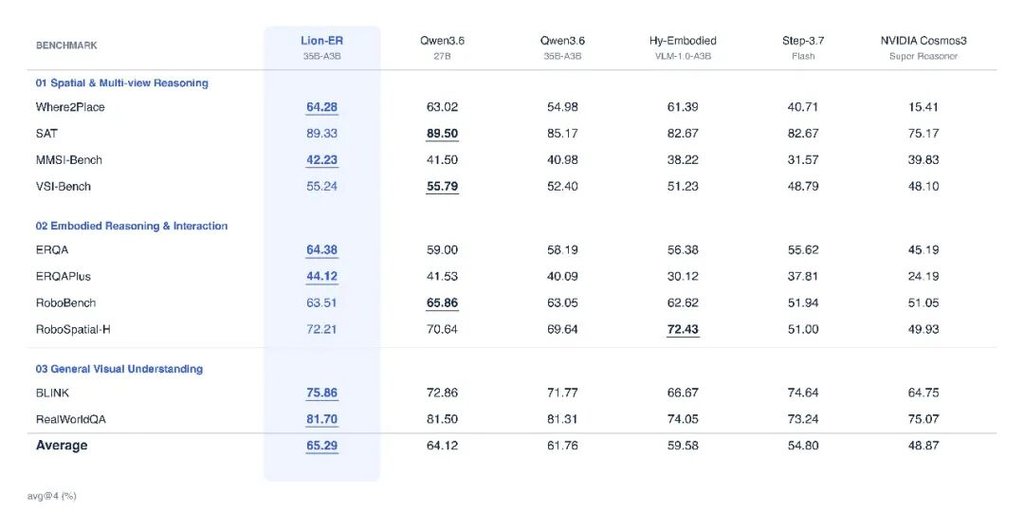
近日,招商局先进技术研究院下属狮子山人工智能实验室发布具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」。该模型采用 MoE 混合专家架构,总参数约35B,每个 Token 仅激活约3B;在不显著增加推理开销的前提下,在十项主流具身相关基准上实现全部指标上涨,多项核心能力超越更大参数量的主流模型,走出了一条区别于大规模堆砌训练数据的技术路线。
这套模型是怎么炼成的?
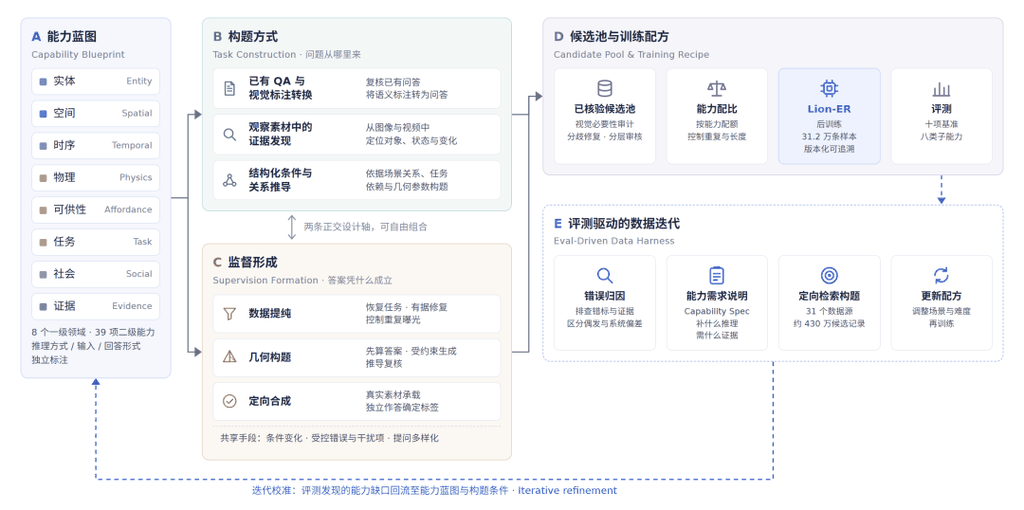
已有研究表明,在既有机器人数据集内,仅调整不同数据域的训练权重,就能明显影响下游任务表现——更多数据,并不等于更多能力。「驭物™」的核心亮点并非单纯提升参数量,而是搭建了一套能力牵引的具身数据引擎:摒弃盲目收集海量数据的传统做法,围绕模型需要掌握的能力做正向设计,再依靠评测发现短板,闭环迭代优化数据。
第1步:明确模型该学会什么
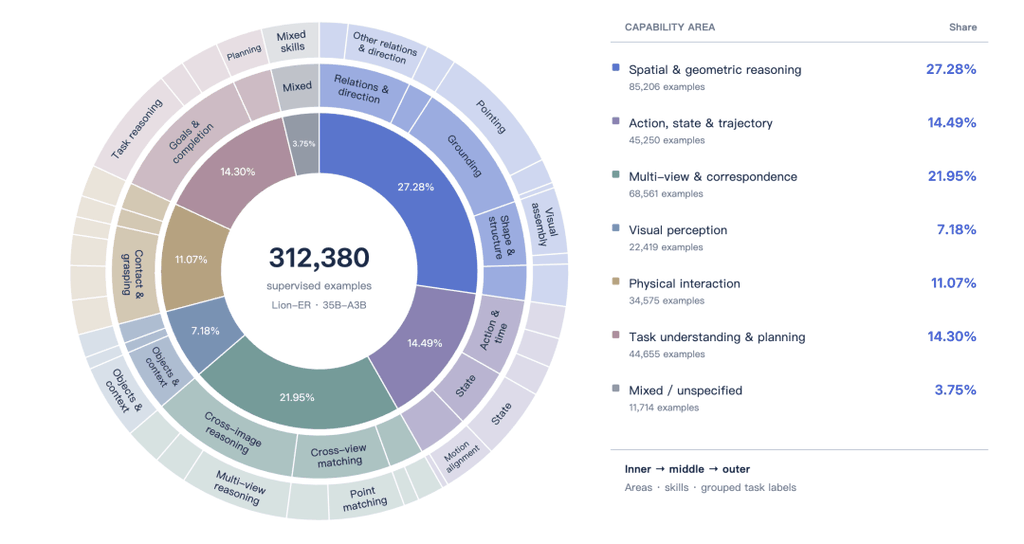
团队梳理出一张细粒度的"能力蓝图",将具身推理拆解为实体、空间、时序、物理、可供性、任务、社会、证据等8个一级领域,细化出39项二级能力,并把推理方式、输入形式和回答形式作为独立维度分开标注。蓝图不仅定义了模型需要学习哪些能力,还明确了这些能力应在何种条件下被调用;真实任务往往涉及复合能力,团队在蓝图阶段就分别记录主能力与辅助能力,训练采样时也考虑不同因素的组合与留出,避免某类能力始终绑定在少数固定场景上。
第2步:把抽象要求变成一道道训练题目
团队将落地流程命名为"能力编译":把抽象的能力目标逐项拆解、落地为"需要什么场景、怎样组织观察、提出什么问题、依据什么确定答案"。以跨视角推理为例,先明确提供给模型的视角数量、需要在多张画面之间建立关联的目标物体,以及判定方位时采用的观测者位置与朝向;同时核验素材本身——如果关键视角缺失、证据不足,这道题就只能依靠猜测,不能纳入合格训练样本。
第3步:保证每道训练题目有据可依
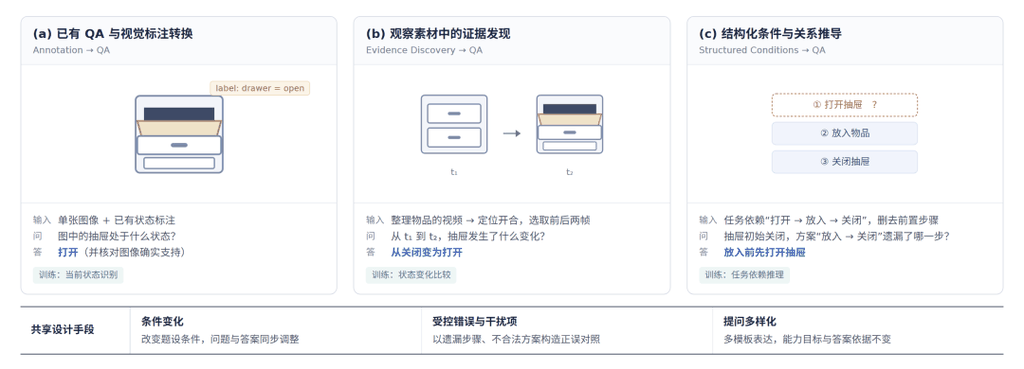
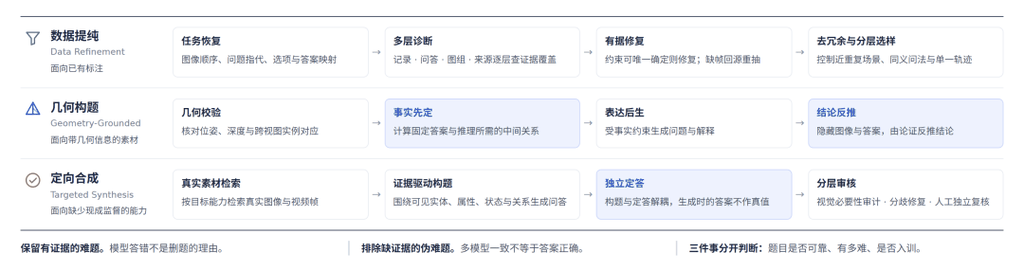
构题方式层面,团队设计了三条可互相组合的路径:从已有问答与视觉标注中转换、从观察素材中发现证据、从结构化条件与关系中推导。监督核验层面,采用数据提纯、几何构题、定向合成三条互补路线,其中定向合成生成的问题与标注必须经过独立作答或额外审核,绝不把生成模型的答案直接当作真值。整套流程始终坚持一项原则:保留有证据的难题,排除缺证据的伪难题;对模型持续失误的高难样本,进一步引入人工复核与可视化核验平台,避免将模型能力边界误判为数据问题。
第4步:评测结果直接反哺数据迭代
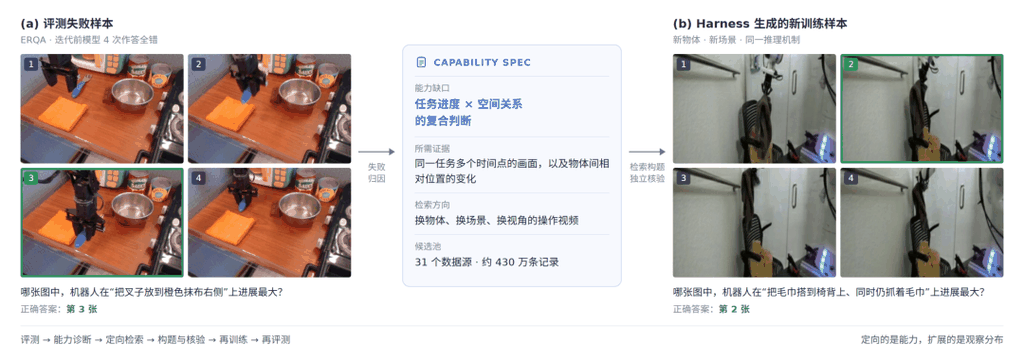
「驭物™ Lion-ER-35B-A3B」的监督训练集共包含312380条样本,训练时按能力需求分配训练预算,而不是由数据源的题量决定权重。评测通过 Eval-Driven Data Harness 机制反哺数据:发现错题后,先核查标注、画面证据与评分是否存在问题,再区分偶发失误与系统性能力短板;确认能力缺口后,从覆盖31个数据源、约430万条记录的素材池中,检索推理逻辑相同、场景不同的新素材,经构题核验后加入训练,再通过新一轮评测验证效果。数据不再是一次性的静态供给,而是随模型能力持续演化。
仅激活约3B参数,十项基准全部提升
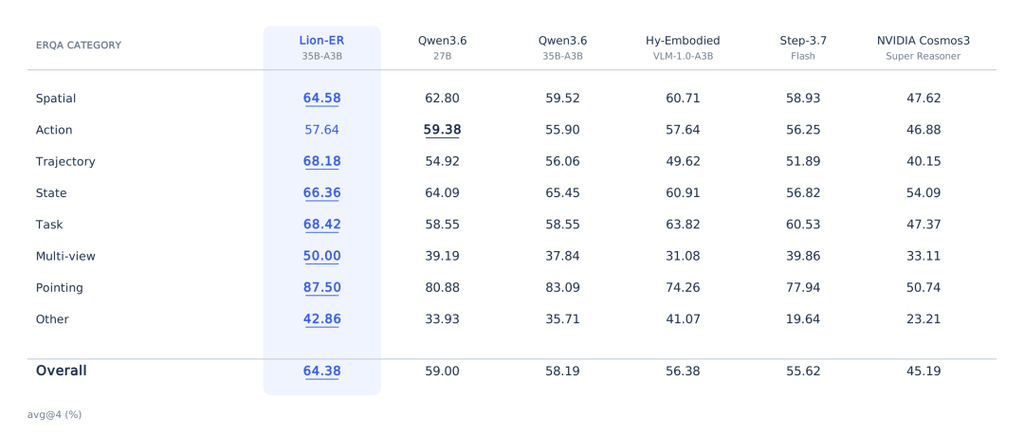
评测采用 avg@4 口径,即每道题让模型独立作答4次取平均分。在评测覆盖的十项公开基准上,「驭物™ Lion-ER-35B-A3B」的等权综合均分达到65.29,整体结果显示其各项得分均高于所用基座,部分指标超过参数量更大的主流模型。
| 评测基准 |
得分 |
较基座提升 |
| Where2Place 空间放置 |
64.28 |
+9.30 |
| ERQA 具身推理 |
64.38 |
+6.19 |
| SAT 空间推理 |
89.33 |
— |
| ERQA 轨迹理解子类 |
68.18 |
+12.12 |
| 十项基准等权综合均分 |
65.29 |
— |
四道公开基准题目,直观看到能力差距
下面四道案例全部来自公开评测基准。同一道题目,「驭物™ Lion-ER-35B-A3B」、基座 Qwen3.6-35B-A3B、Qwen3.6-27B 分别独立作答4次。
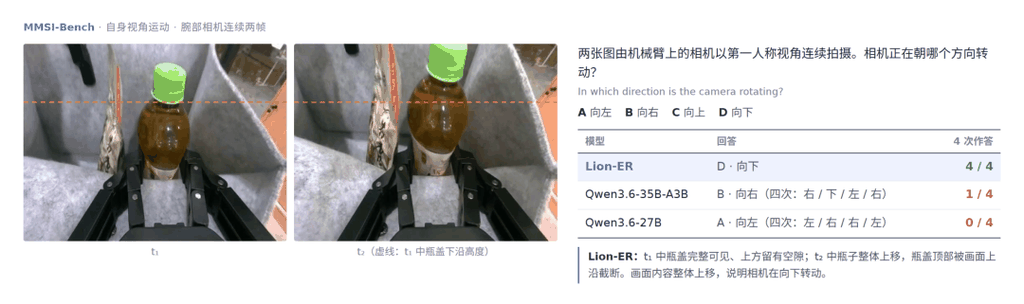
题目1:辨方向,相机到底向哪边转动?
两张图片来自机械臂第一人称相机的连续拍摄:瓶子在画面中整体向上偏移,问题是相机正在朝哪个方向转动。基座仅答对一次,Qwen3.6-27B 全部答错;「驭物™」通过两帧画面的变化规律,正确判断相机向下转动,4次作答全部答对。对机器人来说,画面里物体位置发生变化,首先要分清变化来源——是物体本身在移动,还是相机自身发生了转动。
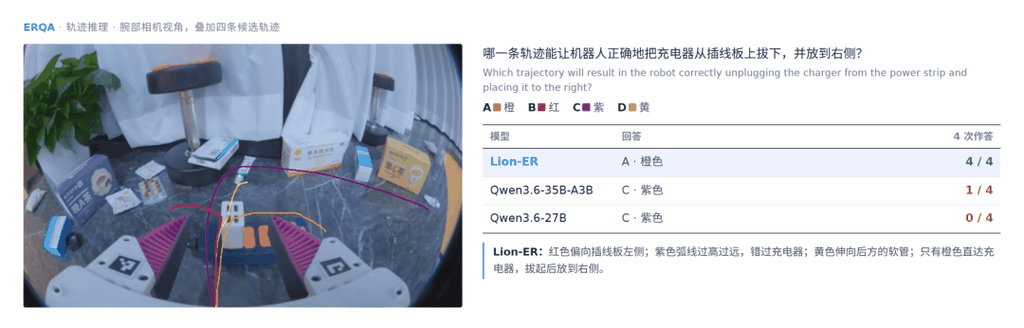
题目2:选轨迹,哪条路径可以完成任务?
机械臂的目标是把充电器从插线板拔下、放到画面右侧,四条彩色轨迹中该选哪一条?两个对比模型都被向右延伸的紫色长弧线误导;「驭物™」逐一排查无效路线——红色偏向插线板左侧、紫色无法接触充电器、黄色伸向后方软管,选出唯一能先抵达充电器、完成拔取再移动到右侧目标位置的橙色轨迹,4次作答全部正确。这道题考验的核心,是把目标、路线与具体操作联系起来。
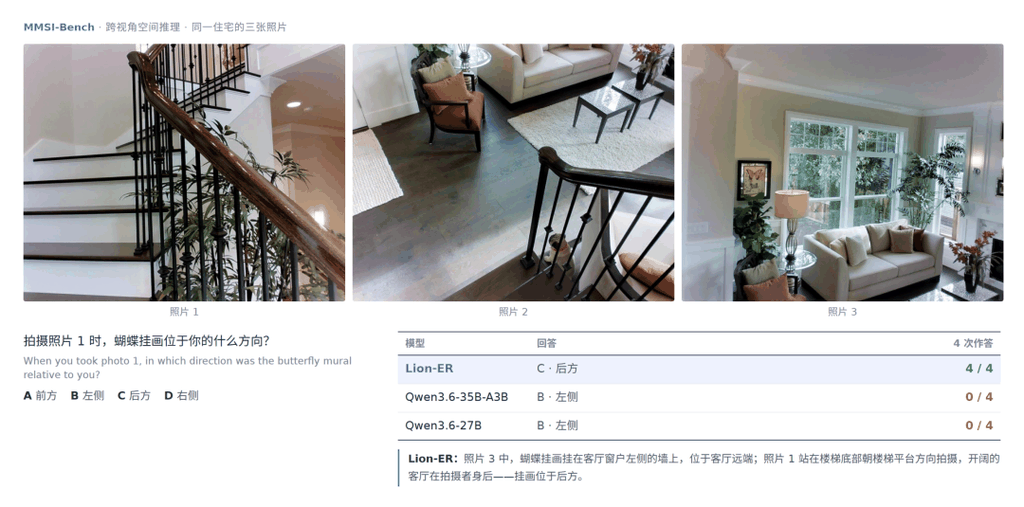
题目3:跨视角,挂画在拍摄者哪一侧?
题目给出在同一住宅内拍摄的三张照片,蝴蝶挂画只出现在第三张,要求判断拍摄第一张照片时挂画位于拍摄者的什么方向。这需要串联多张画面、重建空间布局:拍摄第一张照片时,拍摄者站在楼梯底部、面朝台阶,客厅在他身后,因此挂画位于拍摄者后方。两个对比模型都答成了"左侧",4次作答无一答对;「驭物™」4次判断全部准确。
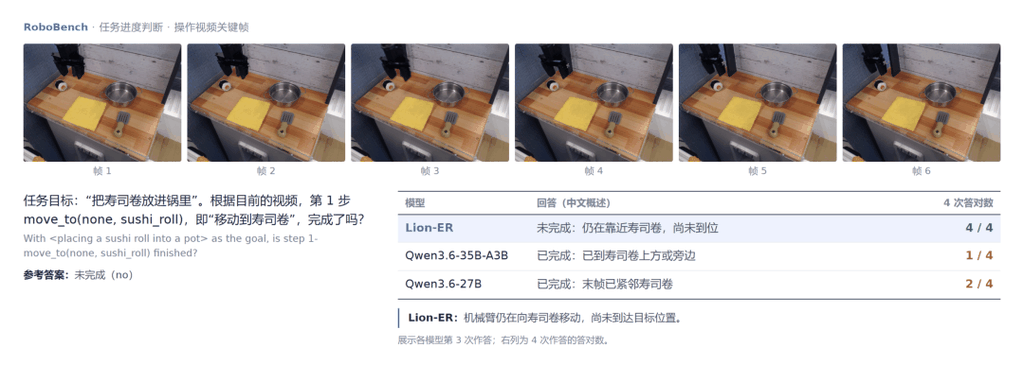
题目4:看进度,这一步任务做完了吗?
这是一段机器人操作视频,任务指令为把桌上的寿司卷放进锅里,问题是视频当前时刻第一步"移动到寿司卷"是否已经完成。基座4次作答中有3次误判"已完成",Qwen3.6-27B 也有半数回答做出同样误判;「驭物™」4次最终答案均判断为"尚未完成"。画面里出现动作,不等于对应任务步骤已经达成——一旦误判进度,机器人就会提前执行后续动作,整套时序流程都会出错。
具身大模型不仅要看懂画面,更要理解物理现实
「驭物™ Lion-ER-35B-A3B」带来的不只是一组亮眼的分数,更是一套可复用的方法论:让能力成为数据的设计单元,让评测成为数据生产的起点——从能力蓝图到数据配方,从一次评测失败到一批新的训练数据,每一步都有明确的目标、可核查的证据和可追溯的记录。目前模型已在 Hugging Face 开源权重,采用 BF16 Safetensors 格式,原生兼容 Transformers、vLLM、SGLang 等主流推理框架;后续团队将面向具身 Agent 拓展工具调用、多轮交互与执行反馈等训练数据,探索长程任务中的连续决策与失败恢复。
模型权重地址如下,开发者可围绕空间关系理解、场景状态分析、任务进度判断和空间约束理解等方向开展评测与适配:
https://huggingface.co/cmriat/lion-ER-35B-A3B |
| 
 学习助手




 订阅