| 编辑推荐: |
文章主要介绍了智能体(Agent)调用技能(Skill)的机制,包括Skill的渐进式披露原理、三种典型调用方式(模型自主、用户显式、混合)、主流产品(GPT/Claude/DeepSeek、Cursor/Codex/WorkBuddy)的实现差异,以及如何根据业务场景选择合适的调用策略,希望对你的学习有帮助。
本文来自于微信公众号「小强匠」,由火龙果软件Alice编辑推荐。 |
|
技能(Skill)是一种渐进式披露的工具设计理念,智能体是包括思考、决策、执行的任务实现机制,两者之间松散式、低耦合的协同机制,衍生了不同的Skill调用方法。
01 为什么要细说Skill机制
对于明确、少量的Skill场景,调用机制很简单,采用字典和映射机制,加上少量硬编码就可以实现。
但随着业务的复杂度提高、场景不断细分,各Skill间的边界慢慢模糊,职责和底座出现重合,Skill的颗粒度也越来越细,甚至出现Skill群的模式,此时简单的调用机制就会捉襟见肘,在准确性、效率方面成为瓶颈。
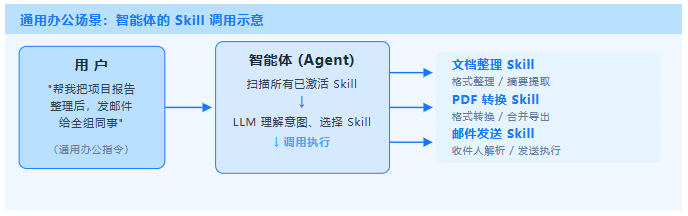
▲ 通用办公场景多类 Skill 调用 示意
此外,明确的Skill调用机制还会严重限制智能体(Agent)和大模型(LLM)的灵活性和自主性,Agent的自主规划也逐渐形同虚设。所以,Skill调用还是值得做下梳理。
02 再看什么是Skill和Agent
什么是技能(Skill)
这个在智能问数智能体的Skill设计中有说过,Skill可以看成给Agent准备的「标准作业程序」或工作手册:把某类任务要用的指令、脚本和资源打成一个文件夹,Agent碰到相关任务就主动翻阅。
Skill提出了一种渐进式的架构,从模糊到准确,从目标到步骤,从整体到细节,从思路到模板,从设想到验收。一整套的体系,让那些基于模糊语言的大模型,能理解具体场景,按需要实现任务。
什么是智能体(Agent)
智能体(Agent)也没有唯一的、标准的定义,它是一种任务执行的模式,所谓”智能“主要体现在对任务的自主思考、记忆、决策和执行方面。再简单点,可以按英文单词Agent来理解,它是你的任务代理人,你的秘书。
附两个定义供参考:
- 根据《人工智能智能体互联》系列国标,智能体被定义为“具备自主感知、记忆、决策、交互与执行能力的智能系统”。
- 经合组织(OECD)倾向于将“智能体AI”描述为由多个协调的AI智能体组成的系统,能够分解任务、协作,并在最少人类监督下自主追求复杂目标。
要提醒的是,智能体不是大模型特有的概念,就像人工智能这个词也不这两年出来的。只要一个系统能在场景中自主感知、决策、记忆、行动,以达成目标,它就可以被称为智能体。
大模型只是当前实现这些能力的一种主流技术,但不是定义智能体的必要条件 ,即并不是必须基于大模型实现的才叫智能体。
啰嗦这句是想说: 没必要迷信大模型,同时也别僵化Agent、Skill的概念 ,它俩只是经典模式在大模型这个新事物下的新表现形式而已。
小结:Agent、Skill分别面向任务规划执行、工具实现,前者负责整个任务的执行过程,后者管某个具体的事儿怎么干,它俩之间有着更松散的设计模式和理念。
03 典型的Skill调用机制
先看Skill是如何分步披露信息的
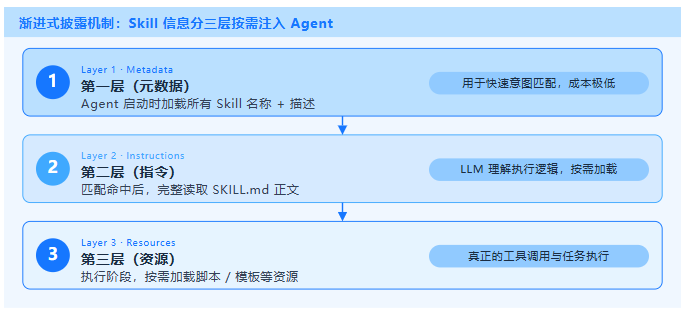
Skill是理念是渐进式披露,主要3个阶段:
第一层(元数据):Agent加载所有Skill的名称和描述,用于快速匹配。
第二层(指令):当模型判断任务和某Skill相关时,开始完整读取相应的SKILL.md正文。
第三层(资源):任务具体执行时,按需加载Skill文件夹内的脚本、模板等必要资源。
▲ 渐进式披露机制:Skill 信息按三层分步注入 Agent
再看Skill是怎么被调用的
目前有3种常见的Skill调用方式:
1、模型自主调用: 大模型自主理解、调用,当前是最主流的模式。
2、用户显示调用: 用户直接使用/或@进行显式注入。
3、混合模式: 以上两种模式同时存在。
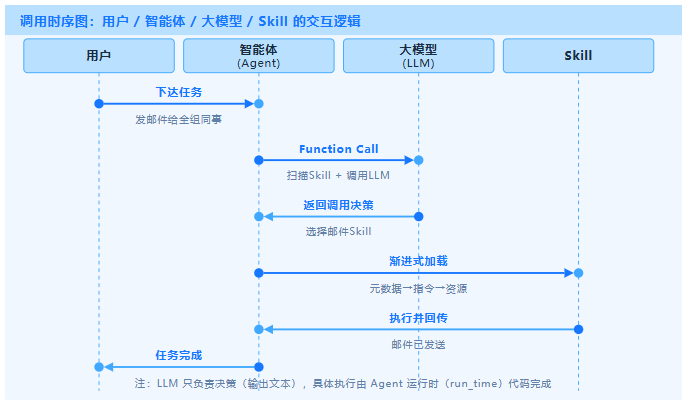
第1种最常见,来个例子:当用户要求把XX材料邮件发给XX人时,智能体会调用大模型,把已经安装(启用)的所有技能扫描一遍,比如邮件类、word类、pdf类等,然后按你的要求“思考”之后,决定调用邮件类Skill,然后开始具体工作执行。
用户 / 智能体 / 大模型 / Skill 在任务中的交互时序
这里有个细节必须得解释:所谓大模型自主调用Skill,并不是LLM直接调用,说到底LLM只是语言模型,只能输出文案,这是它的能力边界。即: 大模型本身不能直接执行任何 Skill,它只能“决定”并输出一个调用请求,具体调用、执行要借助物理代码。
可以这样理解:模型负责决策,运行时(run_time)负责执行。
- 因为开头的输入和落地的执行都不在LLM那,所有我把它称作 “两头在外”的调用模式。
可以看出,在简单、封闭、单步的Skill调用中,LLM的作用只是“思考”一下就决定了调用哪个Skill,在架构上就像一个“松散耦合的映射器”,去完成目标Skill的映射。
其实这种场景,用关键词匹配、意图分类器、决策树等传统代码也能实现,而且更快、更便宜、更可控,很多传统客服机器人就在这么做的。
- 当然LLM的能力并不止这些,在真实、开放、复杂的场景里,大模型承担的是语义理解、上下文推理、任务规划、参数生成、动态调整等认知工作,远不止“选一个 Skill”。
因为开头的输入和落地的执行都不在LLM那,所以我把它称作“两头在外”的调用模式。
04 主流产品的实现方式
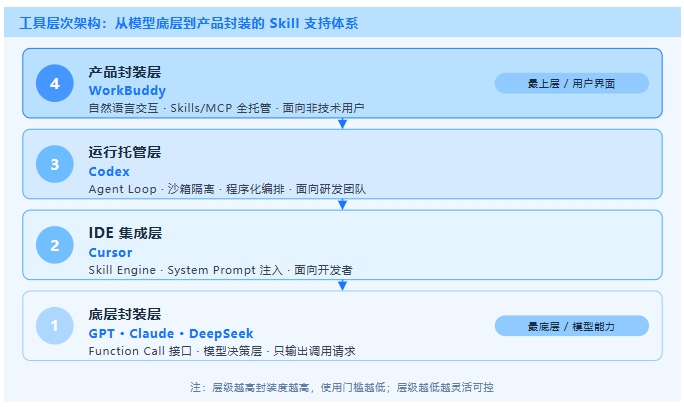
基于上面Agent和Skill的基础交互机制,再说下当前主流的大模型和工具,具体是如何实现Skill调用的。大致分两大类:模型类和工具类。
模型类:GPT、Claude、DeepSeek
这些大模型对Skill的调用,已经同步提供了底层的“调用能力”。当我们要通过大模型调用Skill时,就可以直接调用它们封装好的 Function Calling(函数调用) ,它们本身不执行任何Skill,只负责“决策”,即根据上下文决定是否调用、调用哪个、传递什么参数,并以结构化格式返回建议和意图。
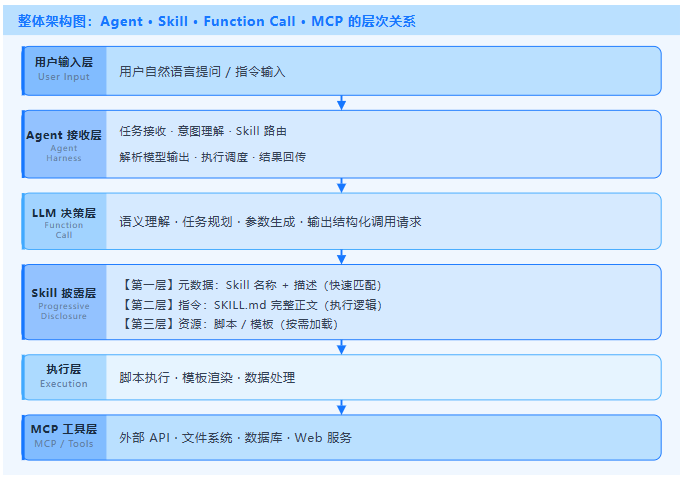
这里提醒下Function Call和MCP的不同: Function Call解决的是Agent和Skill之间的关系,MCP解决的是Skill和Tool之间的问题。
整体架构图:用户提问 → Agent → LLM → Skill 渐进披露 → MCP 工具的完整链路
工具类:Cursor、Codex、WorkBuddy
这些工具产品在模型提供的能力之上,封装了完整的 Agent 运行时(Harness),把“解析模型输出 → 路由 → 执行 → 回传”的整个过程内置到产品中,我们在使用时可以无感实现Skill使用,无需自己实现这套逻辑。
不过这些工具在具体的Skill调用上,也有不同的定位及设计理念,以下是简要梳理:
| ●●●tool_comparison.md | # 工具类产品对 Skill 的不同定位
Cursor —— IDE 内置型(面向开发者)
内置 Skill Engine,启动时自动扫描本地 .cursor/skills/ 等目录,将 Skill 的 name + description 注入 System Prompt,供具体场景处理时调入。
Codex —— 运行托管型(面向研发团队)
自带 Agent Loop,除了大模型调用,还包括处理模型输出,负责工具具体执行,以及代码运行时的沙箱隔离。
WorkBuddy —— 产品封装型(面向非技术用户)
把Agent、MCP、Skills、模型调用等一股脑全部封装,用户只需要用自然语言下达任务即可。 |
一句话小结: Cursor 是 IDE(开发环境)内置型 ,Skill的发现和调用与编码工作流深度绑定,面向开发者比较友好。 Codex 是运行时托管型 ,提供完整的 Agent Runtime,支持程序化编排和沙箱执行,封装更高一层,使用者不必关注细节,面向对象又上一层。 WorkBudd则是产品封装型 ,把复杂技术细节全部隐藏,面向非技术用户,基本可以无脑使用。
挑这3个工具,也是想表达不同的工具定位和理念,工具没有好坏,只是使用场景和面向用户不同而已。
从模型底层 Function Call 到产品封装的 Skill 支持体系
05 根据业务场景选择调用机制
如第3节分析的,大模型能力很强,但在Skill的调用场景发挥的有限,我们不必为了大模型而大模型,为了智能体而智能体,没有困难硬给自己制造就不好了。 有时经典的架构和硬编码反而是更稳定、可控的选择。
在我们实际的Agent、Skill协同方面,可以根据不同的场景选择合适的方案,以下列几个我涉及到的仅供参考:
通用办公场景
比如基于WorkBuddy的办公实现,这是Skill发挥最灵活的场景,直接使用工具的自带机制及预置Skill即可,不用过多关注技术实现。如果实在自带的东西不够用,只需新设计Skill,然后按相关标准(API)导进去就行。
推理分析场景
这种一般涉及复杂知识库或知识图谱,对推理分析的需求多,且对准确度要求高,因此不同的任务组织和Skill调用方式,会对最后结果影响很大。这类建议使用LangChain/LangGraph等主流框架自己设计任务规划逻辑和Skill调用机制,做到相对可控、可追溯。
智能问数场景
这类场景对效率、精度、校验等要求最高,也是LLM能力发挥相对最少的场景。此类任务组织和Skill调用,建议引入基于硬编码的任务引擎(engine)和运行时(run_time)管理,以保持整体高效、准确,并在语义理解、结果分析、内容组装、动态编码等场景按需调用LLM即可。
此外,在Skill的交互流程设计、后端架构设计中,可考虑引入几种方式来保障架构稳定和效率:
- 优先通过@或/等方式,开启Skill的直接注入。
- 在服务或会话中,预置Skill字典或图谱,以快速映射匹配。
- 旁路(绕开)Agent的模糊语义理解和向量召回机制,以降低复杂度以及对语义召回的干扰。
- 为Skill调用、运行全过程配置完善的运行框架硬编码
上面是面向从0到1的全新任务的设计建议,但在实际工作中,我们经常是边实现、边迭代,这又是另一个维度, 总的思路还是实现第1、效率其次,不必考虑太多完美的架构设计。
在产品初期,技术路线不是关键,业务实现才是。AI框架的迭代基于以月为单位,这就像等火车,是只能等、不能追的。经典的模式仍然是非常好的基础,对于AI相关技术,建议用降级的思路,在保证业务稳定的前提下,谨慎升级主流技术。
| 
 学习助手




 订阅