| 编辑推荐: |
文章主要介绍了办公智能体 Skill 的概念、搭建方法、多 Skill 组织方式、使用途径及调试迭代经验,并以政策收集汇总场景为例,说明如何用 SKILL.md 调度、参考模板给口径、脚本管执行、检查做验收,从而让智能体稳定完成办公任务,希望对你的学习有帮助。
本文来自于微信公众号「小强匠」,由火龙果软件Alice编辑推荐。 |
|
书接上回,做了两个办公Skill:政策收集汇总、材料检索编写,见链接: WorkBuddy+Skill:办公智能体搭建实践 。
和之前做的业务场景的Skill相比, 这次的两个Skill算简单的。不过越简单的越有大道,正好可以用来验证、反思Skill的几个常见问题,比如到底什么是Skill、它是怎么搭建的、如何使用等。
01 什么是Skill?
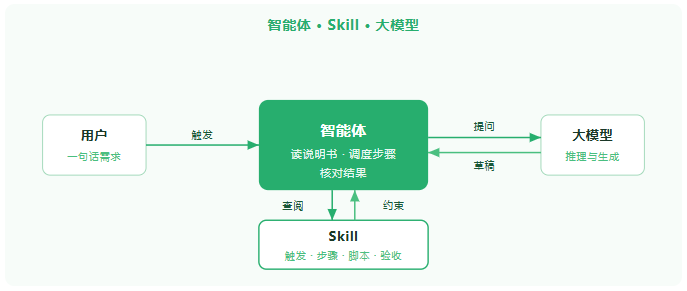
Skill,也叫技能,是一份写给智能体看的说明书:用什么话能叫醒它、分几步走、每步读什么、产出什么。 有点像工作里的操作手册——把「怎么干」写清楚,智能体才不会各干各的。
Skill可以只有几句话,也可以是一堆内容的组合。这几句话写的好,就是情书,就像《飞驰人生》里张弛和宇强的配合,领航员路书写的好,车手就能游刃有余,大家配合的天衣无缝。写的不好,车手(大模型)就像没头的苍蝇,处处碰壁,到处踩坑,还不如没有。
先看看靠谱的Skill长啥样
靠谱的 Skill 往往不是单独一个 SKILL.md,而是一整套能对上的东西: 主说明书 管触发和步骤, 参考 管口径, 模型/词表 管分类, 脚本 管执行, 检查 管验收。
| ●●●skill-layout.md | skill-name/ # 一套作业说明书
SKILL.md # 主说明书:触发语、步骤、产出、验收
references/ # 参考:规范、操作步骤、口径
需求怎么拆.md # 输入怎么问、默认值怎么回显
输出长什么样.md # 汇报模板,避免各写各的
models/ # 模型/词表:受控分类,不靠模型自己猜
主题词表.md # 检索词、归类、图谱共用同一套
scripts/ # 脚本:关键操作的执行体
do_the_work.py # 采集、落盘、回写索引
checks/ # 检查:干没干、干的咋样,看结果
audit.py # 假路径、缺正文、重复项
# 关系:SKILL.md 调度;参考/词表给口径;脚本落地;检查验收。
# 写在提示词里的,智能体可以绕过;写在脚本和检查里的,绕不过。 |
02 Skill的搭建过程
Skill的搭建过程,跟产品设计过程很像,有几个重要步骤: 开展需求分析,明确Skill的使用场景、业务定位、如何调用、输入需求、操作步骤、过程参考、辅助脚本、输出要求、检查手段等 。
再补几条容易漏的: 触发语 写清楚,什么话该叫醒它; 边界 写清楚,什么该它干、什么不该它干; 失败留痕 写清楚,别让它口头说「搞定了」;跟相邻 Skill 怎么分工、共享什么、不抢什么;以及用过之后怎么迭代。做完这些,Skill就基本靠谱了。
当然,如果你某方面的专家,也可绕过上面所有步骤,直接手搓提示词,咱不抬杠。
以下根据政策收集汇报场景的Skill为例,大概整理说明一下。
1、用户需求:
定期从目标网站搜索行业政策,跟踪动态;
按关键字检索历史政策库,开展对比分析;
定期形成行业政策简报。
2、需求分析
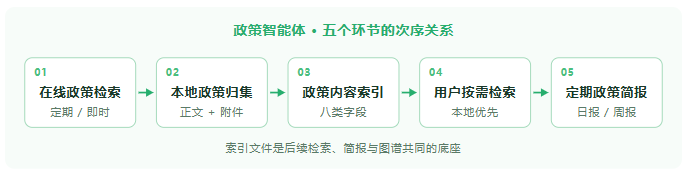
一个典型的流程包括:在线政策检索(定期、即时)、本地政策归集、政策内容索引、用户按需检索、定期政策简报等几个场景。
▲ 政策智能体的五个环节
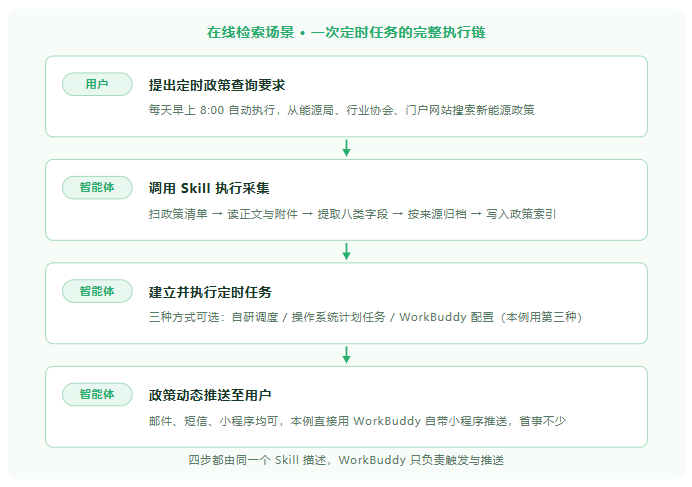
其中“调用 Skill 执行采集”这一步,是整条链路里最实的部分,具体要做四件事:
1.从相关在线网站,扫描符合条件的所有政策清单;
2.对政策文件进行读取,提取文件名称、政策类型、发布来源、发布时间、关键字、主要内容、附件、原文链接等信息;
3.提取完成后,对政策做本地存储,注意确认正文及所有附件都完整下载;
4.下载完成的文件,按目录进行存储、归档,并结合政策提取的关键信息,建立政策信息索引,用作后续检索、分析使用。
▲ 一次定时政策查询任务 3、Skill主描述
分析过程上篇说过了,这里直接上Skill.md主描述:
| ●●●policy-query/SKILL.md | ---
name: policy-query
description: 临时政策查询与检索。用户说「查政策」「找政策」「政策查询」「有没有XX的政策」时使用。先按四要素解析需求并回显,再本地索引优先检索,本地没有才上网采集。在线采集一律走 fetch_policy.py,完整性与查重由脚本判定。界面出清单+概览+失败清单。若有新政策入库,收尾必须运行 skills/_shared/scripts/sync_graphs.py 刷新知识图谱。
agent_created: true
---
# 临时政策查询
## 何时使用
- 查政策 / 找政策 / 政策查询 / 检索政策
- 有没有 XX 方面的政策 / 找一下 XX 文件
- 在能源局网站查… / 在本地目录扫…
- @policy-query
## 工作空间
`{知识库根目录}`。开工前先读这几份共用规范,别凭印象干:
| 文件 | 管什么 |
|------|--------|
| `_shared/政策需求解析.md` | 四要素怎么拆、怎么回显 |
| `_shared/政策主题词表.md` | 主题归类与检索词组,唯一权威 |
| `_shared/政策网页采集操作步骤.md` | 网页怎么采:probe → fetch → 退出码 |
| `_shared/政策库结构与索引字段.md` | 目录怎么摆、索引有哪些列(写索引时对照) |
| `_shared/政策输出格式.md` | 汇报长什么样 |
| `_shared/政策Skill问题与修订记录.md` | 踩过的坑与现行口径(改 Skill 时同步更新) |
---
## 执行次序(七步,不许跳步、不许换序)
### 第 1 步 · 解析需求并回显
按 `政策需求解析.md` 拆出**目标来源、时间范围、目标政策、输出形式**四要素,
用那份文件里的模板回显一遍。
- 目标政策没说清 → **停下来问**,列出 T1–T7 供选,不许猜着开工。
- 其余三项缺省有默认值,回显时把默认值明说,不要默默套用。
### 第 2 步 · 定路由
| 用户怎么说 | 走哪条 |
|------------|--------|
| 指定网站 / 在线 / 公网 | 只走在线(跳到第 4 步) |
| 指定本地目录 / 离线 | 只走本地(第 3 步做完直接到第 7 步) |
| **未指定来源** | **本地优先**:第 3 步查本地,不够再第 4 步上网 |
| 明说「本地+在线都要」 | 两条都走 |
### 第 3 步 · 本地检索(默认起点)
1. 读 `政策信息索引.md`,匹配 **文件名称 + 主题 + 关键字 + 主要内容 + 发布来源**,
不能只做文件名包含。
2. 主题匹配用词表:用户给的关键字先归到主题,再把该主题下所有政策捞出来当候选,
**这是「关键字部分匹配」的落地方式**——两条政策只要共用一个关键字就该被一起捞出。
3. 索引信息不够就打开源文件核对段落。
4. **命中后必须核对正文文件真的在硬盘上**(`Path.exists()`)。
索引写了路径不等于文件存在——「假路径」一律当作未命中,转第 4 步补采,
并在汇报里说明是补采。命令用 `--repair --apply-index`。
5. **原文链接无效**(站点首页、日期目录、带「(媒体追踪)」括号备注)的条目,
不能直接采;先找回真链再采。可用 `audit_policy.py` 第 4 项排查。
本地够用就直接到第 7 步,不要为了"更全"擅自上网(那是扩大范围,见需求解析纪律 1)。
### 第 4 步 · 在线采集
按 `政策网页采集操作步骤.md` 走,**一条都不许绕过脚本手写索引行**:
1. 用 `policy_topics.py --list` 取主题的检索词组,去目标来源搜出候选链接
2. 候选全部先 `fetch_policy.py --url ... --probe`,退出码 2 的是已有的,直接剔除
3. **补采**(已有但缺正文/假路径):用 `--repair --apply-index`,不要只 `--probe` 就跳过
4. **新采**:`fetch_policy.py --url ... --dest ... --apply-index`(必须带 `--apply-index`)
5. 来源优先级见 `政策主题词表.md`「推荐检索来源」与采集步骤:
**部委 / 中国政府网 / 派出机构 > 地方 / 交易中心 > 协会 > 门户/媒体**。
北极星等媒体站易遇反爬,只作线索;有官方链就用官方。官方只有新闻稿、
全文 PDF 在可靠转载站时,**原文链接写官方(可用 `--official-url`)**,正文原件
可来自转载,采集记录里保留实际下载 URL。图谱「原文链接」来自索引,不是
`_采集记录.json`。
6. 落盘:有正文附件只下原件;否则必出 `正文.docx`+`正文.md`;附件用人话名
`附件N:标题.ext`(禁止 CMS 哈希名),同内容多链去重;每次必写 `_采集记录.json`。
反爬失败只写说明、不写脚本碎片。
7. 记住每条退出码,3 和 4 进失败清单;质量门禁未过的会判缺正文,不许改成「完整·转存」
### 第 5 步 · 写索引
优先依赖 `--apply-index` 自动回写。手工改时:完整性照抄脚本判定,主题用
`policy_topics.py --classify` 判,本地路径写脚本给的真实路径,**不许写「(待归档)」占位**。
补采前若标题与已有行高度重合,**合并到已有行**,不要新建第二条。
总部内部通知不进政策库,改走材料「总部文件」并告知用户。
### 第 6 步 · 刷新图谱(硬性,不可跳过)
按 `_shared/索引出图联动.md`,与材料侧同一条命令、同一种回执:
```
python skills\_shared\scripts\sync_graphs.py
```
无条件跑。纯本地命中、没改索引时跑它也无妨——脚本自己比时间并打印「跳过」,
这时回执就写「图谱:无变动,已是最新」。
### 第 7 步 · 汇报
按 `政策输出格式.md`:**清单表 → 逐个概览 → 失败清单 → 服务入口 → 图谱回执**。
- 界面这份就是工作简报,**默认不落盘**。用户明确说「下载简报」才按输出格式里的
Word 版式生成到 `政策/_简报/{日期}-临时查询.docx` 并给路径。
- 源文链接必须出现在对话里,不要只写「见本地索引」。
- 有新入库的,收尾跑一次 `audit_policy.py`,有问题先修再汇报。
---
## 服务入口
- 「打开第 N 个」→ 用系统打开本地正文或附件
- 「打包」→ 复制到 `政策/_简报/打包-{日期}/` 或打 zip,给出路径 |
模板与参考 这里有个原则: 语言模型(LLM)并不值得信任。 因为Skill描述都是文本,但如果全靠文本,那智能体、大模型在执行时,就会出现不同模型之间的结果千差万别。因为到底怎么干、干没干、干的咋样,全靠大模型自己的理解、自己说了算,就是我们常说的没有客观标准。
所以,耳听为虚,眼见为实,凡事看结果。 为了保证输出的稳定性,要对关键操作给出具体的模板和参考。
以本例的Skill描述为例,相应增加了几个参考和脚本:
1、几个子Skill共用的东西都放进 _shared:需求解析、主题词表、采集步骤、库结构与索引字段、输出格式是参考和模板等;
2、按需增加配套的执行脚本:fetch_policy、policy_topics、make_docx,都是py文件;
3、各步骤执行完成后,增加检查:audit_policy、check_consistency、sync_graphs;
SKILL.md 只负责调度,口径和结果不靠它口头说了算。
03 多Skill及文件的组织
上面的例子是围绕一个场景展开,但并不是代表只能有1个Skill,在实际操作中,一个场景的实现可能对应多个Skill职能;这几个Skill流程相互衔接、边界清晰,互不冲突且共享内容和输出。以下是政策场景的5个细分Skill目录:
| ●●●skills/tree.md | skills/ # 政策场景:五个职能 + 一套共用
policy-query/ # 临时查询:四要素 → 本地优先 → 必要时采集
SKILL.md
policy-schedule/ # 定时扫描 + Word 简报
SKILL.md
policy-index/ # 投递箱归集、更新索引
SKILL.md
policy-compose/ # 专题汇总报告
SKILL.md
policy-graph/ # 知识图谱
SKILL.md
scripts/build_graph.py # 出图,不另写临时脚本
_shared/ # 共用规范、词表、脚本
政策需求解析.md
政策主题词表.md
政策网页采集操作步骤.md
政策库结构与索引字段.md
政策输出格式.md
scripts/ # fetch / topics / docx / audit / sync |
04 Skill如何使用
一个完整的Skill就像一套齐全的作业说明书,可以直接拿过来(下载或复制),导入你的智能体工具使用,比如Cursor、Codex、WorkBuddy等,并不受本地环境的限制。导入也很简单:把整个 Skill 文件夹放到工具约定的目录,再跟它说一声「用这个」即可。
Cursor :把文件夹放到项目里的 .cursor/skills/,或用户目录 ~/.cursor/skills/,对话里 @ 一下就能用。
WorkBuddy :把 Skill 放进授权知识库目录下的 skills/,工具启动时自动加载。授权目录对了,拷过去就能用。
05 重视Skill的调试迭代
如果说大语言模型(LLM)不可信,那Skill也没那么可信。智能体常告诉我们一切顺利,但实际验证时往往有各类的问题。
以政策Skill的调试过程为例,也出现了一些典型问题,比如:
假路径——索引写了路径,硬盘上没有文件;
缺正文——目录在,正文没落下来;
完整性自说——智能体口头说采全了,实际没采全;
图谱不刷——索引改了,图谱还是旧的;
关键字口径——同一主题说法不统一,对不上
……
这里想补充的是,Skill的使用,并不是从GitHub或其它地方拿来就万事大吉了, 它需要持续的完善,而且它们的完善或使用是同步进行的 ,即:我们常会在使用过程中,同步要求智能体更新Skill的细节,这样你的Skill才会随着使用变得越来越好用。
| 
 学习助手




 订阅