| 编辑推荐: |
本文主要介绍如何利用腾讯的 WorkBuddy 平台,结合自定义的 Skill(技能),搭建两个面向日常办公场景的智能体(政策跟踪分析和材料追溯整合)的实践经验,希望对你的学习有帮助。
本文来自于微信公众号「小强匠」,由火龙果软件Alice编辑推荐。 |
|
WorkBuddy 的出现,让智能体的 搭建 及应用都快了一步,离用户也更近了一步。结合两个定制办公智能体场景,做了尝试,效果还不错。
01 为什么选择WorkBuddy?
主要是用户要求 。 像很多广告里说的:“对于 XX,最开始我是拒绝的,后来抱着试试看的心态试了一下”。面对腾讯铺天盖地的广告,作为一个智能体的设计人员,对这个“大路边”的产品,跟大家对很多广告的感觉差不多,开始有点拒绝,甚至觉得它不靠谱。
后来结合用户需求,做了架构设计、路线选型,还有用户场景的匹配,分析下来,使用 WorkBuddy 还真是一个 小快灵的 MVP(最小可行产品)验证思路 。
02 用户的2个需求
用户提了两个日常办公的场景:政策跟踪分析、材料追溯整合。
1、政策跟踪分析场景
定期从目标网站搜索行业政策,跟踪动态; 按关键字检索历史政策库,开展对比分析; 定期形成行业政策简报。
2、材料追溯整合场景
能方便地找到重点文件,如领导讲话、会议报告; 能按关键字方便地找到文件,及相关段落内容; 能在相关材料中提取内容,完成基础材料拼装。
这两个 需求 并不难,有些基础功能 WorkBuddy 本身就能实现,但要实现完整、稳定闭环,还需自己加装 Skill,这样目标就很明确了。
如果按之前的套路(完全自己整),要先有智能体程序,再加上大模型、向量库、用户交互界面,以及后端服务部署等。相比之下,用 WorkBuddy 可以省去前端和一大部分架构工作,设计人员 只需要关注需求的核心:技能(Skill)的实现 即可。
03 政策智能体
需求分析
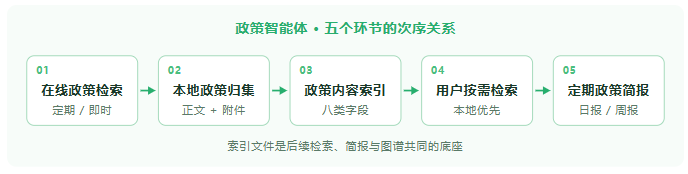
一个典型的流程包括:在线政策检索(定期、即时)、本地政策归集、政策内容索引、用户按需检索、定期政策简报等几个场景。
▲ 政策智能体的五个环节
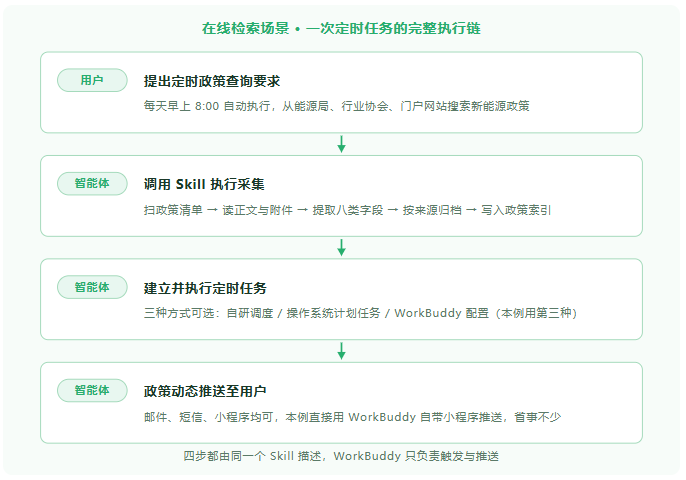
以在线检索场景为例:
▲ 一次定时政策查询任务
其中“调用 Skill 执行采集”这一步,是整条链路里最实的部分,具体要做四件事:
1.从相关在线网站,扫描符合条件的所有政策清单;
2.对政策文件进行读取,提取文件名称、政策类型、发布来源、发布时间、关键字、主要内容、附件、原文链接等信息;
3.提取完成后,对政策做本地存储,注意确认正文及所有附件都完整下载;
4.下载完成的文件,按目录进行存储、归档,并结合政策提取的关键信息,建立政策信息索引,用作后续检索、分析使用。
定时任务: 目前有 3 种方式:自研定时任务服务、基于操作系统定时任务、基于 WorkBuddy 配置定时任务,本例使用方式 3。
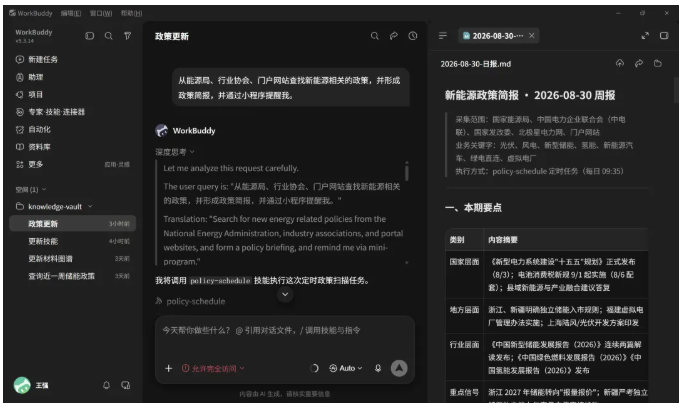
推送方式 常见的包括: 邮件推送、短信文本推送、小程序(App)推送,本例使用 WorkBuddy 自带小程序推送,省事不少。 |
搭建思路
有了 WorkBuddy,主要设计 Skill 即可。
Skill 就是一份写给智能体看的说明书 :用什么话触发它、分几步走、每步读什么、产出什么、落到哪个目录,全部写死,不留“看情况”这类含糊表述。政策这条链路按“采集 → 归档 → 索引 → 简报 → 出图”切成六段,每段都标清楚输入输出和落盘路径,跑起来才稳定。
| ●●●policy-schedule / SKILL.md | # 定时政策查询
description: 每天 / 每周自动跑一遍,采集 → 归档 → 索引 → 简报 → 出图
## 1. 圈定范围
业务范围与关键字(新能源、电力市场、储能 …)
目标来源:能源局 / 行业协会 / 门户网站
## 2. 在线采集
扫描符合条件的政策清单
逐条读取正文 + 全部附件(不能只读摘要)
提取:名称 / 类型 / 来源 / 时间 / 关键字 / 主要内容 / 附件 / 原文链接
## 3. 落盘归档
只给附件不给正文的网站,把正文另存为 Word 一并存下
核对「正文 + 附件」完整性后才算成功
E:\XXX\政策\_归档\{来源大类}\{机构}\
## 4. 更新索引
追加或更新 政策信息索引.md(按原文链接去重)
## 5. 输出简报
界面展示 + 落盘 政策\_简报\{日期}-政策简报.md
推送:WorkBuddy 自带小程序
## 6. 收尾(硬性,不能跳)
python skills\_shared\scripts\sync_graphs.py
# 索引一改,图谱必须跟着重出,否则用户看到的是旧图 |
注意: WorkBuddy 里已有类似的 Skill,但对用户的一些细节要求还搞不定,想要完整实现还得自己手搓,这次还是用 Cursor 辅助设计,下同。
04 材料智能体
需求分析
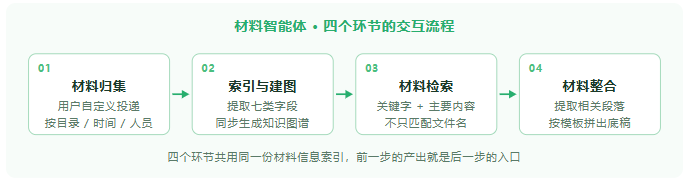
它的典型交互流程包括:
步骤 1 材料归集
用户将重要的领导讲话、工作汇报、会议材料等信息,放入指定工作目录,具体组织方式由用户自定义,如按目录、时间、关键字、人员等方式;
步骤 2 材料信息索引
智能体扫描本地文件改动,提取文件名称、材料类型、相关人员、材料时间、关键字、主要内容、原文目录等信息,完成材料信息索引更新,建立知识图谱,用作后续检索、分析使用;
步骤 3 材料检索
用户按特定条件查找相关材料,智能体结合材料信息索引查找文件并返回,给出界面的信息总结反馈,支持材料的查看、路径浏览、批量下载(复制)功能;
步骤 4 材料整合
用户要求(如关键字、信息片段等),查找所有相关的材料片段,提取部分段落信息,并按用户要求的模板结构进行材料组合,形成基础的材料底稿,供用户查看、下载使用。
▲ 材料智能体的四个环节
搭建思路
材料这条链路的难点不在功能,而在用户材料“放得乱、找得准”这对矛盾上。用户投递时怎么方便怎么来,智能体这边就必须把两件事定死:一是 归档目录规范 ,五类材料各归各位;二是 索引字段口径 ,索引时要尽量明确、简洁,比如用户放入的目录优先,不允许智能体自己推断出第二个答案。这两件事一旦对齐,后面的检索、整合、出图就都是顺水推舟。
| ●●●material-index / SKILL.md | # 材料归集与索引
description: 扫投递箱 → 判类型 → 归档 → 写索引 → 刷图谱
## 1. 扫描投递箱
E:\XXX\材料\_投递箱\
# 用户怎么放都行,按目录、时间、人员都不影响后面
## 2. 判定材料类型(必须读正文,不能只看文件名)
领导讲话 → 看标题、副标题、落款里的姓名
总部文件 → 看发文部门;总部通知也归这里,不进政策库
工作会议 → 年中会 / 季度会等成套材料
汇报交流 → 对上报送、对外交流
其它材料 → 暂未分类的兜底
## 3. 归档(目录名必须与索引字段对得上)
_归档\领导讲话\{XXX}\
_归档\总部文件\{XXX部}\
_归档\工作会议\{会议名称}\
_归档\汇报交流\{年份}\
## 4. 写索引
文件名称 / 材料类型 / 来源部门 / 相关人员
材料时间 / 关键字 / 主要内容 / 原文路径
# 来源部门恒等于归档路径里的部门段;用户放入的目录优先,不许自己推断
## 5. 收尾(硬性,不能跳)
python skills\_shared\scripts\sync_graphs.py |
05 用于追溯的知识图谱
以上两个是基础场景,随着政策文件、工作材料的不断增多, 用户对于信息的追溯和关联分析诉求越来越强, 比如查看各省能源局对同一政策的配套政策情况,或者查看某位领导在不同场景对某个工作的要求等, 这就需要知识图谱出场了 。
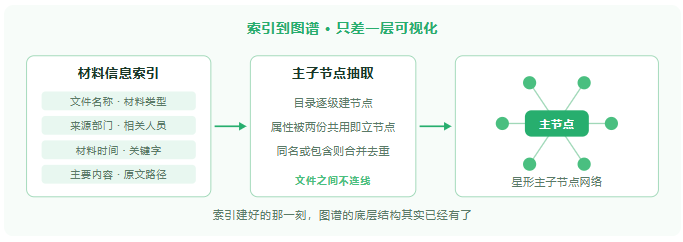
其实在前面的场景实现过程中,索引文件的建立已经为知识图谱提供了很好的底层基础,现在 只需要提供可视化交互 即可。
▲ 从索引到图谱,中间只隔了一层节点抽取
这里参照了之前的一个 Skill( 一个基于知识图谱的智能体可视化工具 ),做了部分改造。改造完的 material-graph 做的事情其实就一件:把材料信息索引整份读进来,按规则算出主节点和连线,吐出 HTML,用户在WorkBuddy中就能直接浏览(本地直接查看文件也可),不依赖任何服务。
用户在图上能做的操作有这么几样: 顶栏搜词, 命中的节点高亮、其余压暗,右边直接给命中数; 左侧单击, 就能只看某一类文件或某一类连线,只想看目录树就把属性线全关掉; 单击文件节点, 右侧面板列出它的材料类型、来源部门、相关人员、材料时间和原文目录,支持浏览、打开; 右键某节点, 可只看该节点分支,沿连线保留它的全部上级和全部下级,方便回溯跟踪,按 Esc 或点顶栏按钮回到全局。
| ●●●material-graph / SKILL.md | # 材料知识图谱
description: 把材料信息索引渲染成可交互的单文件 HTML 图谱
## 命令(只跑这个脚本)
python skills\material-graph\scripts\build_graph.py --mode material
# 产出单文件 HTML,双击就能开,不依赖任何服务
## 1. 出图前体检
数一遍索引行数与归档目录里的文件数,对不上先回去补索引
校验 来源部门 ↔ 归档路径,不一致就打印告警、不出图
## 2. 建主节点(两个来源,图例只按“是什么”分类)
目录主节点 归档目录逐级建:总部文件\{X}=部门 领导讲话\{X}=人员
工作会议\{X}=会议 汇报交流\{X}=年份
属性主节点 材料时间、关键字;一个值被 ≥2 个文件共用才立节点
## 3. 合并去重(同一个含义只留一个父节点)
属性值与目录同名 → 并进目录节点
属性值包含目录名 → 按最长子串并进目录节点
# 只对部门 / 人员 / 来源 / 类型生效,关键字与时间不参与,避免误合
## 4. 连线(文件与文件之间不连线)
目录 父目录→子目录(虚线)、末级目录→文件(实线) 浅蓝
同部门 浅青 同人员 浅紫
同时间 浅绿 同关键字 浅黄
## 5. 渲染页面
搜索:名称 / 关键字 / 主要内容 / 属性 / 主节点名,命中高亮其余压暗
图例:文件(按分类)/ 主节点(按类别)/ 连线类型,单击独显
右键:只看这一支(保留全部上级与下级)、查看详情、打开文件
面板:材料类型 / 来源部门 / 相关人员 / 材料时间 / 原文目录
打开文件 · 打开所在文件夹 · 复制路径 · 复制 WorkBuddy 口令
## 6. 与索引联动(硬性,不能跳)
python skills\_shared\scripts\sync_graphs.py
# 比对索引与 HTML 的修改时间,过期才重出,没过期直接跳过 |
▲政策知识图谱操作
▲材料知识图谱操作
06 按关键字做材料整合
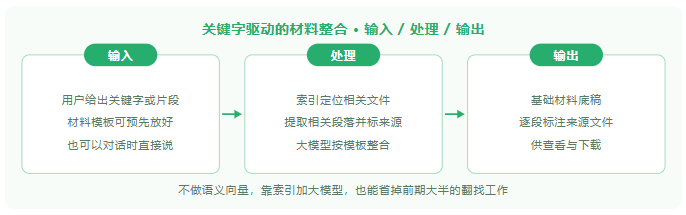
材料整理、编写是个大课题,在不借助语义理解、向量映射的情况下,只通过 WorkBuddy 等基础工具,能做的还比较有限; 初期主要是围绕关键信息提取和整合,按用户的材料模板给个底稿 ,但也能省掉很多精力了。
这里也是依靠前期的索引文件,可以方便地定位、提取相关内容,最后依靠大模型的能力完成内容整合,并输出材料。
▲ 关键字驱动的材料整合
material-compose 这个 Skill 实现的就是上面这条链路:用户说一句“把储能相关的表述整合成一篇汇报”,它先按关键字和主要内容在材料索引里定位到相关文件,必要时打开源文件把相关段落抽出来并标好来源,再以公文模板为母版复制一份填进去,最后落到材料输出目录下。
用得最多的场景是对上汇报、专题材料和会议发言稿的起草——它给的是底稿不是终稿,真正的观点和口径还得人来把关。
| ●●●material-compose / SKILL.md | # 材料整合
description: 按关键字找片段、按公文模板拼底稿,输出 Word
## 0. 先读模板(必须先读再写)
E:\XXX\材料\_模板\公文模板.docx
# 找不到就退到用户临时指定的模板;没有模板不许硬写
## 1. 检索
结合 材料信息索引.md 的关键字 + 主要内容定位相关文件
必要时打开源文件,抽取相关段落,逐段标明来源文件名
## 2. 套版式
模板里已有的 标题层级 / 字体 / 字号 / 行距 / 页边距 / 落款位置 → 严格照搬
模板没写的 表格用三线或默认浅线框、表头加粗;列表沿用模板编号
# 不要另起一套跟公文模板冲突的花哨样式
用户指定了章节结构 → 结构听用户的,样式仍跟模板
## 3. 生成
复制模板再填,不要在原模板上改
材料\_输出\{日期}-{主题}底稿.docx
文首或文末注明「底稿,请核对原文」
## 4. 交付
底稿完整路径(可打开、可复制)
引用列表:每一段来自哪几份材料
说明:已按公文模板排版,表格等未规定样式用了默认 |
07 完整的Skill清单
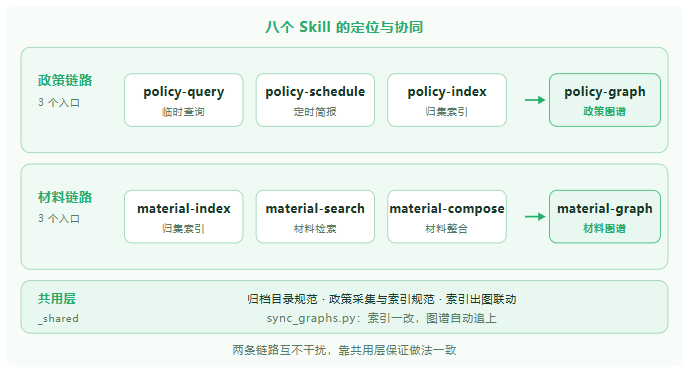
整套下来一共八个 Skill,分成政策、材料两条链路。每条链路都是“若干个入口 + 一个图谱”的结构:入口负责把文件收进来、把信息提出来,写进同一份索引,图谱负责把索引里的关系画出来,供用户二次检索和追溯。
| Skill |
所属链路 |
主要定位 |
| policy-query |
政策 |
临时查政策。先翻本地政策索引,本地没有再上网采,界面直接出工作简报 |
| policy-schedule |
政策 |
定时扫描。每日 / 每周自动跑,产出可下载的政策简报并落盘存档 |
| policy-index |
政策 |
外部政策归集与索引。按国家部委 / 地方政府 / 行业协会 / 门户网站归档 |
| policy-graph |
政策 |
政策知识图谱。把政策索引渲染成主子节点网络 |
| material-index |
材料 |
材料归集与索引。扫投递箱,按五类归档并更新材料信息索引 |
| material-search |
材料 |
材料检索。结合关键字与主要内容匹配,不只看文件名 |
| material-compose |
材料 |
材料整合。按模板拼装段落,输出 Word 底稿 |
| material-graph |
材料 |
材料知识图谱。把材料索引渲染成主子节点网络 |
▲ 八个 Skill 的定位与协同
在 WorkBuddy 里用这些技能,不需要记命令。 把 Skill 目录授权给 WorkBuddy 之后,直接用大白话说就行:说“更新材料索引”会走 material-index,说“找一下关于 XX 的讲话”会走 material-search,说“看材料图谱”会走 material-graph,定时任务则由 WorkBuddy 按配置自动触发 policy-schedule。业务人员这一侧,感受到的就是一句话对应一件事。
08 重新认识WorkBuddy
折腾完上面的内容,对 WorkBuddy 多少经历了一点从“嫌弃”到“真香”的过程,它在界面交互、会话与记忆、大模型调用、操作权限等方面,肯定是比基于 Web 的智能体要友好很多的, 尤其是它对 Skill 的“松散”引用 ,给了设计人员很大的自由度。 对于缩短新应用的验证周期,以及提升用户交互效率,都有很大促进。
有一点要解释下,这里说的重新认识,并不是站在终端用户视角,而是作为一个智能体设计人员的角度,尝试不带色彩地理解一下。
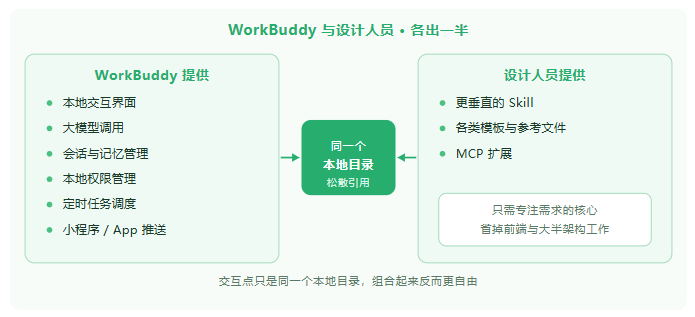
▲ 平台出基建、设计者出垂直能力,交互点是共同的本地目录
WorkBuddy对我的作用
首先,肯定是对它本身通用智能体能力的使用。我也是一个 WorkBuddy 应用的直接使用者,以后遇到问题,总比我一个个地自己码智能体快。
其次是从设计者的角度,WorkBuddy 能为我的智能体架构提供几样东西:本地交互界面、大模型、记忆管理、本地权限管理、定时任务调度、小程序 / App 交互;我要做的东西:更垂直的 Skill、各类模板及参考文件、MCP; 我和它的交互也是松散的, 只是在同一个本地文件目录即可 ,这样结合起来就能发挥出意想不到的作用。
一点要说明
上面的结构考虑,只是围绕 MVP 验证、本地应用的场景出发。要完整跑起来,需要用户自己配 Token,以及本地的目录及权限等。这些跟基于后端及 Web 形式的智能体还不是一个概念。如果想要基于团队和公共场景开展业务,纯自定义搭建的智能体就必不可少。
| 
 学习助手




 订阅