| 编辑推荐: |
文章讲解本体检索增强(OAG):把领域概念、定义、关系由人登记成本体,生成前先做确定性检索——术语归一、条目定位、口径消歧、关系遍历,让模型只基于查证到的事实输出,把“事实必须准确”从模型记忆负担变为可注册、可审计的工程能力;并给出五阶段检索流程、完整走读案例、效果优化方法与 RAG 场景对比。希望对你的学习有帮助。
本文来自于微信公众号噪声之下,由火龙果软件Alice编辑推荐。 |
|
Text2SQL 出错,几乎都出在「模型不知道或记错了业务事实」。OAG 把「查事实」做成检索:先到本体登记册逐项查证,再让模型写纯业务语义稿,最后交给零模型的翻译引擎编译 SQL。一句话:模型说对话,引擎做对事。
SQL 没报错,但数错了 23%
数据分析师小李在取数工具里问了一句:
"上个月各城市的 xxGMV 是多少?"
工具返回了 SQL,跑得飞快,数字看着也合理。小李直接把结果贴进了周报。
三天后的经营会上,财务报的数比他低了 23%。
复盘才发现:模型生成的 SQL 把订单表和支付表 JOIN 在了一起——一笔订单拆成三笔支付,订单金额被算了三遍。
这条 SQL 语法完全正确,执行没有任何报错,结果也落在合理区间。它唯一的错,是 JOIN 了一个不该那么 JOIN 的表。
而"订单与支付是一对多"这件事,从来没有人正式告诉过模型。
这就是 Text2SQL 最难防的一类错:它不报错,只是静悄悄地错。
- 传统 Text2SQL:选表靠RAG检索,JOIN 靠模型猜。猜错了,SQL 照样能跑,错在数字里。
- RAG:把表结构、口径文档切成碎片喂给模型,让它自己"看着办"。但"召回到了这条知识"和"写 JOIN 时真的用上了这条知识",中间还隔着一次模型的自由发挥。
1. OAG 是什么
一句话定义:OAG(Ontology-Augmented Generation,本体检索增强)——在让模型生成任何查询之前,先让模型到"本体(Ontology,即业务知识登记册)"上把每个词、每条口径、每条通路查清楚、确认过,再基于查证结果写查询语义。检索增强的是模型的理解,执行仍然交给规则。
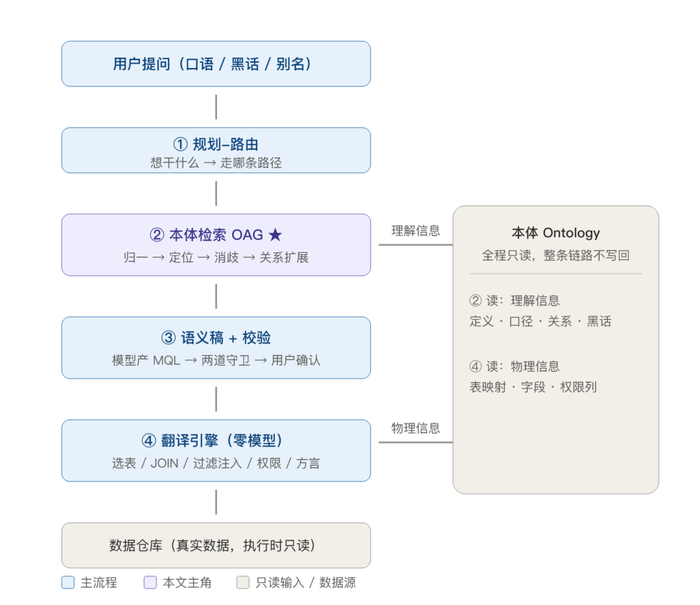
它在系统里的位置
数据流关系:本体是第 ②④ 步的只读输入(② 读"理解信息",④ 读"物理信息"),整条链路不写回本体;数据仓库只被 ④ 产出的 SQL 在最后一步执行时读取——它既不是本体的上游,也不是 ①~④ 的输出。
拆开看三个关键词
| 词 |
含义 |
与"普通让模型直接写 SQL"的区别 |
| 本体 |
检索什么:一份人工维护、机器可读的业务知识登记册 |
不是临时翻文档,而是查官方登记册 |
| 检索 |
怎么查:黑话词典替换 + 注册表精确命中 + 关系图遍历 |
不是向量相似度召回,是确定性的"点查 + 走图" |
| 增强 |
增强谁:模型的理解(让模型"说对话") |
模型负责听懂和写语义稿,但不负责编 SQL、猜 JOIN、记口径 |
为什么需要它,一句话
Text2SQL 出错几乎都出在"模型不知道或记错了业务事实"——GMV 到底按哪个口径、退款能不能按支付渠道拆、过滤要不要加 is_valid=1。这些事实必须有人登记、必须被查到,而不能靠模型记忆或"相似文本"推测。OAG 就是把"查事实"这一步显式化、可审计化。
这一章先解决"是什么"的问题,下面两章先速览本体(被查的对象),再展开检索(怎么查)。
2. 被检索的对象:本体长什么样
本体是按「对象 → 指标 → 关系」三层组织的语义结构(设计方法见作者之前的文章,本文只给检索视角的速览)。
2.1 三层语义 + 一张语义图
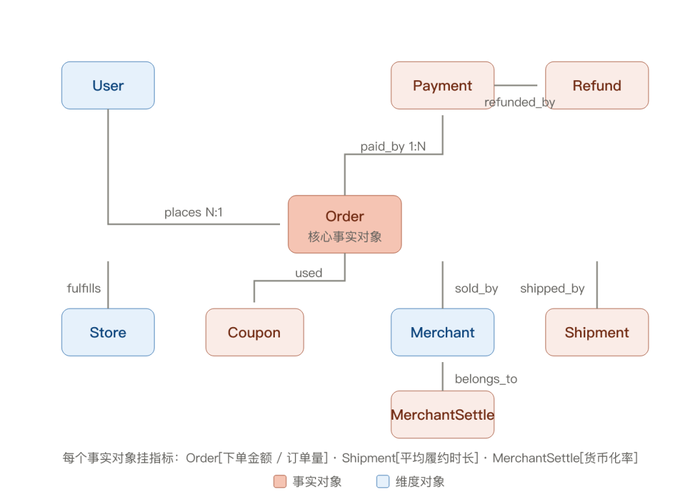
对象(节点):事实对象记录"发生了什么"(Order 订单、Payment 支付、Refund 退款、Coupon 领券记录、Shipment 发货、MerchantSettle 商家结算);维度对象描述"属性是什么"(User 用户、Merchant 商家、Store 门店、Product 商品、CouponMeta 券模板、Region 地域)。
指标(挂在对象上的度量):下单金额、支付笔数、补贴率、货币化率、平均履约时长……只挂在事实对象上,指标间允许复合。
关系(边):对象之间"用什么键、什么语义、几对几"地连接,是 SQL JOIN 的唯一合法来源。
每个事实对象挂指标:Order[下单金额 / 订单量]、Shipment[平均履约时长]、MerchantSettle[货币化率]。
关键:事实对象之间也建关系(Order→Payment、Payment→Refund、Order→Shipment)。否则"补贴率/货币化率"这类跨域指标只能手写 SQL。
2.2 一个对象由四层信息构成
| 层 |
回答的问题 |
检索视角 |
| ① 基本信息 |
是谁:name/display_name/description/domain/object_type/aliases |
被检索的主体:description 写清业务边界(如 Order="从下单到支付完成,不含退款售后"),aliases 供黑话命中 |
| ② 属性信息 |
有哪些业务字段:类型/单位/含义/是否必过滤/枚举值/引用哪个维度 |
维度、过滤条件的候选来源;字段名是业务名,物理列名在 ④ 里映射 |
| ③ 治理信息 |
谁负责、什么状态、有无版本:status/data_owner/security_level/versions/tags |
检索的过滤谓词:只看 active,deprecated 自动跳过;多版本无默认则反问 |
| ④ 数据源信息 |
数据落在哪张表、业务字段对应哪个物理列:
source_tables(...) |
检索不暴露给模型,翻译引擎专用——物理名不能渗入语义稿 |
指标同理,挂口径与治理相关字段:formula + owner + required_filters 是"铁三角",外加 family/variant_label/default_of_family(指标族)、do_not(反面口径)、supported_dimensions/granularities(维度粒度白名单)、composite_of(复合指标子指标)。
2.3 指标族:同名多口径的官方解法(检索消歧的关键)
GMV / 交易金额 族:
  - order_amount 下单金额: SUM(pay_amount), 过滤 is_valid=1     # default_of_family: true
      # 用户只说"GMV/成交额/交易额" → 命中此默认口径
      do_not: 下单金额 ≠ 支付金额; 未支付的订单也算; 不含退款冲减
  - pay_amount 支付金额:   SUM(pay_amt),   过滤 is_valid=1     # default_of_family: false
      # 用户必须明确说"支付金额/实付金额"才命中


交易量 族:
  - order_count 订单量: COUNT(DISTINCT order_id)   # default
  - pay_count   支付笔数: COUNT(pay_id)            # 非默认


复合指标(composite_of 声明子指标,不自造公式):
  - 补贴率         = SUM(coupon_amt)      / SUM(pay_amt)
  - 货币化率       = SUM(commission_amt)   / SUM(pay_amt)
- 平均履约时长 = AVG(delivery_duration_hours) |
一个对象怎么设计、四层信息怎么编码,是治理的事;本文我们重点看:检索视角下,这四层哪些会被消费、哪些会被过滤、哪些只给引擎看——记住这张表,下面五阶段就懂了。
3. 准备工作:黑话词典
归一阶段(4.1)动手之前,先看一眼它手里的唯一武器:黑话词典。它由三类条目组成:
对象级:
  订单/下单/买单/交易单 → Order
  用户/买家/会员/客户 → User
  发货/履约/物流单/出库 → Shipment
  poi/店铺 → Store(门店)
指标级:
  成交额/交易额 → GMV 族(默认下单口径)
  实付金额     → pay_amount
枚举值级:
  钻石商家 → merchant_level=diamond
数码/3C → product_type=数码 |
记住这三类后,下面正式进入五阶段。
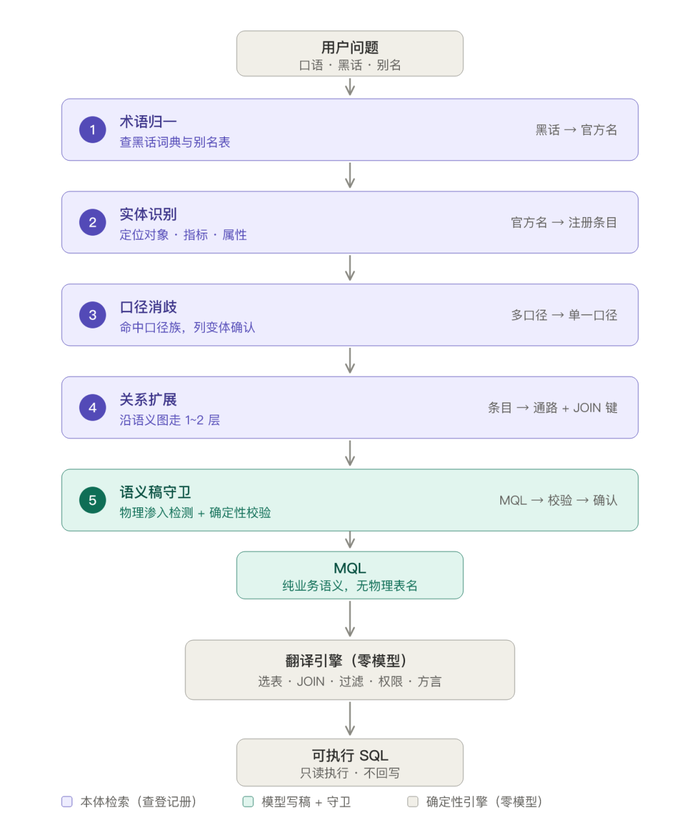
4. OAG 检索过程:五个阶段
4.1 阶段 ① 术语归一
输入:用户原句。
处理:用黑话词典 + 对象/属性别名构成的倒排索引,按词长降序最长匹配(保证"支付成交额"整词命中,不被拆成"支付"+"成交额")。
输出:
输入:  "上个月钻石商家发货最慢的5家, 成交额多少?"
输出:  标准化文本: 上个月 钻石级商家 履约时长 最慢的5家, GMV(默认下单口径) 多少?
       映射表:   [钻石商家→merchant_level=diamond,
发货最慢→履约时长, 成交额→GMV族] |
注意:
- 归一只做内部用,最终回答回译成用户原话(用户说"发货慢"就答"发货/履约慢",不甩内部词);
- 词典没覆盖的新黑话:允许用语义理解对照本体推断,但必须进确认环节,不静默采用;
- 映射目标必须是已注册条目,防止归一出一个查不到的词。
回译的本质是不让 AI 端着黑话跟用户说话——这正是 OAG 比"直接让模型回答"更耐用的产品细节。
4.2 阶段 ② 实体识别
输入:标准化文本。
处理:把候选词逐一与本体条目比对——倒排索以 name/display_name/aliases 为键,命中即返回该条目的一行预格式化描述(精确优先、前缀兜底,不设固定 K,每行都很短)。用户点名业务域(订单/商家/用户…)时按域收敛候选集。
输出:候选条目行(类型 + 标准名 + 一句话定义 + 域 + 状态):
[对象] Merchant(商家, 维度): 商家主体信息, 含等级/入驻时间; 域:mcht; 状态:在用
      属性: merchant_level, merchant_grade, city
[指标] 货币化率: SUM(commission_amt)/SUM(pay_amt); 归属 MerchantSettle; 域:mcht
[属性] merchant_level: 商家等级, 取值 normal/silver/gold/diamond
零命中 → "未命中: xxx → 澄清, 不要编造" |
注意:
- 只接受命中条目的名字,零命中必须澄清,禁止用语义联想补名字;
- 状态感知:deprecated 条目不用于新查询(检索与翻译双层跳过);draft 命中需提示;
- 一词多命中("支付"既是对象也是属性)→ 保留候选列表交给 ③ 或用户;
- 值词不当条目检:华东、钻石、数码是"维度取值",检索只需确认它们归属的属性(region_name / merchant_level / product_type)及其所属对象。
4.3 阶段 ③ 口径消歧
输入:候选指标 + 用户原文。
处理:三级规则——① 精确命中 name/display_name/aliases → 直接返回;② 未命中 → 命中指标族标签 → 取 default_of_family=true 的默认口径;③ 用户只给族名/模糊叫法("GMV 涨了多少")→ 列出全部变体请用户确认。
输出:
输入: "GMV 环比涨了多少"
输出: 命中指标族 GMV/交易金额
  默认: 下单金额 order_amount(SUM(pay_amount), is_valid=1)
  变体: [支付金额 pay_amount: 用户需明确说"支付金额/实付金额"]
→ 请用户确认口径 |
注意:
- 口径族必须让用户确认:口径错了,后面 SQL 再对也是错的(OAG 少数几个必须打断用户的点);
- 量纲感知:从提问词推断量纲("多少单/笔/人"→计数;"多少钱/额"→金额),查"支付笔数"绝不返回金额指标,跨量纲不可替代;
- 复合指标(补贴率/货币化率/履约时长)命中后,读它的子指标与归属对象,确认口径链完整。
4.4 阶段 ④ 关系扩展(OAG 最独特的一步)
输入:已确认的事实对象(如 Order、Shipment)+ 需要的维度/对象集合。处理:沿本体关系图做 BFS 遍历 1~2 层,返回每条边:JOIN 键 + 关系语义(type/cardinality/说明)+ 根对象必要过滤。同一张图在翻译期由引擎算最短 JOIN 路径——模型看到"带语义的路",引擎使用"精确的键",两端共享同一份关系定义。
输出:可达性地图,例如从 Order 出发:
[Order] 用户在平台完成的一次购买行为…
必要过滤: [is_valid=1]
→ Order
→ Order
→ Order
→ Order
→ Order
→ Order |
注意:
- JOIN 键是查到的,不是模型发明的——模型在语义稿里只说"要按商家/按城市拆",怎么 JOIN 由引擎查图决定,模型全程不拼 JOIN 关键词;
- 不可达就是不可达:本体里没有通路(如想从 Shipment 直接按"支付渠道"拆)→ 明确告知无关联路径并给替代建议,不悄悄造 JOIN;
- 深度 ≤2 层是精度/成本平衡;多跳查询用"事实表直连冗余"优化(高频维度键冗余进事实表),把两步路变一步(见第 6 章方法 5);
- 关系语义帮模型判断"业务上合不合理"(Refund 要从 Payment 走 refunded_by 才顺方向),避免模型瞎连。
4.5 阶段 ⑤ 语义稿生成 + 两道守卫
输入:②③④ 收敛的结论(已确认口径的指标、可达维度、必要过滤)。
处理:模型产出业务语义稿 MQL(Metric Query Language,只写要什么),随即过两道守卫:
- 守卫 ① 物理渗入检测:出现任何表名 / 物理字段名(
dwd_*、pay_amt)直接拒绝;
- 守卫 ② 确定性校验:指标必须注册、维度/过滤字段必须是本体属性、操作符/粒度在枚举内、缺时间给默认 t-1 并提示。
输出:通过校验的 MQL + 人类可读的确认单(口径 / 维度 / 过滤 / 时间),确认后翻译引擎才放行(凭证与 MQL 指纹绑定,改了必须重新确认)。
注意:
- 确认环节不可跳过、不可被静默绕过(改 MQL 需重新确认);
- 校验失败:修正重验(限次数)→ 仍失败回理解层澄清,不硬翻译;
- 到这一步检索使命完成:它保证了模型"说对话",翻译引擎负责"做对事"(选表:粒度覆盖 × 维度覆盖 × 预聚合 × 权威 gold>silver,deprecated 跳过;JOIN 来自 ④ 的关系图;权限按用户注入)。
五阶段讲完。怎么知道这套机制真的好用?下面先用它走一遍真实问题,再聊优化。
5. 完整走读:一个跨域复杂例子
业务背景沿用前篇电商语义层:交易线(Order / Payment / Refund)、营销线(Coupon)、商家线(Merchant / Shipment / MerchantSettle / ProductListing),跨域通过事实间关系打通。提问:"上个月钻石级商家的平均履约时长和货币化率分别是多少?发货最慢的 Top 5 商家列一下。"
5.1 五阶段走读
| 阶段 |
输入 |
输出(示意) |
说明 |
| ① 归一 |
原句 |
钻石级商家→merchant_level=diamond;发货最慢→履约时长(desc 排序语义);"上个月"→时间窗口 |
词级与值级黑话都被词典覆盖 |
| ② 识别 |
标准化文本 |
[对象] Merchant(dim)、[对象]Shipment/MerchantSettle(fact);[指标] 平均履约时长=AVG(delivery_duration_hours)、[指标] 货币化率=SUM(commission_amt)/SUM(pay_amt);域=mcht 收敛 |
"货币化率"同时引用商家线结算与交易线支付——跨域复合指标 |
| ③ 消歧 |
候选 + 原句 |
两指标均无指标族冲突 → 精确命中;读 composite_of 确认子指标齐全 |
无 family 场景,直接通过 |
| ④ 扩展 |
Shipment、MerchantSettle + Merchant |
可达:Shipment─shipped_by─▶Merchant、MerchantSettle─belongs_to─▶Merchant;货币化率分母 SUM(pay_amt) 需达 Payment:Merchant─sold_by─▶Order─paid_by─▶Payment(两跳,图可达) |
无此通路则货币化率不可算,会在此步澄清;此处全部可达 |
| ⑤ 语义稿 |
上述结论 |
见 5.2。MQL 通过守卫 → 确认单(含"货币化率跨结算×支付两域计算"提示)→ 用户确认 |
模型只写了业务语义,没写任何表名 |
| 翻译 |
MQL |
见 5.3。引擎编译为可执行 SQL。JOIN 键全部来自关系图 |
零模型 |
5.2 MQL 全文(模型产出,经两道守卫)
{
  "metrics": [
    { "name": "平均履约时长", "agg": "AVG(delivery_duration_hours)", "of": "Shipment" },
    { "name": "货币化率",    "formula": "SUM(commission_amt) / SUM(pay_amt)",
       "of": ["MerchantSettle", "Payment"] }
  ],
  "dimensions": ["merchant"],
  "filters": [
    { "name": "merchant_level", "op": "=", "value": "diamond" }
  ],
  "time_window": { "preset": "last_month", "fallback": "t-1" },
  "sort": [{ "by": "平均履约时长", "order": "desc" }],
  "limit": 5
} |
整段都是业务语义——Shipment 是对象名,merchant_level 是属性名,SUM/AVG 是原子聚合。没有任何物理表名 / 物理列名出现,这是 MQL 能过守卫 ① 的根本原因。
5.3 翻译引擎编译产物(可执行 SQL 骨架)
WITH ship_agg AS (
SELECT s.merchant_id, AVG(s.delivery_duration_hours) AS avg_fulfill_hours
FROM dwd.shipment_di s
JOIN dim.merchant m ON s.merchant_id = m.id
WHERE m.merchant_level = 'diamond'
AND s.is_valid = 1
AND s.dt BETWEEN '2026-08-01' AND '2026-08-31'
GROUP BY s.merchant_id
),
settle_agg AS (
SELECT ms.merchant_id, SUM(ms.commission_amt) AS commission_sum
FROM dwd.merchant_settle_di ms
JOIN dim.merchant m ON ms.merchant_id = m.id
WHERE m.merchant_level = 'diamond'
AND ms.is_valid = 1
AND ms.dt BETWEEN '2026-08-01' AND '2026-08-31'
GROUP BY ms.merchant_id
),
pay_agg AS (
SELECT o.merchant_id, SUM(p.pay_amt) AS pay_sum
FROM dwd.order_di o
JOIN dwd.payment_di p ON o.order_id = p.order_id
JOIN dim.merchant m ON o.merchant_id = m.id
WHERE m.merchant_level = 'diamond'
AND o.is_valid = 1 AND p.is_valid = 1
AND p.dt BETWEEN '2026-08-01' AND '2026-08-31'
GROUP BY o.merchant_id
)
SELECT
sa.merchant_id,
sa.avg_fulfill_hours,
st.commission_sum / py.pay_sum AS monetization_rate
FROM ship_agg sa
LEFT JOIN settle_agg st USING (merchant_id)
LEFT JOIN pay_agg py USING (merchant_id)
ORDER BY avg_fulfill_hours DESC
LIMIT 5; |
30 行 SQL 全由引擎根据第 5.1 节关系图编译而成——模型那一侧只产出了 14 行业务语义。这就是 OAG "让模型说对话,让引擎做对事"的样子。
5.4 这个例子暴露的三个真相
- "货币化率能跨域算"是因为本体注册了 Order→Merchant、Order→Payment 的关系——不是模型"知道"能连;
- "钻石级商家"、"发货最慢"这些口语在检索阶段都被归一/确认过,没有一步靠模型自由发挥;
- 两条指标链(履约、货币化)的合并策略是规则决定的:跨对象时分开聚合再按共同维度对齐,绝不猜一个 JOIN 硬拼。
同样的机制可覆盖另一个跨域问题:"上周领券的用户里有多少下单支付了?补贴率多少?"——Coupon─issued_to─▶User、Order─used─▶Coupon、Order─paid_by─▶Payment 三条关系确定后,补贴率 SUM(coupon_amt)/SUM(pay_amt) 的 JOIN 链自动成立,无需任何手工 SQL。
6. 本体检索的效果优化:评测 → 归因 → 优化
优化的正确姿势不是"想到什么改什么",而是先用评测量化,再按评测结果归因到具体环节,最后只改该环节。本文重点——检索机制侧的优化方法(知识侧与模型侧的处置只作归因落点,暂不展开)。
6.1 先评测:四个检索指标
| 指标 |
测什么 |
取数方式 |
| 澄清率 |
一轮问答里触发"未命中 / 澄清"的比例 |
检索工具返回"未命中 / 请确认"的调用占比 |
| 首位命中率 |
返回的第一候选就是用户要的条目的比例 |
与用户最终确认的口径 / 对象比对 |
| 口径确认率 |
需要打断用户确认口径的查询占比 |
族消歧触发次数 / 总查询数 |
| 一次通过率 |
语义稿一次通过两道守卫并翻译成功的比例 |
校验 / 翻译失败率反推 |
端到端再配一组金标准用例(问题 → 期望语义稿 / 期望命中的对象路径 / 期望结果表,含"必须被拒"的负例)做回归。下面是两个示例:
正例:
  问题: "上月华南数码类目的 GMV,环比涨了多少?"
  期望: 命中 [对象] Region(north=华南 type=数码), [指标] GMV(默认下单口径)
  期望路径: Order JOIN Region(Order.region_id=Region.id)
  期望不放行: 不允许命中 [指标] pay_amount(必须明确说"支付金额"才能命中)


负例:
  问题: "按渠道拆一下上个月的退款金额"
  期望失败点: 关系图 [Refund]--渠道--[?] 无注册路径
期望反馈: "Refund 与支付渠道未登记关系,无法直连;建议先用 Payment 走 refunded_by 再带 channel" |
6.2 归因:指标异常 → 问题出在哪一侧
| 评测信号 |
直接归因 |
处置侧 |
| 澄清率 ↑ |
黑话词典缺口 / 召回太窄 / 域路由误收敛 |
知识侧补词为主 + 机制侧 ① 召回增强 |
| 首位命中率 ↓ |
命中排序差 / 别名冲突 / 废弃条目未过滤 |
机制侧 ② 排序、③ 过滤 为主 |
| 口径确认率 ↑ |
指标族默认值不当 / 口径词表不准 |
知识侧族治理 + 机制侧 ④ 消歧规则 |
| 一次通过率 ↓ |
维度不可达(关系图缺口)/ 粒度不支持 / 语义稿引用未注册名 |
机制侧 ⑤ 图、⑥ 上下文、⑦ 失败机制 + 知识侧补关系 |
| 金标准端到端错 |
口径错误 / 必要过滤漏注入 |
知识侧口径治理(do_not、required_filters) |
这张表是全文最有价值的"思维工具"——指标异常先看表定位到侧,再动手。归因到知识侧就去补本体(词典 / 关系 / 口径),归因到机制侧就用 6.3 的方法,不要两头乱改。建议把它截图存为日常 checklist。
6.3 检索机制侧的优化方法总结(8 条)
按检索环节逐项给方法,每条标注"影响哪个指标":
1. 召回机制:召回宽、确认严——给倒排索引加中文分词兜底(整句任一 token 命中即召回)、同音/繁简归一、同义词组展开,让"查不到"尽量少发生;但进语义稿的名字必须回注册表精确确认,召回放宽不意味着允许近似入稿。→ 降澄清率。
2. 排序机制:治理字段加权打分——同词多命中时按 active > draft、gold 标 > silver、带"核心/监管"标签优先、族默认口径优先排序,而不是按字典序。→ 升首位命中率。
3. 过滤机制:状态与域过滤前置——deprecated 条目在检索时就排除(别等翻译期才发现);域路由词表随业务维护("订单/商家/用户"等域指代词),路由错了候选集就错了。→ 降澄清率、升首位命中率。
4. 消歧机制:量纲感知 + 口径词库——"多少单/笔/人"(计数)与"多少钱/额"(金额)的指代词库维护好,跨量纲命中一律降级为候选;口径词("支付/下单/实付")进库,让用户多说半句就能免掉一次确认。→ 降口径确认率、防跨量纲误替。
5. 图机制:让"可达"更可靠、更近——① 事实表直连冗余高频维度键(多跳变一跳,也省 JOIN);② 多路径时按"跳数少、权威高"排序;③ 反向边自动补全(关系只登记一次,检索双向可用);④ 翻译报"不可达/无表覆盖"时,错误信息要能反查到缺的是哪条关系,直接指给知识侧补注册。→ 升一次通过率。
6. 上下文机制:检索行精简 + 按需精读——检索行固定为"类型/标准名/一句话定义/域/状态/公式摘要",长度封顶;模型需要完整定义时再点查全文,不让大段定义常驻上下文。→ 升一次通过率(信噪比)、降 token 成本。
7. 失败机制:让失败可操作——零命中返回"原因 + 同量纲候选 + 补词建议";不可达组合返回"缺失关系提示 + 替代路径";口径歧义返回"默认 + 变体差异表"。失败信息本身就是下一轮归因与补本体的输入。→ 澄清轮次变少、归因成本下降。
8. 评测机制自身的打磨——金标准用例覆盖到检索阶段(不只看端到端结果):记录每个用例"期望命中的对象/指标/路径",这样澄清率、首位命中率才有可算的分子分母;负例(物理渗入、未注册指标、跨量纲替代)随词典/本体更新同步补。→ 让 6.1 的指标可归因、可回归。
一句话总结本节:机制侧优化的每一条都以"让某个评测指标变好"为目标,且都通过归因表与知识侧分工——归因到词典缺口/关系缺失时,机制侧能做的只是兜底与提示,根治仍靠本体治理(增量注册闭环:新词 / 新关系 → 入库 → 回归)。
7. 与 RAG 的场景对比
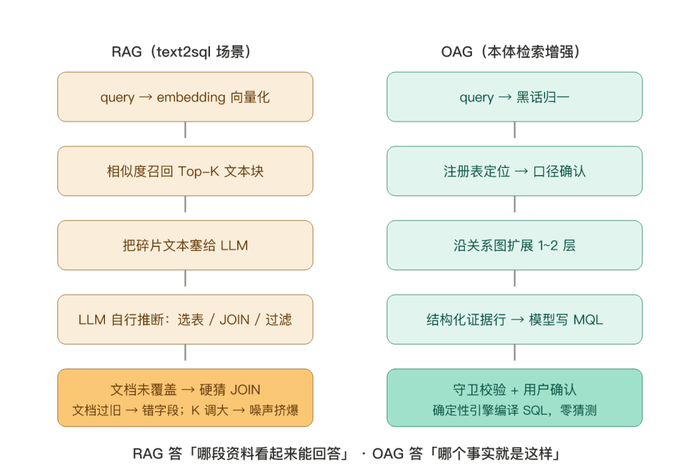
先声明:RAG 本身是成熟的通用方案,本文只说在 text2sql / 精确取数这个具体场景里它不合适——因为它回答的是"哪段资料看起来能回答",而取数要的是"哪个事实就是这样"。
7.1 两条链路对照
7.2 核心差异
| 维度 |
RAG(text2sql 变体) |
OAG |
| 召回单元 |
文本块(chunk) |
注册条目 + 关系边 |
| 匹配机制 |
向量相似度(统计、模糊) |
词典替换 + 精确/前缀命中 + 图上遍历(符号、确定) |
| 同词多口径 |
文档各说各话,模型难裁决 |
指标族 + 默认口径 + 变体确认 |
| 多表 JOIN |
模型在碎片里推断(幻觉高发) |
关系图给 JOIN 键,引擎拼装,零猜测 |
| 必要过滤 |
模型"记得住"才不错 |
随定义锁定、自动注入,不可能忘 |
| 召回数量 |
Top-K 固定截断 |
按相关度排序召回,不设固定 K(上限可配) |
| 失败行为 |
召不到就召"相近的",常自信地错 |
查不到就澄清/拒绝,干净地失败 |
| 动态更新 |
向量索引重建成本高 |
本体在线编辑 + 热刷新,新知识秒级生效 |
7.3 边界与混合
| 场景 |
推荐 |
原因 |
| 问业务指标、要精确数字、口径要对、要能审计 |
OAG |
要的是确定事实,不是相似文本 |
| FAQ、帮助文档、政策、开放域问答 |
RAG |
没有登记册,语义相似是合理近似 |
| 本体治理未起步的冷启动期 |
先用 RAG 顶着 |
过渡方案,不是终态 |
| 成熟形态 |
混合:结构化事实走 OAG,自由文本(FAQ / 口径变更日志)走 RAG |
各归其位 |
7.4 什么时候不要硬上 OAG
- 查询量很小(团队 5 人内、每天 <50 个数据请求)→ 老老实实维护视图 + 写好的 SQL 模板,性价比更高;
- 业务只查单一指标、固定口径(如只查 GMV 一种)→ 一张 dwd 加一个物化视图足以;
- 本体治理人力不足(无 Owner、无变更流程)→ OAG 一旦本体过时就比 RAG 更危险,建议暂不上;
- 数据源是高自由度的日志/文本(如用户评论、客服会话)→ 本体建不起,仍是 RAG 主场。
一个澄清:OAG 不等于 GraphRAG——GraphRAG 把文档建图做"社区级总结",仍是总结式生成;OAG 的图是治理出来的业务关系,下游是确定性引擎编译 SQL。OAG 也不等于不用模型——模型仍负责听懂口语、写语义稿、澄清兜底;只是不再负责编 SQL、猜 JOIN、记口径。
8. 结语
OAG 是什么:让模型在写查询前,先到本体上把"词 → 概念 → 口径 → 通路"逐项查证确认,再基于查证结果产出纯业务语义稿;执行交给零模型的翻译引擎。
检索过程的本质:五步 = 归一(说人话→官方名)→ 识别(官方名→注册条目)→ 消歧(多口径→确认单一口径)→ 扩展(条目→可达通路与 JOIN 键)→ 校验(语义稿 → 两道守卫 + 用户确认)。每一步要么查到确定事实,要么干净地停下来澄清。
效果优化的姿势是评测驱动:先建评测(6.1 四个指标 + 金标准)→ 按归因表定位问题侧(6.2)→ 对症处置——机制侧用 6.3 的八条方法,归因到知识侧就补本体(词典 / 关系 / 口径)。
与 RAG 各归其位:要精确事实走 OAG,要开放知识走 RAG,成熟形态
以上只是把过程讲清楚了,具体实现还需要结合工程持续打磨,方能越来越好。
| 
 学习助手




 订阅