| 编辑推荐: |
文章提出并验证了一个可量化、跨领域、与现实世界挂钩的 AI 能力衡量框架,揭示了自主 AI 智能体快速发展的时间线,希望对你的学习有帮助。
本文来自于METR (metr.org),由火龙果软件Alice编辑推荐。 |
|
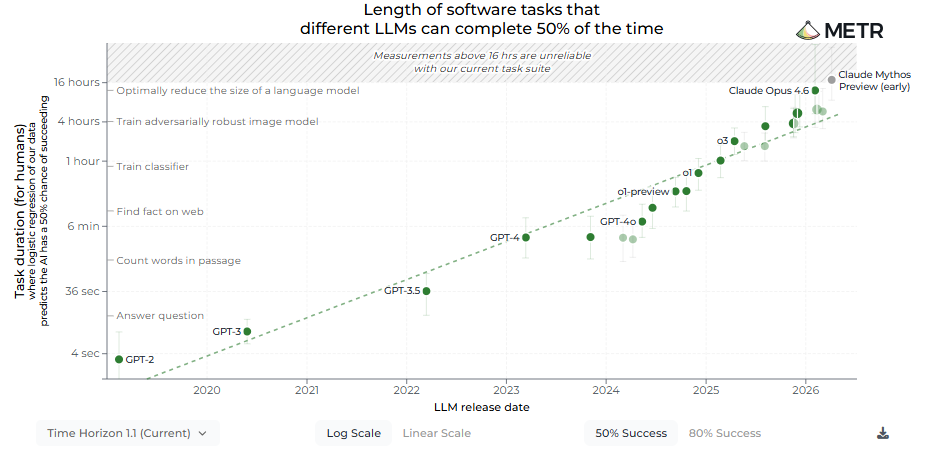
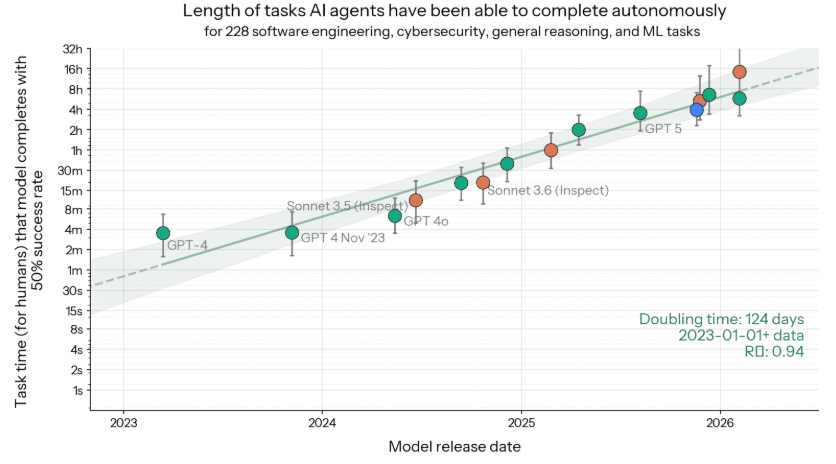
文中的静态图表和某些说法(例如倍增时间)反映的是原文最初发布时的数据状态。下方的交互式图表展示了我们后来的 TH1.1 估算值,我们已不再用新模型更新该数据。
这是我们针对公开语言模型的任务完成时间跨度(TH1.1)测量结果,我们已不再用新模型更新该数据。
摘要
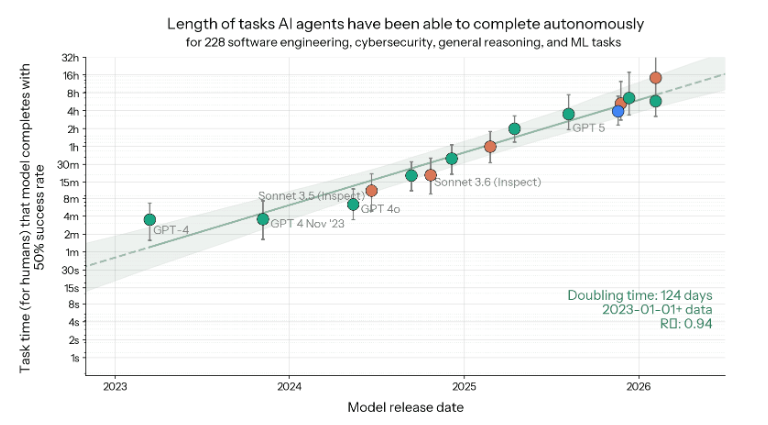
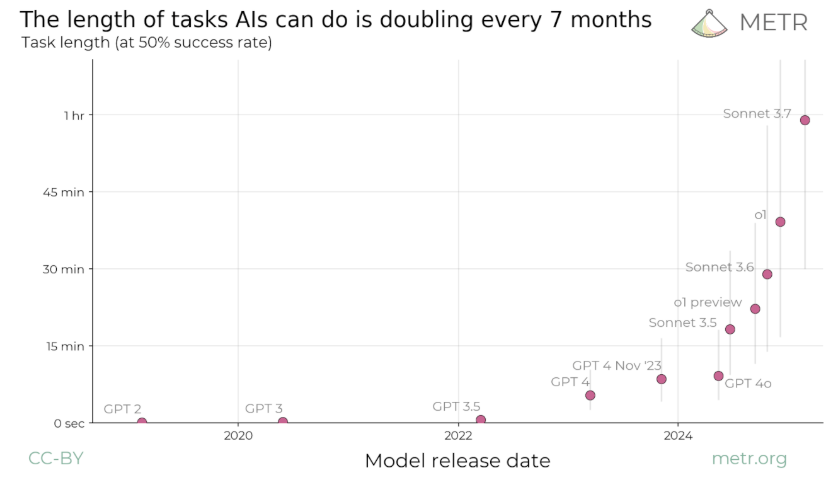
我们提出通过 AI 智能体能够完成的 任务长度 来衡量 AI 性能。研究表明,这一指标在过去 6 年中持续呈指数级增长,倍增时间约为 7 个月。外推这一趋势预测,在不到十年的时间内,我们将看到 AI 智能体能够独立完目前需要人类花费数天或数周才能完成的大部分软件任务。
过去6年中,通才前沿模型智能体能够以50%的可靠性自主完成的任务长度(通过人类专业人员完成这些任务所需的时间来衡量)大约每7个月翻一番。阴影区域表示通过跨任务族、任务和任务尝试的分层自助法计算得出的95%置信区间。
我们认为,预测未来 AI 系统的能力对于理解和准备强大 AI 的影响至关重要。但预测能力趋势非常困难,甚至理解当今模型的能力也可能令人困惑。
当前前沿 AI 在文本预测和知识任务上远超人类。它们以极低的成本在大多数考试类问题上超越专家。经过一些特定任务的适配,它们也可以在许多应用中作为有用的工具。然而,目前最好的 AI 智能体尚不能自主执行实质性项目或直接替代人类劳动力。它们甚至无法可靠处理相对低技能、基于计算机的远程行政助理类工作。显然,从某种意义上说,能力正在迅速提升,但这与现实世界的影响如何对应尚不清楚。
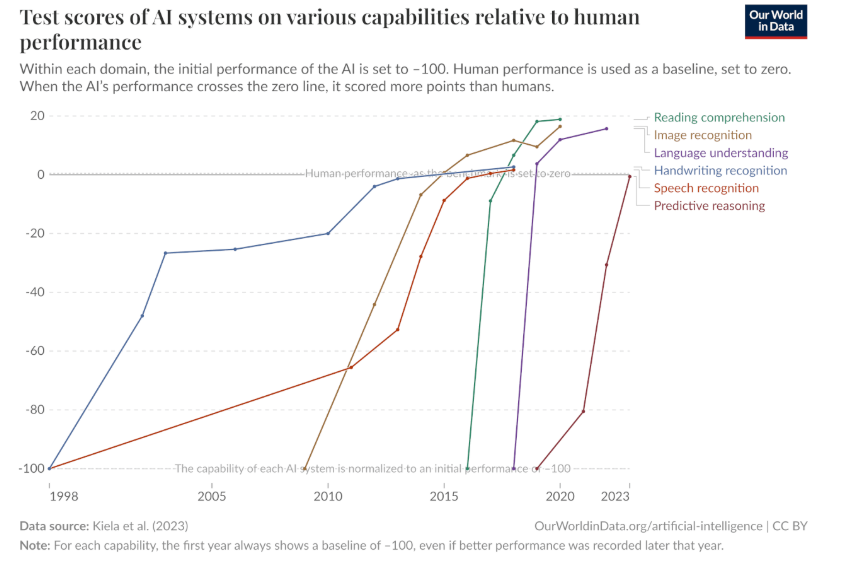
人工智能在多个领域的众多基准测试中表现迅速提升。然而,要将这种性能提升转化为对人工智能现实世界实用性的预测,可能颇具挑战性。
我们发现,衡量模型能够完成的任务长度,是理解当前 AI 能力的一个有用视角。¹ 这是合理的:AI 智能体似乎常常在串联更长动作序列方面遇到困难,而不是缺乏解决单个步骤所需的技能或知识。
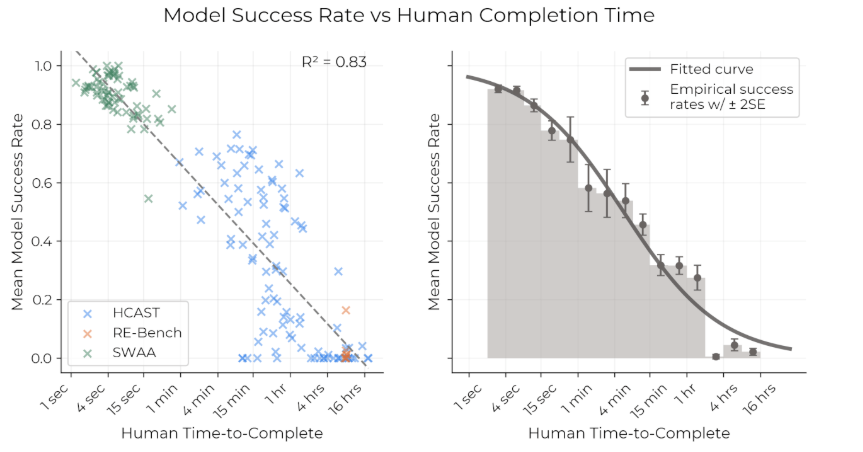
在一组多样化的多步骤软件和推理任务上,我们记录了具备相应专业知识的人类完成任务所需的时间。我们发现,人类专家花费的时间能强烈预测模型在给定任务上的成功率:当前模型在人类耗时少于 4 分钟的任务上成功率接近 100%,但在耗时超过约 4 小时的任务上成功率低于 10%。这使我们能够通过“模型以 x% 概率成功完成的任务的长度(对人类而言)”来描述给定模型的能力。
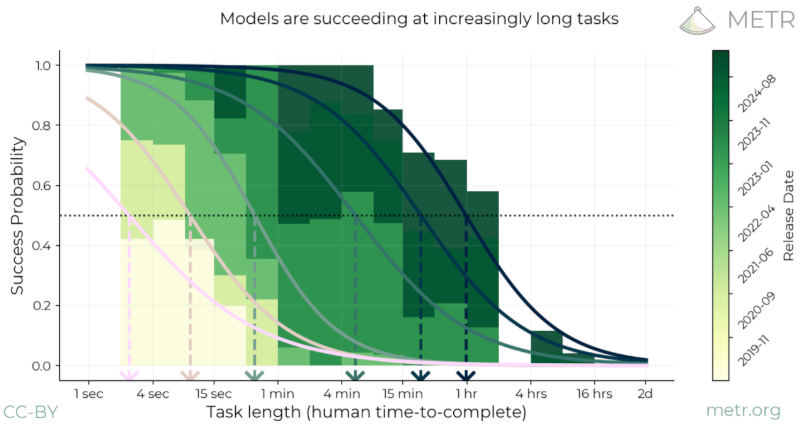
任务时长(time horizon)计算过程示意图。例如,Claude 3.7 Sonnet(最右侧的模型,以最深绿色表示)的任务时长约为 1 小时,因为其拟合的逻辑曲线与 50% 成功概率阈值的交点即位于此处。
对于每个模型,我们可以拟合一条逻辑曲线,利用人类任务时长来预测模型成功率。在固定一个成功概率后,我们就可以通过将每个模型的预测成功曲线与该概率相交处的任务长度转换为持续时间。例如,以下是几个模型的拟合成功曲线,以及我们预测成功率为 50% 的任务长度:
我们认为,这些结果有助于解决在许多基准上超人表现与常见经验观察(即模型似乎不能稳健地帮助自动化人们日常工作)之间的明显矛盾:目前最好的模型——如 Claude 3.7 Sonnet——能够完成一些即使人类专家也需要数小时的任务,但只能可靠地完成几分钟长的任务。
尽管如此,通过查看历史数据,我们发现最先进模型能够完成的任务长度(50% 概率下)在过去 6 年中急剧增加。
如果我们在对数尺度上绘制,可以看到模型能完成的任务长度很好地符合指数趋势,倍增时间约为 7 个月。
我们对智能体能够完成的任务长度的估计取决于方法选择,例如所使用的任务和测量性能的人类。然而,我们相当确信整体趋势大致正确,每年约有 1-4 次倍增。如果过去 6 年测量的趋势再持续 2-4 年,通才自主智能体将能够执行广泛的、长达一周的任务。
这一趋势的陡峭性意味着,即使测量存在较大误差,或模型与人类比较存在较大偏差,我们对不同能力何时到来的预测也相对稳健。例如,如果绝对测量偏差达到 10 倍,到达时间也仅改变约 2 年。
我们在 完整论文 中讨论了结果的局限性,并详细进行了各种稳健性检查和敏感性分析。简而言之,我们表明类似趋势在以下方面也成立(尽管噪声更大):
- 我们任务的各个子集可能代表不同的分布(非常短的软件任务对应多样化的HCAST和RE-Bench,以及按长度或定性评估“混乱度”筛选的子集)。
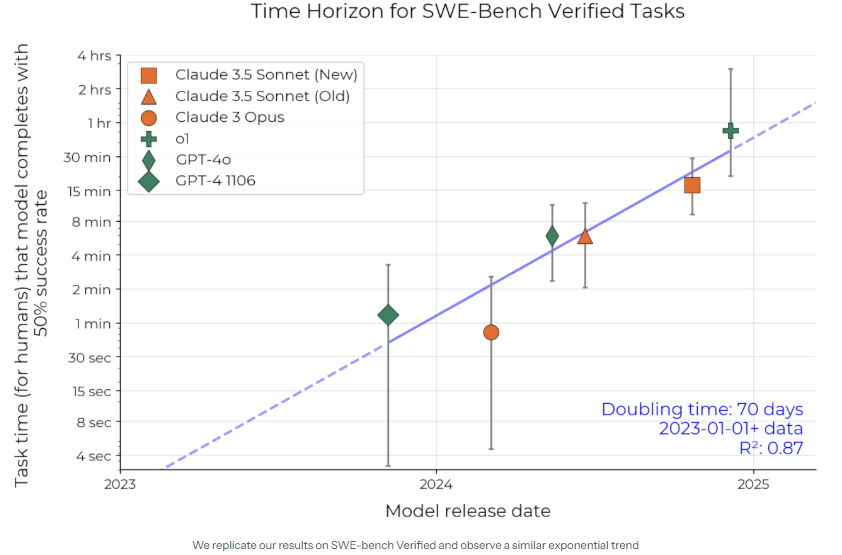
- 一个基于真实任务的独立数据集(SWE-Bench Verified),独立收集基于估计而非基线的人类时间数据。这显示翻倍时间更快,不到3个月。 [2]
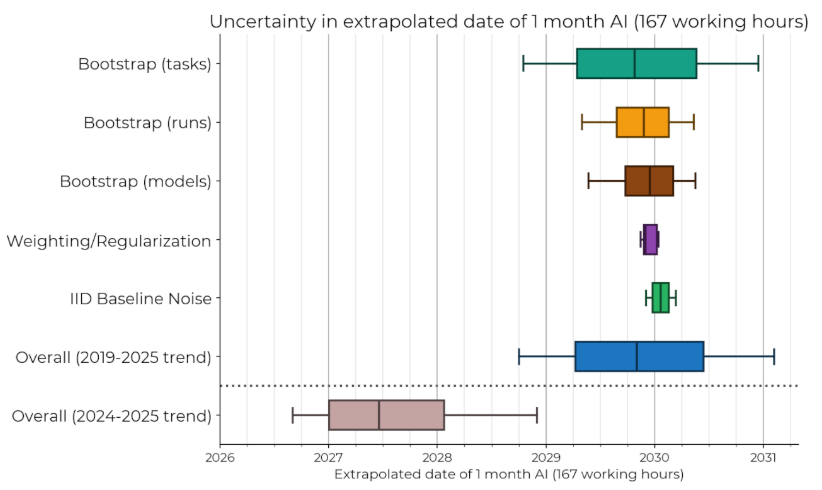
我们在论文中还表明,我们的结果似乎对我们包含的任务或模型,以及我们调查的其他方法论选择或噪声来源并不特别敏感:
这是对前沿 AI 系统达到 1 个月任务时长(horizon)的推断日期进行的敏感性分析。在每一行中,我们对数据施加了 10,000 次随机扰动,并根据扰动后的数据得出 1 个月 AI 时长的推断日期分布。箱线图的端点代表第 25 和第 75 百分位数,须线代表第 10 和第 90 百分位数,不显示离群值。请注意,该图未考虑未来趋势变化或外部有效性问题,而这些因素是我们不确定性的主要来源。
然而,仍存在显著模型误差的可能性。例如,有理由认为近期 AI 趋势比 2024 年之前的趋势更能预测未来表现。如上所示,当我们仅对 2024 和 2025 年的数据拟合类似趋势时,AI 能够以 50% 可靠性完成长达一个月任务的估计时间缩短了约 2.5 年。
结论
我们认为这项工作对人工智能基准、预测和风险管理具有重要意义。
首先,我们的工作展示了一种让基准对预测更有用的方法:通过系统能完成任务 的长度 来衡量人工智能表现(即人类完成任务所需的时间)。这使我们能够衡量模型在不同能力水平和多领域中的改进情况。 [3] 同时,与现实结果的直接关系允许对绝对表现进行有意义的解释,而不仅仅是相对表现。
其次,我们发现多年来人工智能在一个对现实影响至关重要的指标上呈现出相当强劲的指数级趋势。如果过去六年的趋势持续到本十年末,前沿AI系统将能够自主完成为期一个月的项目。这将带来巨大的利害关系,既有潜在的益处,也有潜在的风险。
| 
 学习助手




 订阅