| 编辑推荐: |
本文主要介绍了谷歌与斯坦福提出的
RRSI 框架——它给智能体 Harness 的"递归自我改进"加上提案侧和选择侧两组正则化(过滤携带题目线索的修改、要求提升超过随机波动才保留),以此解决自动迭代只会在训练任务上刷高分数、换到新任务就失效的过拟合问题,实测在全部分布外测试集上稳定提升(最高
+4.3 分),且 token 消耗还降低约 30%。希望对你的学习有帮助。
本文来自于微信公众号模智空间,由火龙果软件Alice编辑推荐。 |
|
让 AI 检查自己的失败、修改自己的工作方式,再用修改后的系统继续完成任务,这听起来是一条很自然的自进化路线。但这里隐藏着一个问题:如果
AI 始终围绕同一批任务修改自己,它究竟是在学会更通用的工作方法,还是在逐渐熟悉这批任务的考试套路?
来自Google Cloud AI Research、斯坦福等机构的研究者,在论文《RRSI:
Regularized Recursive Self-Improvement of Agent Harnesses》中讨论的,正是这个问题。他们提出
RRSI,即智能体 Harness 的正则化递归自我改进,尝试让系统保留下来的变化,更多地对应可复用的能力。
要理解这项研究,首先需要分清:这里的“自我改进”,改的是什么?
一个智能体的表现,既取决于底层模型,也取决于包围模型的整套运行机制(Harness)。模型负责理解与推理,Harness则决定它能看到什么信息、使用哪些工具、怎样处理失败,以及何时结束任务。同一个模型,如果使用不同的
Harness,任务表现可能天差地别。
过去,这套系统基本靠工程师人工调试,看智能体失败的执行记录,手动修改提示词、调整工具逻辑,耗时耗力。于是学术界开始探索自动化方案:让大模型自己迭代修改这套配套系统,实现递归自我改进(RSI,Recursive
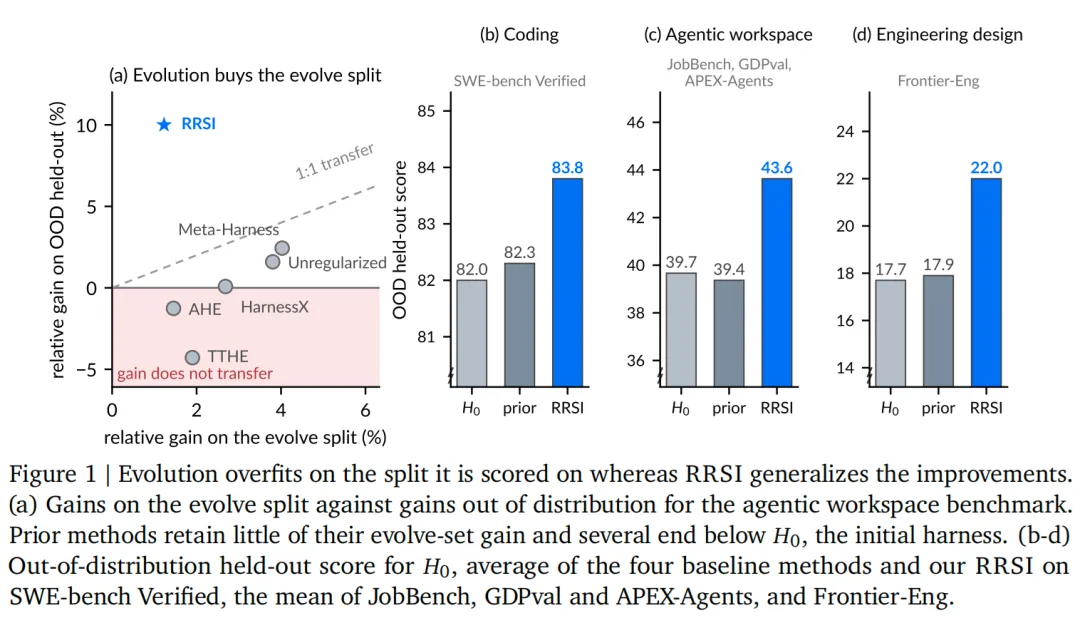
Self-Improvement)。但这里出现了一个棘手的问题:自我迭代出来的智能体,很容易出现过拟合,在训练用的任务集上分数暴涨,换到没见过的新任务上,提升直接消失,甚至性能反而下降。
一、自我迭代的陷阱:分数好看,换题就垮
传统的 Harness 自动进化,通常沿着这样一个循环运行:让当前系统执行一批任务,分析失败轨迹,提出若干修改方案,在同一批任务上测试,再保留得分最高的方案。
论文把这批反复提供反馈的任务称为进化集(evolve set)。
它的作用很像练习题。但与普通练习不同的是,系统会依据每一轮成绩,调整下一轮的修改方向。今天发现某类任务需要更多引用,便增加引用要求;明天发现某种文件格式更容易得高分,便增加格式规则。久而久之,这批练习题的信息就会不断进入系统的工作方式。
这套流程会带来一个隐患:智能体Harness不是学到了普适的解决问题的能力,而是记住了这套练习题的套路、评分规则,甚至拟合了评估过程里的随机噪声。就像学生死记硬背练习题答案,考试遇到全新题目就手足无措。
造成这种过拟合主要有三类根源:
- 基准特定过拟合:迭代出来的修改专门适配训练集任务、评分规则,换一套任务就失效;
- 追逐评估噪声:评估本身存在随机性,算法把偶然的高分当成有效改进保留下来;
- 无节制堆积复杂度:不断增加提示词、逻辑模块,消耗更多token,只是提升训练集分数,并没有产生通用解决问题的机制。
传统的递归自我改进,只盯着迭代集上的分数,没有约束上面这三类问题。RRSI的核心思路,就是把机器学习里“正则化”的思想引入Harness迭代。这里的“正则化”,可以理解为给优化过程增加一些规则,防止它过度迎合有限的数据。研究人员并没有规定只能改提示词,或者禁止增加工具、记忆和子智能体,可修改的范围仍然开放。
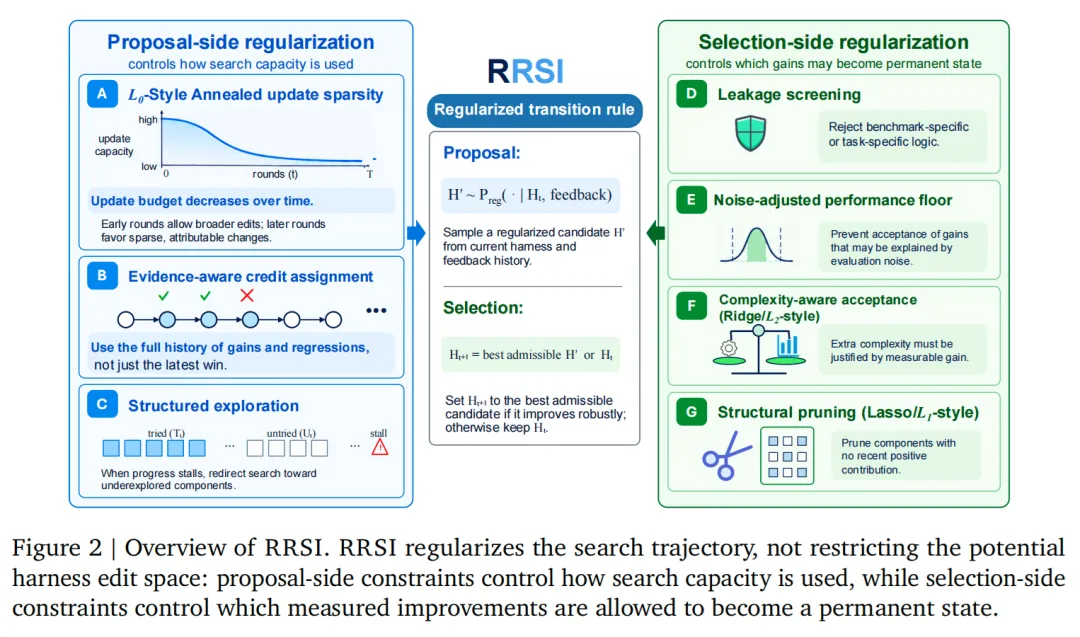
约束主要落在两个环节:一是怎样提出修改,二是怎样决定哪些修改留下来,也就是候选方案生成(Proposal,提案侧)、候选方案筛选保留(Selection,选择侧),RRSI分别对两边施加正则约束。
二、提案侧:约束生成
退火式更新稀疏性:一轮别改太多
无约束的生成,会把一大堆互不相关的修改打包放进同一个候选版本。一堆改动混在一起,就算分数涨了,也分不清到底哪一条改动真正起作用。
RRSI 的做法是:给每轮设置一个编辑预算,限制一个候选能捆绑多少个独立可归因编辑。早期轮次允许组合几个协调变化,去发现新机制;后期越来越稀疏,通常只允许一个编辑,让效果更容易归因。
论文实现中,编辑池大约有 80 个原子编辑,但早期预算只有 3 到
4,后期是 1。这样既保留探索能力,又避免“一锅炖”导致无法判断哪个修改真正有用。
证据感知的信用分配:记住历史踩过的坑
每一次生成修改方案,都会完整记录历史:哪些组件被修改、提出了什么假设、分数和算力开销变化、这个方案有没有被采纳。
后续生成新候选的时候,会参考全部历史记录。已经被实验证伪过的思路,不会反复拿来试错;成功的改动会保留正向参考。随着每轮允许改动变少就更容易定位:到底是哪一处改动带来性能变化,避免反复做无用搜索。
结构化探索:搜索陷入停滞,就去试没碰过的模块
如果连续多轮迭代,分数变化都落在评估噪声范围内,判定为搜索“陷入停滞”。这时,算法会预留一部分修改名额,去改动之前几乎没有碰过的系统组件。
举个例子:如果反复改提示词,却从来没有调整过工具逻辑、记忆模块,停滞的时候就强制把一部分搜索能力投向这些未探索区域,避免迭代困在局部小范围反复打转。
三、选择侧:严格把关
标准 Harness 进化常选“测量分数最高”的候选,即使这个分数来自泄漏、随机波动或昂贵增长。RRSI的做法是候选必须通过多层校验,才能被保留下来成为下一代系统。这一层就是选择侧正则,防止把过拟合、噪声、高开销的改动固化到系统里。
泄漏筛查:防止小抄进入考场
正式打分之前,先审查改动的具体内容。拒绝直接硬编码训练任务名字、实体、特定答案、只适配迭代基准的特殊逻辑。关键点是:它筛选的是
diff,而不是提案说明。候选可以在解释里提到它想修复哪些任务,但真正进入Harnes的代码不能带这些内容。这样,一个泄漏候选不会先拿到虚高的进化集分数,再吸引后续轮次。
噪声调整性能下限:稳定性校验
在迭代开始之前,先多次运行原始系统,测出评估本身自带的波动范围。
新候选的分数不能比历史最高分低超过这个噪声区间。避免一连串微小、随机的性能退步,被误判成正常迭代,慢慢把系统越改越差。
复杂度感知接纳:性能提升要对得起算力消耗
智能体运行会消耗策略token,很多旧迭代方法,靠疯狂增加上下文长度、堆砌文本,换来迭代集分数上涨,推理成本暴增,但通用能力没有进步。
RRSI设置约束:允许增加算力开销,但开销增长必须和性能提升匹配。性能涨得越多,才允许接受更大的token开销;如果收益很小,就不能随便增加计算负担。
结构化剪枝:没用的组件就要删掉
持续监控各个系统组件的实际收益。如果一个模块在一段观测窗口内,没有带来正向性能收益,就标记为待删除。后续生成候选方案的时候,会主动把这些无效组件移除。
很多迭代出来的智能体会越变越臃肿:很多模块写进去之后,就算没用,也不会被删掉。RRSI主动裁剪持续没有贡献的部分,让最终的配套系统结构更精简。
四、实测效果
论文在三个领域、八个基准上评估 RRSI:
- 编程:Terminal-Bench 2.1 作为进化集;SWE-bench
Verified 作为分布外测试。
- 智能体办公:Harvey LAB 作为进化集,并划分 120
个进化任务和 40 个同分布留出任务;JobBench、GDPval、APEX-Agents 作为分布外测试。
- 工程设计:EngDesign 作为进化集;Frontier-Eng
作为分布外测试。
实验只在某一套数据集上做迭代进化,迭代完成之后,配套系统完全不变,直接拿到另外一批从未见过的数据集上测试泛化能力。
核心实验结果
1. 兼顾迭代集收益与跨任务泛化
RRSI在迭代的数据集最高拿到6.0分提升;更重要的是,所有分布外的测试集全部正向提升,最高提升4.3分。对比其他传统自迭代方案:它们在迭代集分数更高,但是换到陌生任务,提升大幅缩水,部分基线甚至低于初始系统。
RRSI在迭代集上的涨幅不是所有方法里最高的,但却是唯一一套在全部分布外测试稳定获得大幅增益的框架。它牺牲了一点点训练集上的天花板分数,换取通用能力。
2. 效果不绑定特定底层大模型
分别用Claude Opus 4.8、Gemini 3.5 Flash两套完全不同的底座跑迭代。不管用哪个模型迭代,优化出来的配套系统,都可以向未见过的基准迁移。
更进一步:用Gemini3.5 Flash迭代出来的配套系统,可以直接套到能力更弱、迭代过程完全没用到的Gemini3.1
Flash Lite上,依旧可以带来任务性能提升。
3. 算力开销更低
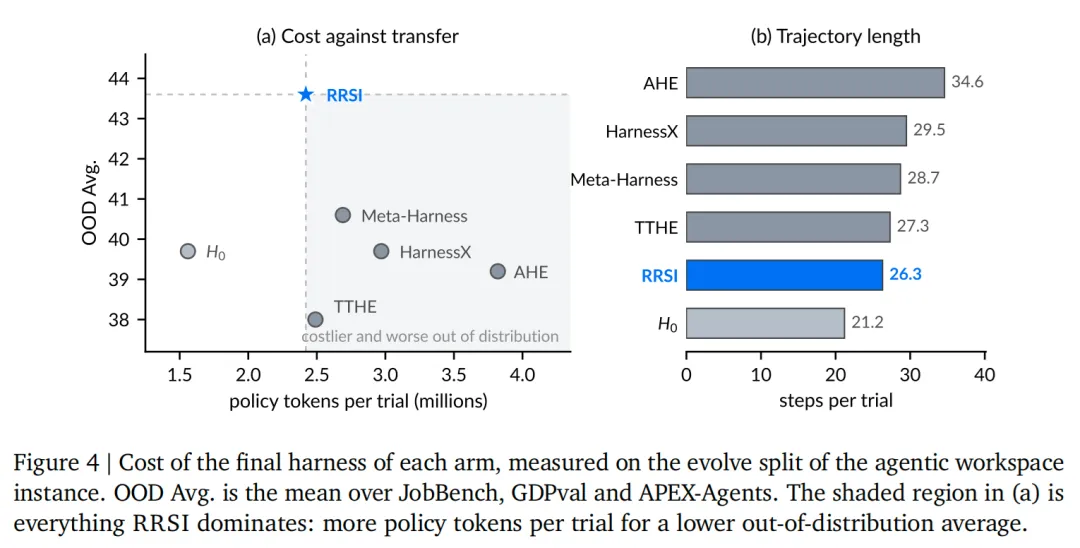
对比其他自迭代方法,RRSI产出的系统,策略token消耗相比无正则化的迭代减少约30%,单任务执行步骤数量也更少。其他基线为了分数,付出了更高推理成本,换来的却是更差的泛化表现。
消融实验也验证了:提案侧、选择侧两组正则都不可或缺。去掉任意一组,迭代集分数会变高,但分布外泛化能力明显下降;全部去掉之后,就是传统过拟合的迭代模式。
五、局限与思考
RRSI也存在明确的边界:
- 只针对底座模型权重冻结,只迭代Harness的场景,不研究模型参数本身更新的自进化;
- 仍旧依赖用于迭代的数据集质量与评估反馈信号效果,也需要设置若干超参数;
- 验证范围有限,还需要在更多样智能体架构、工具生态、更长时间的自我迭代流程中进一步检验。
AI 自动提出修改,并不难成为一个持续运转的流程。更难的是让这个流程积累可靠的工作方法。
RRSI 的贡献,就在于让每一项准备进入系统的变化,都必须面对几个具体问题:它是否携带了题目线索?改善是否超过随机波动?额外开销是否值得?换到新任务是否仍然有效?能够回答这些问题的自进化,才更接近可持续的能力积累。
| 
 学习助手




 订阅