| 编辑推荐: |
本文主要介绍Jev-Mem这一AI智能体记忆系统,它借鉴人脑双系统理论的AI记忆架构,用轻量模型处理记忆管理、大模型专注最终回答,兼顾效果与速度, 希望对你的学习有帮助。
本文来自于模智空间,由火龙果软件Alice编辑推荐。 |
|
现在的AI智能体,需要和人进行长时间、多轮次交互。在漫长对话里,AI要记住你的偏好、历史任务、过去发生的事件。但大模型本身的上下文窗口有限,就算把窗口拉得很长,模型也经常记不住早期信息。
于是, 智能体记忆(Agentic Memory) 技术应运而生,专门负责存储、整理、更新、调取AI过往的经历,相当于给AI外挂一个长期记忆库。
不过现有的记忆系统有一个很头疼的矛盾:要么简单粗暴、速度快但是记性差;要么靠大模型反复推理管理记忆,效果变好,但开销巨大、响应很慢。Jev-Mem这篇论文借鉴人脑认知理论,提出一套全新架构,同时做到记忆效果更好,运行速度大幅提升。(文末附下载)
一、人脑的两套思考系统
心理学里有著名的 双加工理论 :
- 系统一(System One) :快思考。下意识、轻量、高速,做判断、分类、打分,不需要深思熟虑。比如看到危险立刻躲闪,快速分辨好坏。
- 系统二(System Two) :慢思考。费力、严谨、生成完整文字,用来深度推理、综合信息、写最终答案。
目前绝大多数AI记忆系统,把大量本该快速完成的记忆管理工作,全部扔给会生成文本的大模型(相当于全部交给系统二)。
举个例子:当新的对话进来,系统需要判断这条信息属于什么类型?和库里哪条旧记忆有关系?用户提问的时候,该去哪部分记忆搜索?搜到的材料够不够回答问题?要不要继续找更多内容?
这些任务本质是分类、打分、判断关联,不需要写一大段文字。但老方案却要调用大模型生成一大段输出,再解析结果。大模型逐token生成文本,开销高、延迟大,而且这些高频判断处在记忆读写的关键路径上,反复调用会让整个AI智能体变得又慢又贵。
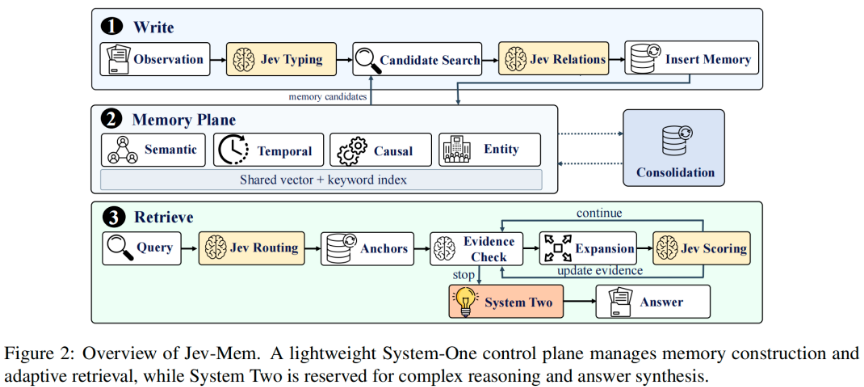
Jev-Mem的核心思想就是把两者拆开:
- 系统一控制器 :专门包揽所有高频、结构化记忆控制工作,只输出标签、分数、概率,不生成长篇文本;
- 记忆平面 :多关系结构化记忆存储,保存所有历史信息;
- 系统二大模型 :只在最后关键时刻出场,拿到筛选完毕的证据,做复杂推理,生成最终回答。
琐碎的记忆管家工作交给“快系统”,深度写答案留给“慢系统大模型”。
二、Jev-Mem整体是怎么工作的
整个流程分为 写入记忆(把新经历存入库) 和 检索记忆(用户提问调取历史) 两大块,全部由系统一主导,系统二只负责收尾输出答案。
1. 写入记忆:把新观察整理存入多关系记忆图
每当产生一条新交互(用户说话、环境反馈),就会进入写流程:
- 记忆类型标注(Jev Typing) 系统一给这条记忆打多维度分数,标记它是事件经历(情景记忆)、通用知识(语义记忆)、操作流程(程序记忆)还是用户偏好。一条记忆可以同时拥有多种标签,不是非此即彼。这里不会直接丢掉任何原始信息,只是打标签。很多旧系统会直接判断这条要不要删掉,容易丢失未来会用到的线索;Jev-Mem保留原始记录,取舍放到后续检索阶段。
- 候选记忆查找(Candidate Search) 不会拿新记忆和库里面几百万条记录全部比对(会越跑越慢)。先用 向量相似度 、关键词、实体重合、时间远近,筛选出一小批最有可能相关的旧记忆作为候选集。
- 关系推断(Jev Relations) 系统一只对筛选出来的候选对做判断:两条记忆之间是否存在语义关联?有没有因果先后?是不是同一个事件?实体是否等价?
它维护四类关系视图:
- 语义:内容话题相关;
- 时间:先后、同时、包含;
- 因果:一件事导致另一件;
- 实体:提到同一个人、事物。
满足分数阈值,就在记忆图中建立对应类型的边。同两条记忆可以同时拥有多种关系。
- 存入记忆库 + 定期整理(Consolidation) 把节点和关系写入共享记忆平面。每隔一段时间,系统一会检查部分记忆,判断是否存在冗余、矛盾、过时信息。 原始记忆永远保留 。合并、抽象提炼这件事不会自动发生;只有系统一给出很高置信度之后,才会调用系统二大模型生成摘要,原始素材不会被覆盖删除。
2. 检索记忆:闭环自适应查找,而不是简单top-k检索
用户提出问题之后,不是直接向量检索返回top-N片段,而是一套闭环迭代的搜索流程:路由→检索锚点→证据评估→图扩展→重新评估,直到满足条件才停止,再把证据交给系统二生成答案。
- 查询路由(Jev Routing) 系统一判断回答这个问题需要用到哪几类关系:是要看时间线?找因果原因?还是实体关联?同时预测需要几跳推理、时间信息有多重要。一个问题可以同时激活多种关系视图,不是只能选一种。
- 分配检索预算 总搜索资源是有限的,按照各个关系视图对当前问题的有用程度,分配搜索算力。重要的关系分配更多遍历次数,不重要的少分配,避免无意义遍历整张大图。同时规定图遍历最大深度。
- 获取搜索锚点(Anchors) 融合向量语义检索+关键词检索,拿到一批高质量的记忆节点,作为图遍历的起点。
- 迭代扩展+打分候选记忆 不断沿着图的边向外扩展,每一条候选记忆,系统一从多个维度打分:
- 和问题的相关性;
- 这条关系对当前查询有没有用;
- 是否带来之前没有见过的新信息;
- 是否可以支撑已经收集到的证据。
同时结合向量相似度、时间远近做加权综合得分,选出高价值候选加入证据集合。
- 自适应停止(Evidence Check) 这是Jev-Mem非常关键的创新,不设置固定迭代轮数,系统一持续评估三件事:
- 当前收集到的证据够不够完整回答问题;
- 是否还有缺失的关键信息;
- 继续再搜一轮,还能不能带来有效信息。
满足下面任意一种情况就停止检索:证据已经足够,缺失信息少,没有矛盾;就算证据不全,继续搜索大概率也找不到有用新材料。
同时设置硬性上限:最大遍历节点数、边数、耗时,防止无限循环。
- 交给系统二生成答案 检索停止后,把筛选完毕的一小部分高质量记忆证据传给大模型(系统二),由大模型综合证据输出回答。
图遍历、找关系、判断要不要继续搜,这些繁重的记忆管理工作,大模型完全不参与。
三、实验结果
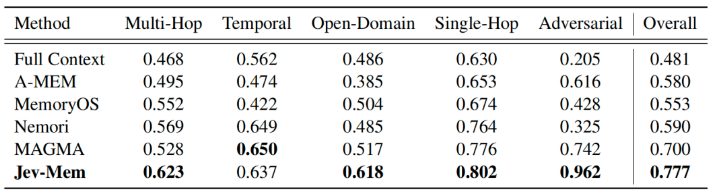
论文在LoCoMo数据集上做测试,LoCoMo专门评估超长多轮会话,考验AI跨会话做时间推理、因果推理、多跳推理的记忆能力。对比了Full-Context、A-MEM、Nemori、MemoryOS、 MAGMA 等主流记忆方案,使用LLM-as-a-Judge打分评估回答质量,同时统计两项效率指标:
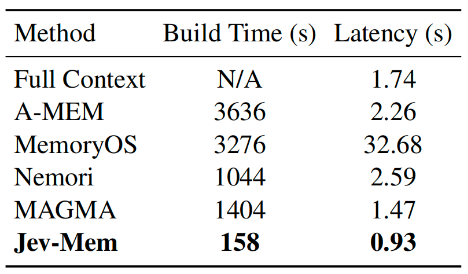
- 记忆构建时间 :把整套历史对话全部建成记忆库耗时;
- 单查询平均延迟 :用户提问,调取记忆并输出回答的平均耗时。
回答质量
对比最强基线MAGMA综合得分0.700, 相对提升11% 。
在多跳推理、开放域、对抗干扰场景提升尤其巨大。对抗场景意味着库里存在很多看起来相似但是错误的干扰记忆,Jev-Mem的证据评估打分机制可以很好过滤噪声。
运行效率
- 相比最快的竞品, 构建速度提升6.6倍,耗时降低84.9% ;
- 查询平均延迟仅0.93秒,对比第二名MAGMA降低36.7%,甚至比直接把全部上下文塞给大模型还要快。
提速没有牺牲质量,反而质量同步上涨 。过去很多轻量化记忆会牺牲效果换速度,而Jev-Mem靠架构分离,做到两全。为什么能做到?
- 大量判断交给轻量系统一控制器,不再频繁调用生成式大模型;
- 写入阶段只对筛选后的少量候选做关系判断,不和全部库比对;
- 查询时动态分配搜索预算,自适应停止,不盲目遍历整张记忆图;
- 传给大模型的证据是经过层层筛选的精简高价值集合,减少大模型负担。
四、启发与局限 创新亮点总结
- 架构创新 :把记忆控制本身作为独立系统层,而不是作为prompt里附属逻辑。区分轻量结构化决策(系统一)和生成式深度推理(系统二)。
- 读写统一 :记忆写入和读取,共用同一套系统一控制器,而不是写入一套逻辑、检索另一套。
- 保留原始信息优先 :写入阶段不做粗暴丢弃,避免早期误判删掉未来关键信息;合并、抽象为可选项。
- 检索是闭环决策过程 ,摒弃简单固定top-k,根据查询、已拿到的证据动态调整搜索策略,判断何时收手。
很多 AI Agent 记忆的性能瓶颈, 不一定是大模型能力不够,而是记忆管理流程频繁调用大模型带来巨大开销 。很多判断本质是打分、分类,不需要自由文本生成。把这些工作剥离出去,既省钱提速,还可以减少大模型幻觉对记忆管理流程的污染。
潜在局限
- 系统一控制器本身需要能够完成各类打分判断,依赖对应的模型能力;
- 论文实验主要基于LoCoMo对话数据集,在更复杂的真实世界多模态、工具调用智能体场景的表现还需要进一步验证;
- 各种阈值(关系阈值、证据充分阈值)需要调参,不同场景可能需要重新适配。
五、小结
Jev-Mem 的贡献不只做了一个更好的记忆图谱,它真正重要的是重新划分了计算职责:
- 高频、有界、结构化的记忆控制,交给轻量 System-One;
- 低频、开放、复杂的推理和生成,交给 System-Two;
- 写入和读取共享同一控制抽象;
- 检索不再是固定 top-k,而是带预算、评分、停止条件的闭环过程。
这带来一个很有价值的启示: AI 智能体的记忆系统,不应该只是“存什么”和“怎么搜”的问题,还应该问“由谁来做记忆控制决策”。
| 
 学习助手




 订阅