| 编辑推荐: |
本文厘清何时该微调、给出六步落地法,并用真实 BERT 代码拆解程序化增量微调, 希望对你的学习有帮助。
本文来自于腾讯云,由火龙果软件Alice编辑推荐。 |
|
概述 微调技术上已高度成熟,难点不在"怎么训"而在"拿什么训"。本文厘清何时该微调、给出六步落地法,并用真实 BERT 代码拆解程序化增量微调;指出生产已转向 LLaMA-Factory 等成熟框架。核心结论:80% 在数据、20% 在技术。数据质量决定上限,技术只是杠杆。文末以 20 人 AI 团队"岗位配齐却缺业务数据处理、应用能看不能用"的镜花水月故事收尾,提醒别为技术炫技,先把数据做扎实。
技术成熟的今天,微调的胜负手早已不在模型,而在数据—— 80% 在数据,20% 在技术 。
一个被高估的"难"
很多人一听到"大模型微调",脑子里立刻浮现的是:论文、公式、算法、几张 A100、调参调到头秃。但真相是: 微调这件事,技术上已经成熟到"没什么可炫"的地步了 。开源基座一大把(千问、LLaMA、ChatGLM),可视化平台把代码藏到了"拖拽 + 点一下"背后,连纯小白跟着新手引导都能跑通一个垂直模型。
那为什么还有那么多团队栽跟头?
因为大多数技术人从第一步就错了: 太执着于技术,却忘了数据才是那个真正决定成败的东西。 在这我想把话说透:微调为什么没那么难、它到底该怎么落地、以及为什么"80% 在数据,20% 在技术"不是一句鸡汤,而是项目用真金白银换来的教训。
一、什么时候需要微调?微调的场景是什么
先纠正一个误区:微调不是"通用模型不够强,我来加强一下",而是 通用模型在某个具体领域"答不准",我给它做专科培训 。
打个比方(这也是行业内最经典的类比):
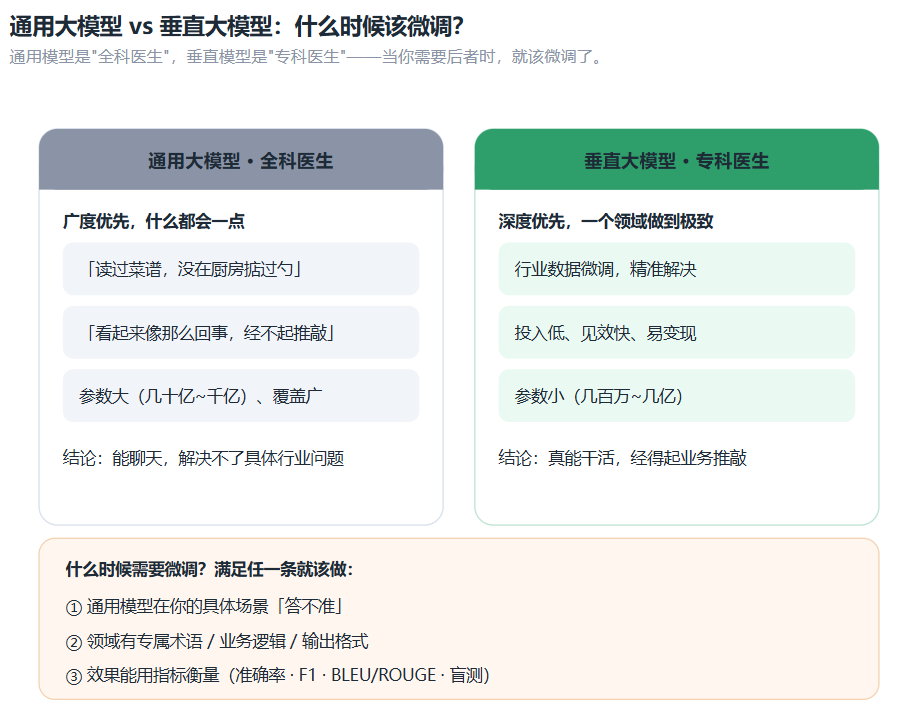
- 通用大模型 = 全科医生 :你问什么它都能聊几句,上知天文下知地理。但真让它处理你项目里的具体问题,答案大概率是"看起来像那么回事,经不起推敲"。
- 垂直大模型 = 专科医生 :只攻一个细分领域,能精准解决这个领域的具体问题,投入低、见效快。
通用模型"读过菜谱,知道翻炒是什么意思",但没在真实厨房里掂过勺,不知道火候多大、什么时候该翻。它"知道别人写过什么",不是"知道怎么做事"。这恰恰就是它需要微调的根本原因。
通用 vs 垂直大模型对比,以及"什么时候该微调"的三条判定:
满足下面任意一条,你就该考虑微调了:
- 通用模型在你的具体场景"答不准" :比如让它诊断某类工业设备故障、回答你们公司的技术规范,它胡说八道或给泛泛而谈的废话。
- 领域有专属术语 业务逻辑 输出格式 :医疗、制造、能源、金融……每个行业都有自己"长在手里"的经验,这些很少出现在公开互联网文本里,只能靠行业数据"练"出来。
- 效果能用指标衡量 :你能定义什么叫"好"(分类准确率 F1 生成 BLEU·ROUGE / 专家盲测通过率)。定不出标准,就先别动手。
反过来, 这几种情况别急着微调 :数据获取成本极高(如医疗影像要授权几十万起步);赛道是大厂重兵布局的红海;或者你只想蹭热点"躺赚"。这些都不是微调能解决的问题。
二、微调具体怎么落地?六步法
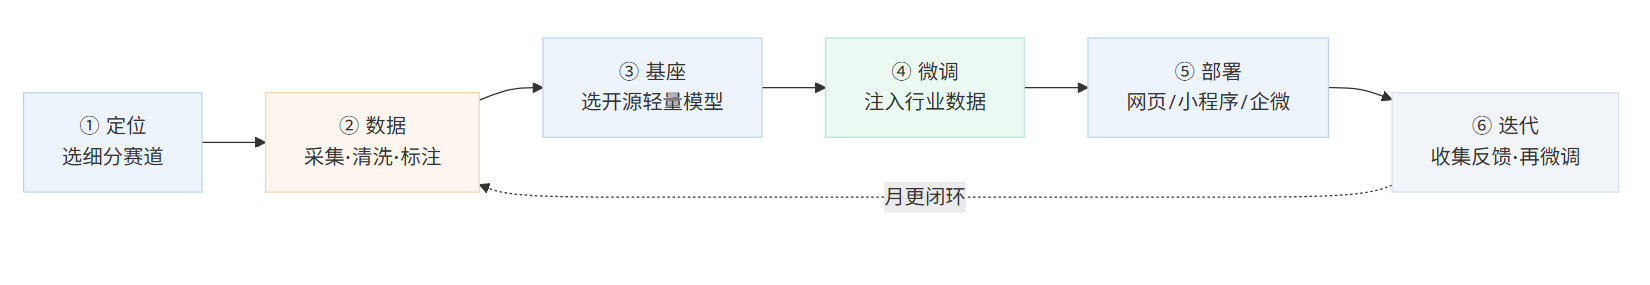
落到执行层面,垂直大模型的落地是一条很清晰的链路,业内基本共识是六步:
微调落地六步法:定位 → 数据 → 基座 → 微调 → 部署 → 迭代
- ① 定位 :避开"低价值 × 高投入""大而全",聚焦"高价值 × 低投入"的小而美赛道。
- ② 数据 :获取数据 → 清洗(去重 去错 去无关 / 统一格式)→ 标注。这是最吃功夫的一步,也是后面要重点讲的。
- ③ 基座 :别迷信参数多。优先"开源、轻量(1~10B)、易微调、中文优化"的模型,性价比最高。
- ④ 微调 :上传干净数据、设几个关键参数(模式 + 轮次,一般 3~5 轮防过拟合)、等结果、审效果。
- ⑤ 部署 :零代码工具一把部署成网页等软件。
- ⑥ 迭代 :每月花 1~2 天"收集反馈 → 补数据 → 重微调 → 上线测",形成闭环。
注意看: 六步里,"数据"是唯一一个被反复回扣的环节 。定位靠它定边界,微调靠它喂知识,迭代靠它补漏洞。技术(③④)只是其中两段,而且是最成熟、最不需要你操心的两段。
三、从一段真实代码看"增量微调"到底长什么样
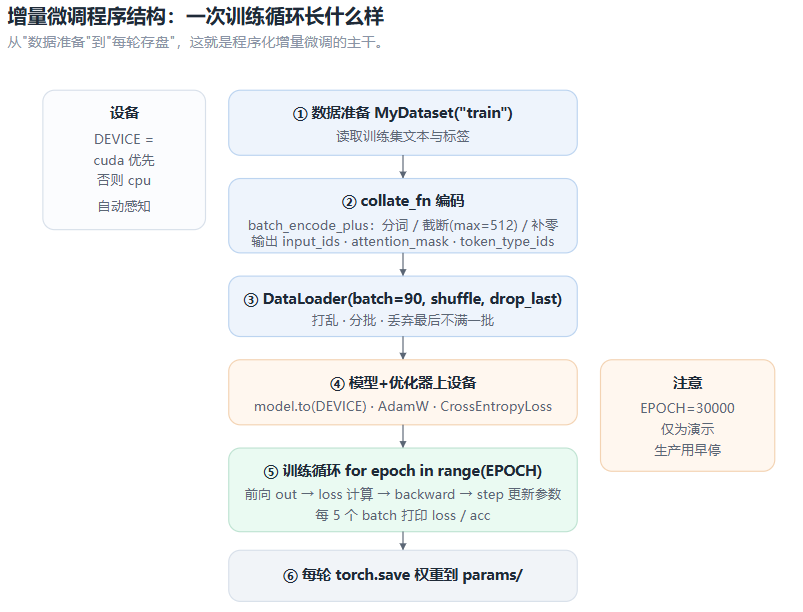
光说流程有点虚。下面我拿自己项目里的一段 增量微调程序` 逐段拆一下。你会发现,所谓"程序化微调",其实就是把上面的第④步用代码写死。
3.1 设备与训练规模
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
EPOCH = 30000
|
第一句是最基础的"自动感知":有 GPU 用 GPU,没有就退 CPU。第二句的 EPOCH=30000 只是演示值 。真实生产里绝不会跑 3 万轮,而是配合验证集 loss 做 早停(Early Stopping) ,一般 3~5 轮就够,再多就过拟合了。
3.2 分词器与编码(collate_fn)
token = BertTokenizer.from_pretrained(r"D:...\bert-base-chinese...")
def collate_fn(data):
sents = [i[0] for i in data]
label = [i[1] for i in data]
data = token.batch_encode_plus(
batch_text_or_text_pairs=sents,
truncation=True,
max_length=512,
padding="max_length",
return_tensors="pt",
return_length=True
)
input_ids = data["input_ids"]
attention_mask = data["attention_mask"]
token_type_ids = data["token_type_ids"]
label = torch.LongTensor(label)
return input_ids, attention_mask, token_type_ids, label
|
这一段是微调的"数据入口": collate_fn 把一个 batch 的文本批量编码成模型能吃的张量,处理截断、补齐、掩码。 这里操作的每一个样本,质量都来自你在第②步准备的数据 。数据脏,编码出来也是脏的。
3.3 数据加载与训练主循环
train_dataset = MyDataset("train")
train_loader = DataLoader(dataset=train_dataset, batch_size=90,
shuffle=True, drop_last=True, collate_fn=collate_fn)
if __name__ == '__main__':
model = Model().to(DEVICE)
optimizer = AdamW(model.parameters())
loss_func = torch.nn.CrossEntropyLoss()
for epoch in range(EPOCH):
for i, (input_ids, attention_mask, token_type_ids, label) in enumerate(train_loader):
input_ids, attention_mask, token_type_ids, label = (
input_ids.to(DEVICE), attention_mask.to(DEVICE),
token_type_ids.to(DEVICE), label.to(DEVICE))
out = model(input_ids, attention_mask, token_type_ids)
loss = loss_func(out, label)
optimizer.zero_grad(); loss.backward(); optimizer.step()
if i % 5 == 0:
acc = (out.argmax(dim=1) == label).sum().item() / len(label)
print(f"epoch:{epoch},i:{i},loss:{loss.item()},acc:{acc}")
torch.save(model.state_dict(), f"params/{epoch}_bert.pth")
|
这就是"增量微调"的程序主干: 前向算输出 → 算损失 → 反向传播 → 优化器更新参数 → 每轮保存权重 。逻辑干净、套路固定,没有任何黑魔法。一个刚学完 PyTorch 的工程师,半天就能看懂、改通。
说白了,这就是用程序的方式做增量微调。 你写好一次,后面每次有新数据,改改数据集路径、重新跑,就是在"增量"地让模型变聪明。
四、生产环境怎么做?LLaMA-Factory
上面那段程序适合 学习和可控的定制场景 。你能完全掌控每一行能理解了就可以了。
但到了生产任务,几乎没人再从零手搓训练循环。现在业内主流是直接用 LLaMA-Factory :国内开源、带 WebUI 可视化、原生支持千问 、 LLaMA 、ChatGLM 等基座,LoRA / QLoRA 低秩微调开箱即用,还能配合 DeepSpeed、Flash Attention 2 加速。
以新能源工程的真实落地方案为例(基于 Qwen2.5-7B):单卡 A6000(48G 显存)上用标准 LoRA + BF16,batch=8、cutoff_len=8192、rank=32/64,3000 条高质量数据 15~30 分钟就能训完,适配器文件小、方便热插拔、避免灾难性遗忘。
具体参数、配置、早停策略,直接看官方文档: https://github.com/hiyouga/LLaMA-Factory 。 文档写得比大多数博客都清楚,照着做就行。技术这层,真的已经"没那么难"了。 难点从来不在"怎么训",而在"拿什么训"。
五、80% 在数据,20% 在技术
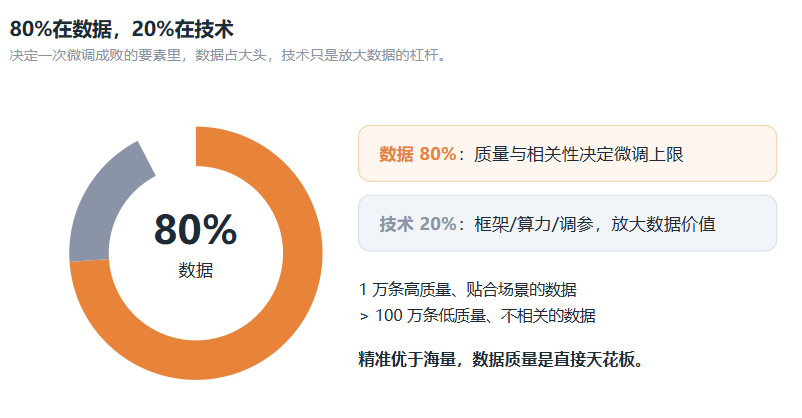
这是整篇文章最核心的一句话,也是我见过太多项目后最笃定的结论:80% 在数据,20% 在技术
为什么是这个比例?
- 数据质量决定微调的上限。 垂直领域里, 1000 条高质量、标注精准的指令数据,往往胜过数万条充满噪声的数据 ;3000 条经过严格清洗和专家标注的数据,就足以让一个 7B 模型学会某领域的术语体系、业务逻辑和输出格式。
- 技术只是放大数据的杠杆。 框架、算力、调参,决定的是"你多快、多省地把数据喂进去",但喂进去的如果是垃圾,出来的还是垃圾。
- 精准优于海量。 1 万条贴合场景的数据 > 100 万条不相关的数据。好的数据还能反向省下大量清洗、标注和训练时间。
所以精力怎么分配?既然现在训练时间不再是瓶颈(分钟级),你和团队的核心精力就应该 完全压在第②步的数据清洗与标注上 :多人交叉标注算 Kappa 系数 ≥ 0.8,建专属词表统一术语,把"业务里的真问题"翻译成"模型能懂的语言"。
技术人最容易犯的错,恰恰是反过来花 80% 的精力调参、换基座、追新框架,却用 20% 的精力随便凑数据。方向一错,模型再花哨也是空壳。
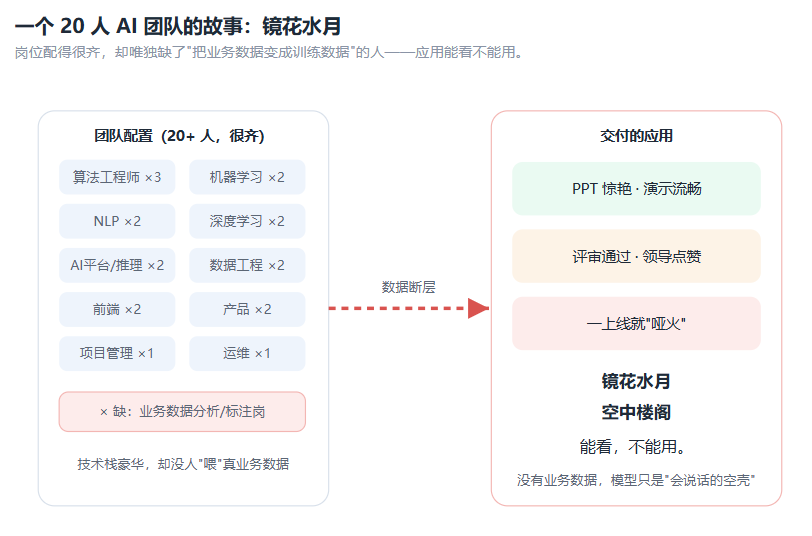
六、一个 20 人 AI 团队的故事:镜花水月
讲个故事,如有雷同纯属巧合,这也是"80% 在数据"最痛的例子。
有一支 20 多人的 AI 团队 ,岗位配得那叫一个齐:算法工程师、AI 平台与推理优化、研发、产品、项目管理等,基本上你能想到的 AI 相关角色,都配齐了。技术栈豪华,PPT 也做得漂亮。
但问题出在一个 谁都没专门盯的缺口上:团队里没有人真正做"业务数据分析与处理" 。也就是把公司真实业务里那些散、乱、脏、非结构化的数据,清洗、标注、组织成"模型能学"的训练集。
结果呢?20 人 AI 团队"镜花水月"
他们做出来的应用: 评审会上惊艳、演示流畅、领导点赞 ;可一上线,遇到真实业务数据就"哑火"。回答跑偏、决策不可信、基本都是用两次就不用了。
这就是典型的 镜花水月、空中楼阁:能看,不能用。
根子不在算法不够强,也不在前端不好看,而在于 没有人把"业务"翻译成"数据" 。模型没有吃过真业务的数据,它只是个"会说话的空壳",看起来什么都会,落到具体场景就露馅。
这个故事想说的就一句: AI 团队的标配里,必须有"懂业务 + 会处理数据"的人,否则再齐的阵容都是摆设。 业务数据,才是让应用从"演示"走向"能用"的那块地基。
七、总结
- 微调没那么难。 开源基座成熟、工具可视化、训练分钟级。技术门槛已经被压到很低,别再把它当玄学。
- 但很多技术人从第一步就错了。 错在执着技术、轻视数据;错在把"模型部署上线、能答几个问题"当成"落地"。
- 80% 在数据,20% 在技术。 数据质量决定上限,技术只是杠杆。先把业务数据这块地基打牢,再谈模型。否则你交付的,永远只是镜花水月。
做模型是手段,落地是起点,持续产生价值才是终点。 而价值的前提,是你手里真的有"业务的数据",而不只是"先进的技术"。
| 
 学习助手



 订阅