| 编辑推荐: |
本文主要介绍了一个叫
LLM-Wiki 的本地知识库方案:用大模型把原始文档(如采购合同)"编译"成带双链引用的
Obsidian Wiki 知识图谱,再配三个 Skill(知识复用、Wiki
检索、知识沉淀)做深度关联问答,以此补上 RAG 在 chunk 切分、语义鸿沟和上下文碎片化上的短板。希望对你的学习有帮助。
本文来自于微信公众号大模型的朋友,由火龙果软件Alice编辑推荐。 |
|
01为什么需要 LLM-Wiki
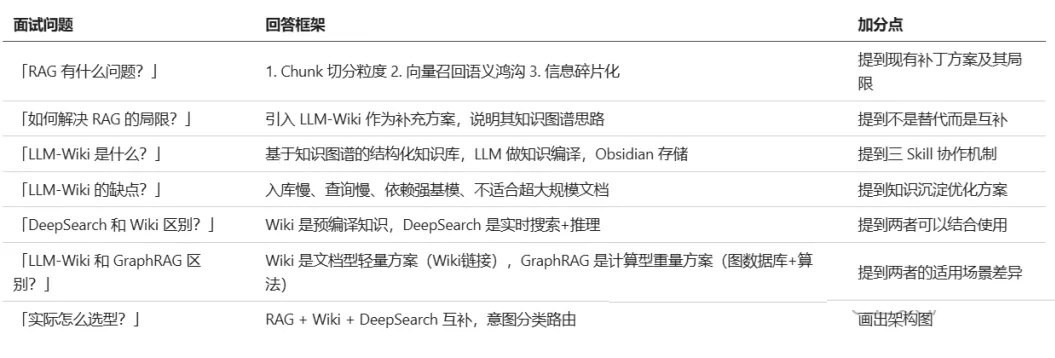
「RAG已死」、「RAG 过时」?RAG并没有死,也没有过时,它只是存在一些缺点。通过新的技术LLM-Wiki对它的一种补充。
RAG存在的一些问题和不足
| 技术方案 |
核心机制 |
最佳场景 |
与
LLM-Wiki 关系 |
| RAG |
向量相似度匹配 |
事实查询、快问快答 |
基础层,处理简单查询 |
| LLM-Wiki |
知识图谱遍历 |
关联分析、深度推理 |
增强层,处理复杂查询 |
| DeepSearch |
多轮搜索+验证 |
开放域研究、最新信息 |
扩展层,处理实时查询 |
RAG的局限性
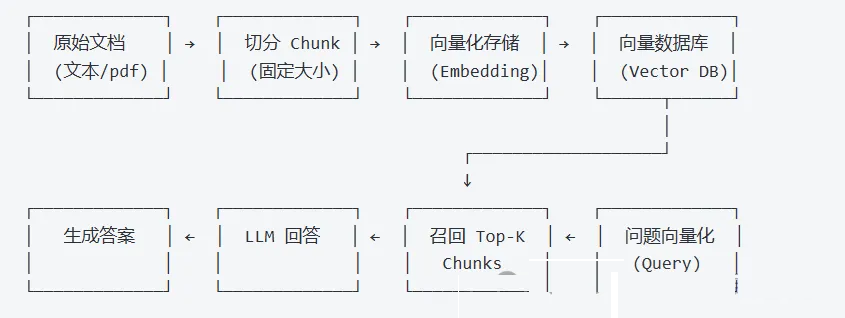
有一个文本文档,把它拆成很多小部分,每个小部分叫chunk,把每个
chunk再做一个向量化。
当你用户问到一个问题的时候,把这个问题转成向量,从向量库里找一个
similar相近的,最后扔进LLM里,回答得到答案。这个就是RAG的一个最基本流程。但是Rag架构有一个先天的缺点。
Rag三大核心问题详解
问题一:Chunk切分粒度难以控制
首先第一切chunk的时候,很容易出现大小不好控制的问题。有可能切得很碎,也有可能切得很大。对于不同的问题来说,它的细粒度很难去做一个控制,包括RAG的各种技巧,其实都是在调整chunk的大小。
| 切分方式 |
问题 |
后果 |
| 切太碎 |
丢失上下文 |
无法理解完整语义 |
| 切太大 |
包含噪声 |
召回精度下降 |
| 固定大小 |
无视语义边界 |
句子被截断 |
问题二:向量召回的语义鸿沟
第二个问题是向量化召回有可能召回不准。query是一个问题空间,chunk往往是陈述。就是它们语义未必有那么接近。
问题三:信息碎片化与上下文丢失
召回的往往都是一些碎片化的信息,而不是一个整体信息。比如召回chunk,它的上下文可能很有帮助,但是恰恰没法召回,以及它没有时序信息、没有文本的时间信息。正常来说看一篇文章,从左到右读下来,它有前文有后文,而chunk其实把先后顺序给打散了。一本小说它的开头和结尾,对于向量来说是体现不出来的,具体在一篇文章中什么时候出现也体现不出来。
问题总结表
| 问题 |
具体表现 |
影响 |
现有解决方案 |
| Chunk 切分粒度难控 |
切太碎丢失上下文,切太大召回不准 |
不同问题需要不同粒度 |
滑动窗口、重叠切分、语义切分 |
| 向量召回语义鸿沟 |
Query 是问题,Chunk 是陈述,语义空间不一致 |
召回内容可能与问题不相关 |
Query扩展、重排序、HyDE |
| 信息碎片化 |
召回的是片段,丢失时序和上下文关系 |
无法回答宏观、总结类问题 |
上下文扩充、知识图谱... |
有些相对来说比较偏宏观、总结,关联性比较强的知识,它其实不是那么好解决。
它其实有很多解决技巧啊,去给这些问题打补丁:
- 滑动窗口:解决切分边界问题
- HyDE(假设文档嵌入):解决语义鸿沟问题
- 重排序(Rerank):提升召回精度
- 上下文扩充:增加chunk周围文本
但是归根到底也是一种补丁,LLM-Wiki是针对这个情况搞出来的概念。
02LLM-Wiki架构设计
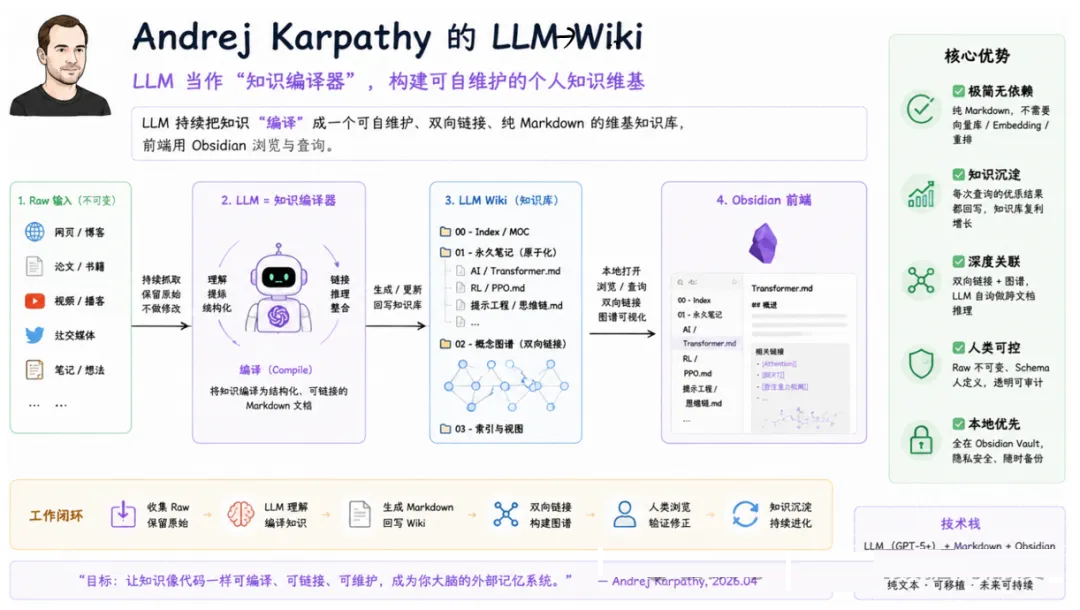
知识编译器的概念,做了一种新型知识库。用它来做一个问答弥补RAG所带来的一些问题。
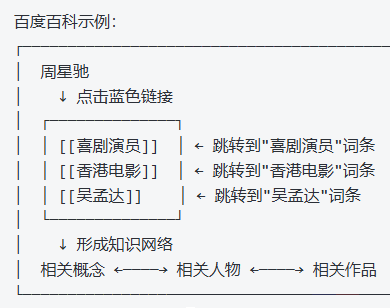
Wiki就是知识之间的相互引用,通过点击引用到了下一个页面,这个就是wiki,内容之间通过一些关键词来相互引用,最终可以展成一张比较大的一张图。它本身存在的问题也是有的,它并没有给出一个完整的开源框架,更多提出了一种概念。把这种概念通过AI
coding直接实现,你要有一个架构能力和设计能力。
核心流程
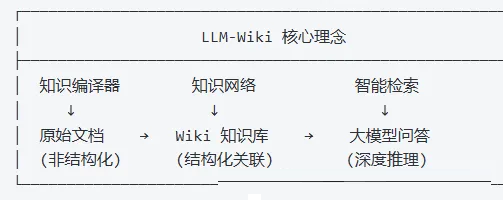
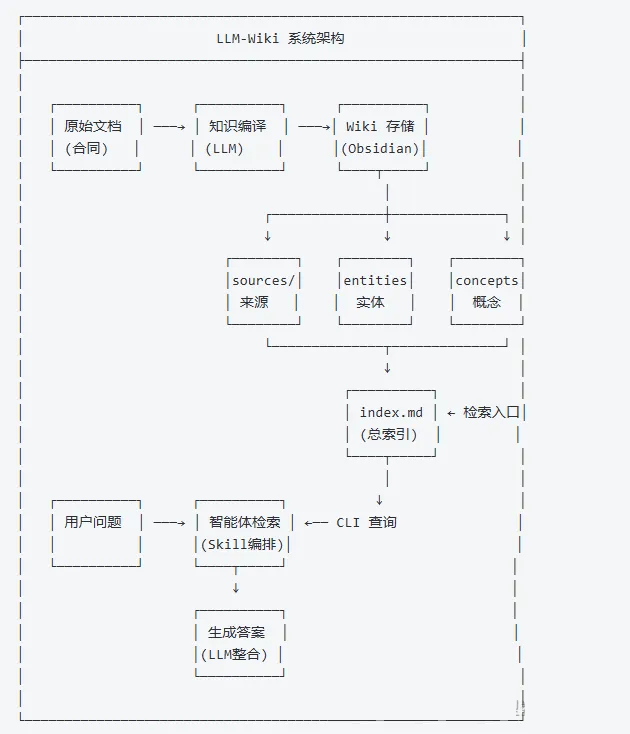
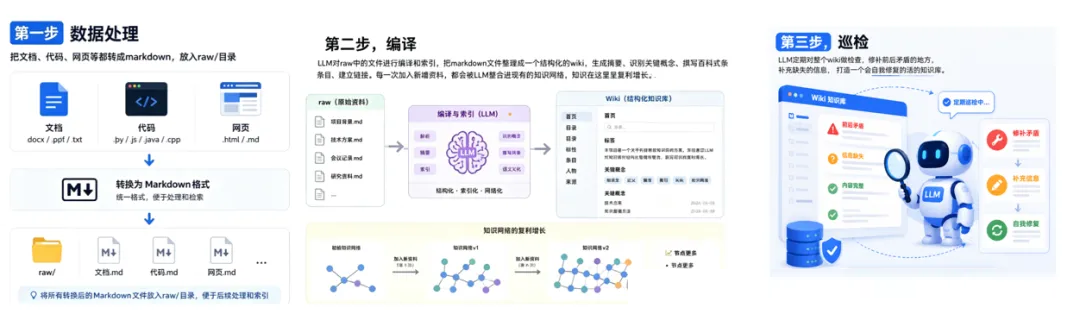
首先会把原始的输入,通过大模型做知识编译器,把它放到wiki里,用
wiki来做知识库。针对wiki来进行问问题,这个叫LLM-Wiki,就是通过LLM大模型来建造wiki。中间是wiki的存储,它是用Obsidian数据库。最后通过对wiki数据库来做一个问答。这个就是它整个的流程。
系统整体架构
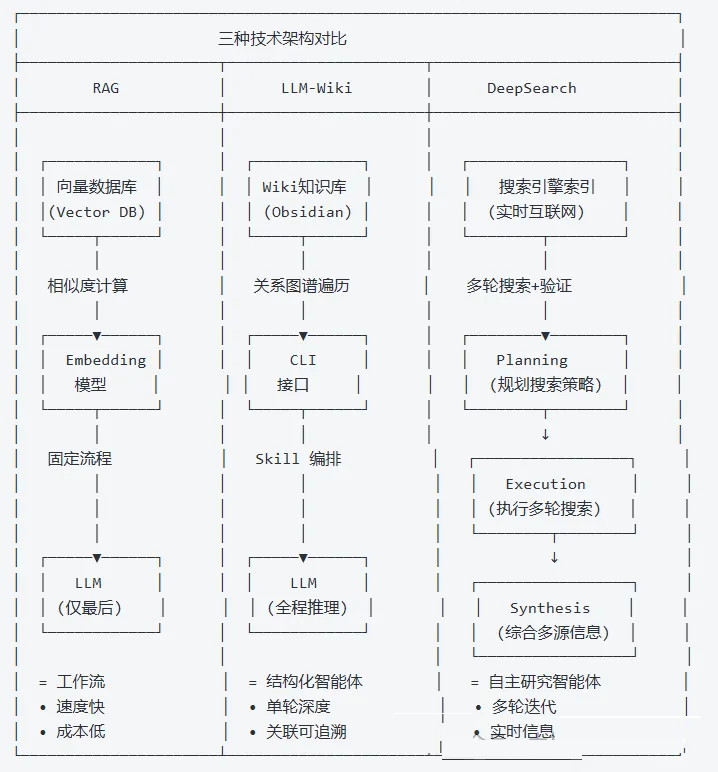
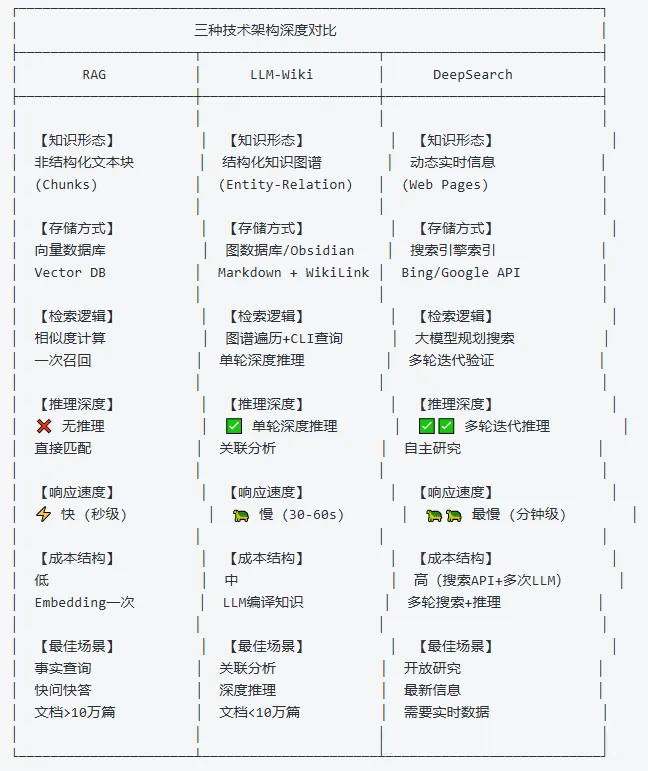
Rag、LLM-wiki、DeepSearch三种架构的对比
03项目实战-采购合同知识库
数据特点与关联关系
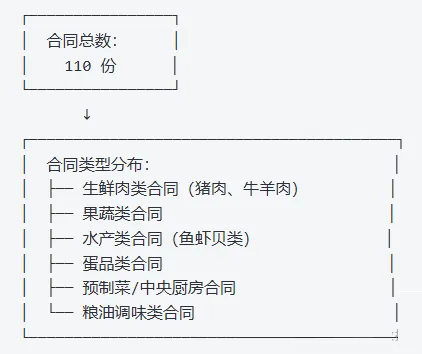
首先会有一些文章合同。合同为Markdown格式,一堆原材料厂商和饭店会签很多牛羊肉的供给、中央厨房、买卖食品的合同。
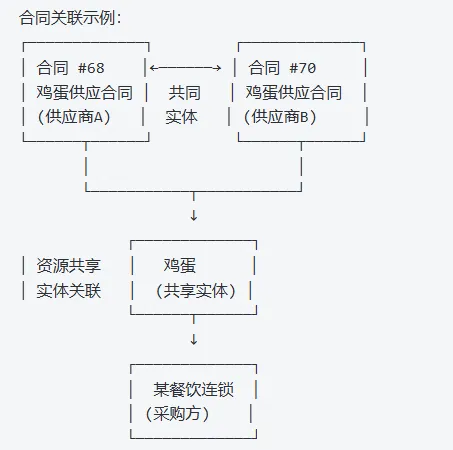
这些合同之间会有一些互相的关联。比如第68个合同是卖鸡蛋的,第70个合同也是卖鸡蛋的。他们两个合同就有共同的中间节点就是鸡蛋。一家餐厅可能会跟多个供应商来签订合同,这都是一些关联点。
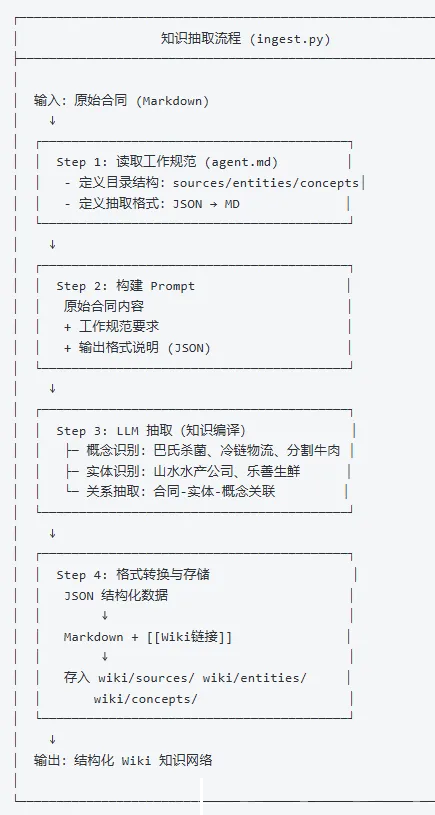
知识抽取流程(Ingest)
要把它做成知识图谱。ingest用来进行抽取。
首先会有一堆提示词:“请根据工作规范把原始资料整理成wiki结果”。agent.md作为工作规范。
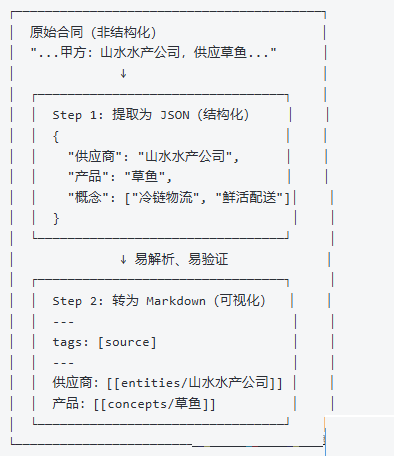
最终结果是存成MD格式。因为JSON格式相对来说比较结构化,好解析。所以抽成JSON格式之后再把JSON格式转成MD。
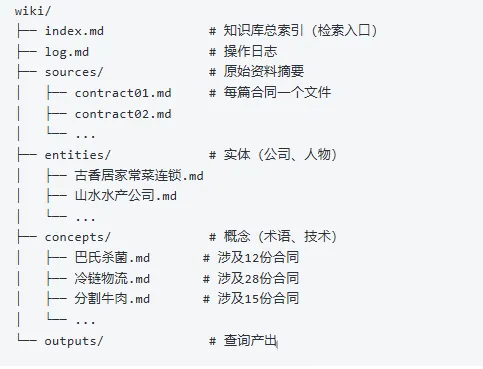
目录结构与内容示例
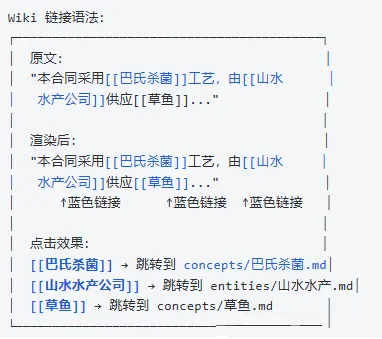
可视化效果
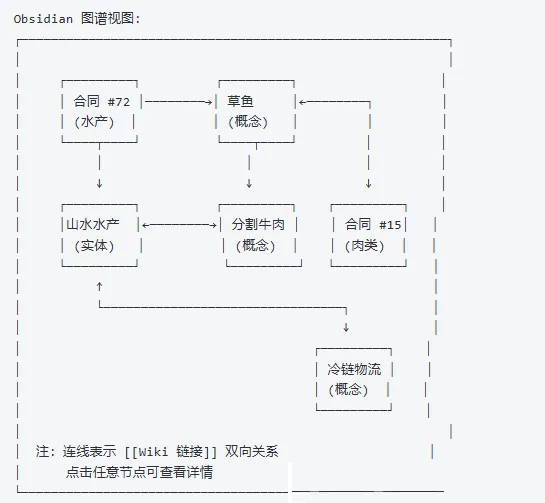
通过大模型抽取完之后,把原始数据先放在sources/文件夹里。每篇合同抽取完之后都会用wiki的形式来放进来。双括号表示:这个合同涉及到这个概念,点击就会跳转到对应概念上,这个就类似于加了一个超链接标识。
数据结构存完的结果
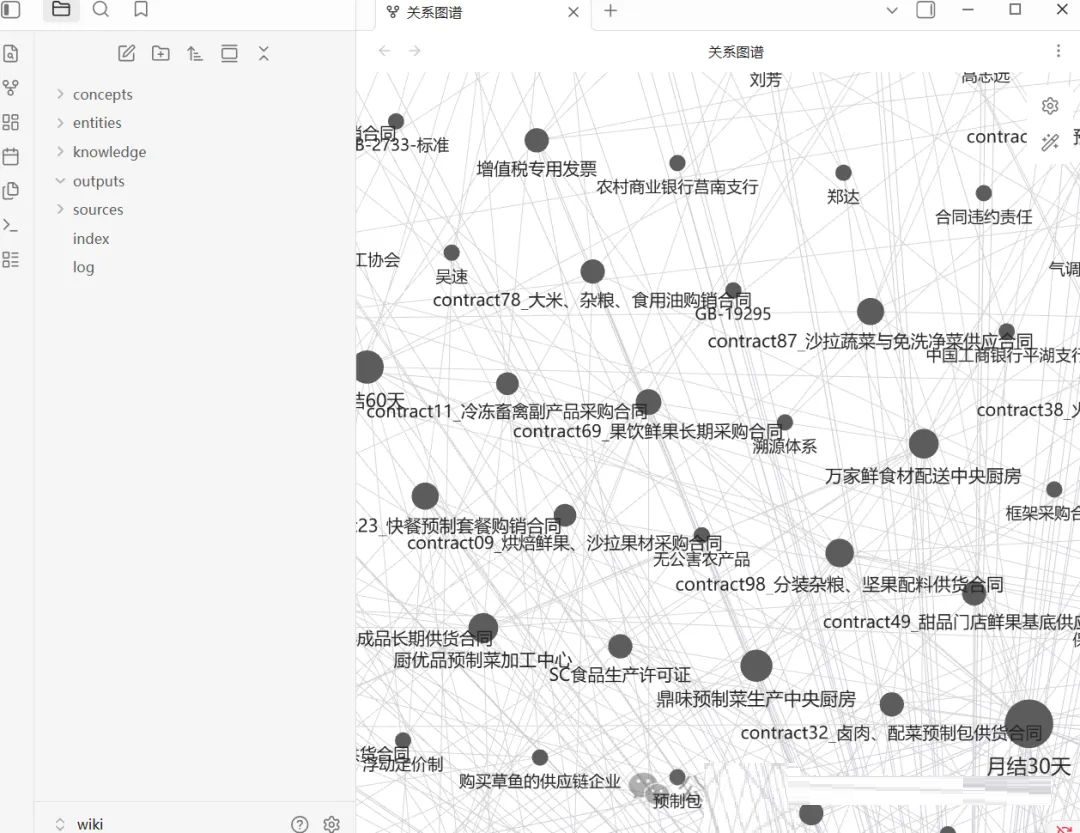
Obsidian会直接把wiki文件夹给打开。就可以看图谱,整个这里面这些东西,全做成了一个图谱关联。比如说淡水鱼虾原材料贝类的供货合同,点开会发现72号的淡水鱼虾合同,跟在这个地方显示的一模一样。
72号这里有四个概念,用中括号、两个方括号给框起来,这里就有四个对应的。这里有相关实体框起来,点一下它就直接跳过来了。
这样这些文档之间,文档实体还有概念之间,都通过这种方式来建立了关联。
Obsidian仅仅是类似一个数据库,专门用来存储wiki这种数据资料。通过建索引,会专门对这种双括号、双方框进行一种特殊的解析,保证一点就能跳过来,它这个仅仅是做一个管理作用。通过这种方式把整体的这种非结构化的合同,直接把它全部整成了wiki
结构化的知识。
CLI工具链
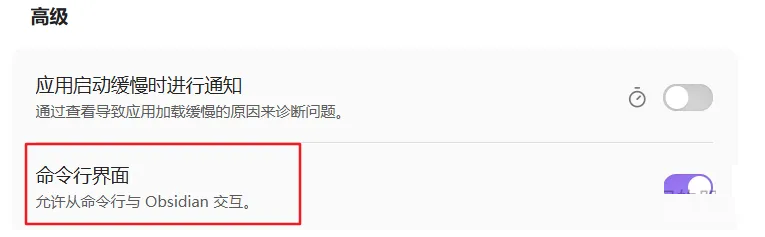
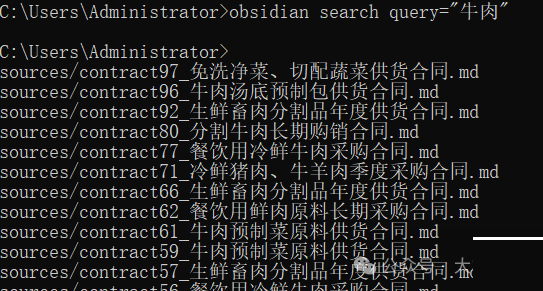
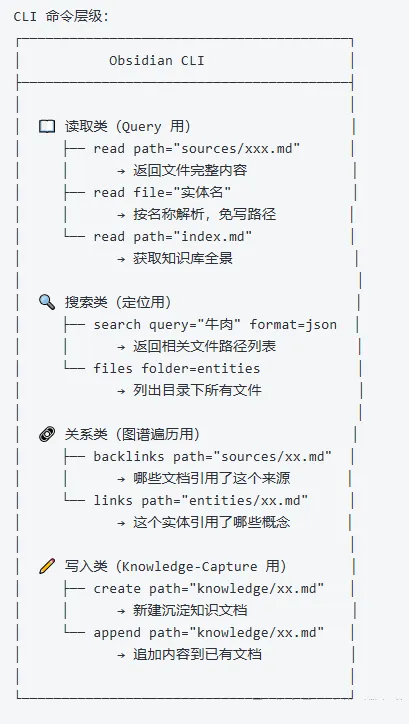
Obsidian它提供了一套完整的CLI,比如要搜索牛肉,就就会把牛肉相关涉及到的文档全都给搜索出来。CLI功能非常强大,各种复杂检索的功能,全部在CLI里头。
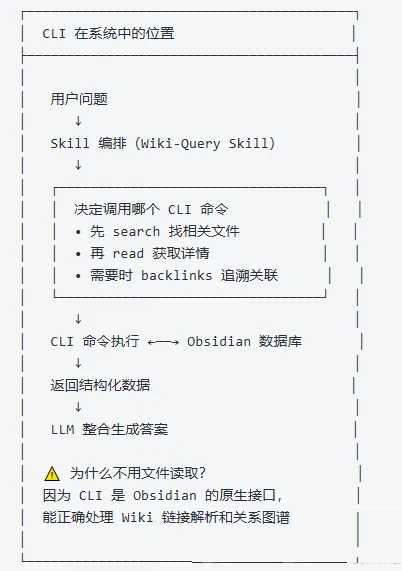
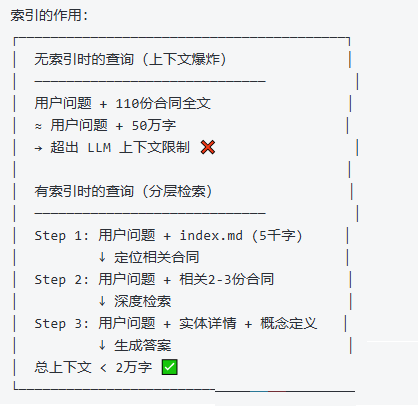
有了CLI,就会把CLI放到skill里,让skill来对这些东西作为一个检索。我们提取的东西非常多,如果一开始把这些内容全部扔到大模型里,上下文就撑爆了。
索引机制:解决上下文限制
所以针对这些特别的内容呢,我们在生成内容的时候会专门建立一个特殊的文件index.md索引。索引会把wiki里面的东西,全部列一个目录。在做检索知识库获取的时候,首先读取目录。比如说发现要找鲜鸡蛋,就可以通过合同再去把它相关的内容给找到。
对知识库整体做index,每个实体讲什么。这个是检索的入口,只有看到入口之后,才知道具体去查哪个。
另外还有沉淀知识的index,复用知识的时候先进行一个分析。就是它入口的一个文件,类似索引,只不过这个索引不是那种常见的倒排索引或者向量索引,而就是一篇文章,一个文本,让大模型理解这个文本,去找到对应的东西。
04智能检索系统
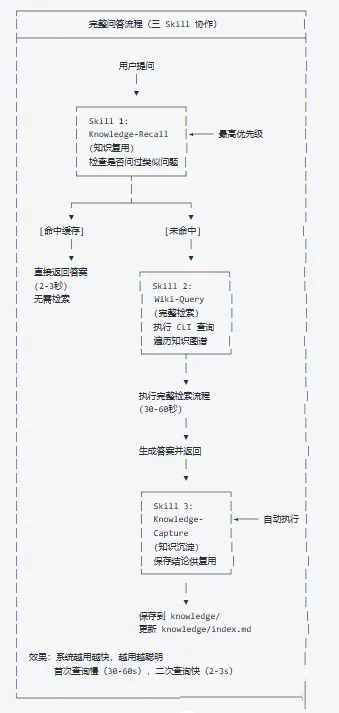
三个Skill协作机制
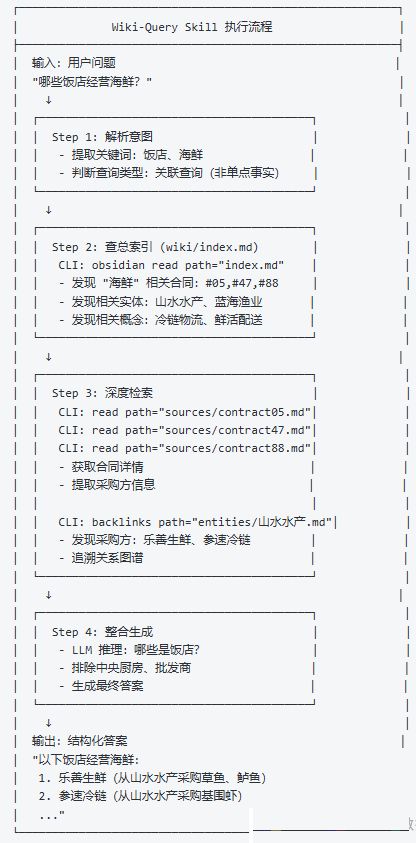
检索相关的知识,会有一个Skill叫做Wiki-Query。
Skill 1: Knowledge-Recall(知识复用)
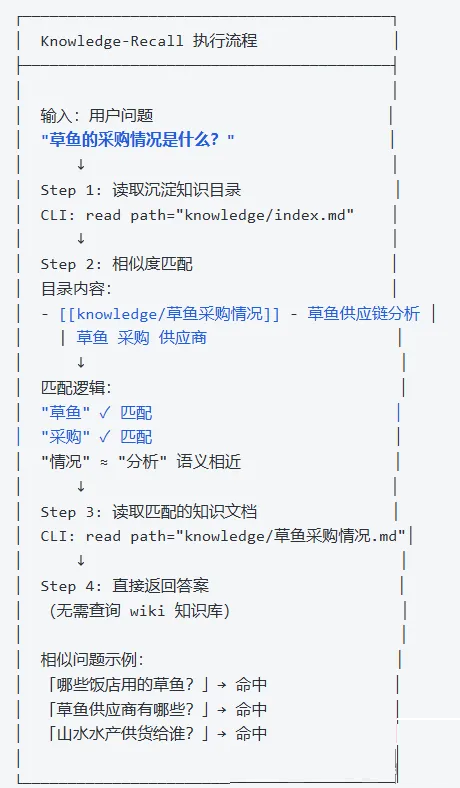
recall skill是优先级最高的。当你问完问题的时候它会优先调用
knowledge-recall这个skill。
工作原理:这个skill会扫描knowledge下面的index,看下这个问题之前有没有涉及到,如果有涉及到就直接用之前涉及到的这个文档来做回答。
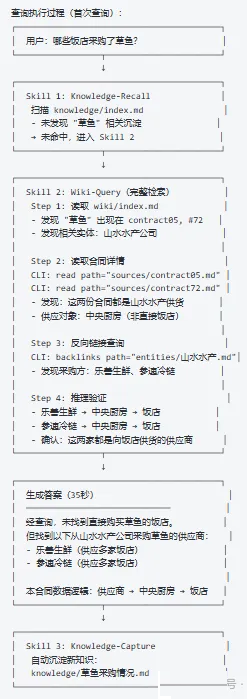
Skill 2: Wiki-Query(完整检索)
如果没有涉及到,再调用Wiki-Query来做一次完整回答。它会把检索的流程全部写在里头。
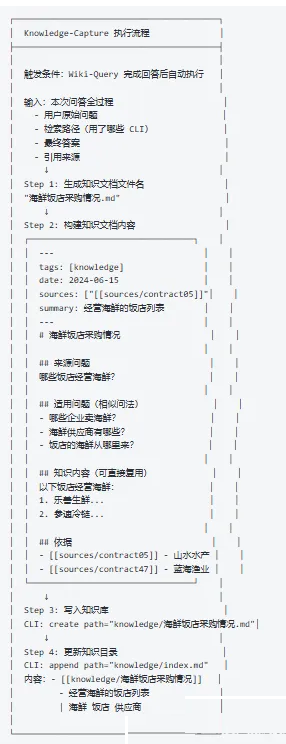
Skill 3: Knowledge-Capture(知识沉淀)
做完完整回答之后再把这个东西给沉淀下来。
有三个skill的,它的整个流程。
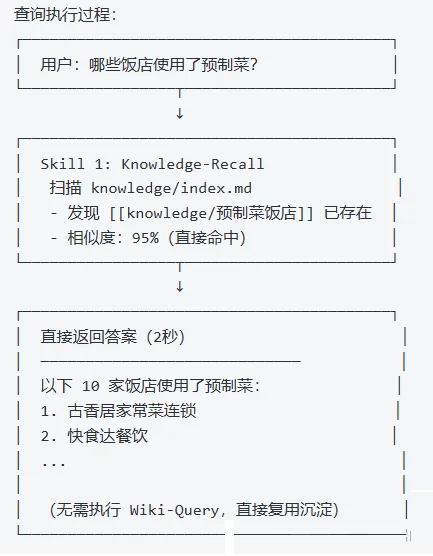
查询示例:从问题到答案
示例一:哪些饭店使用了预制菜?
如果用传统RAG其实还真不太好解决。因为它是哪些饭店使用预制菜,肯定不是说某一篇合同的细节,肯定是一个整体情况。所以说这种传统的RAG真不太好解决这个东西。
示例二:哪些饭店采购了草鱼?
没有找到直接购买草鱼的饭店,但是找到了购买草鱼的供应商。因为合同的逻辑是说,饭店从中央厨房采购,中央厨房再从鱼贩子、菜贩子手里头采购东西。答案是没有问题的。
它这个检索模式是先创建一个智能体,智能体会加载这个skill。当你出来问题了之后,用这个skill来做检索。通过大模型加Skill,比如输入草鱼,它首先会看index索引的这个文章里头,哪些东西跟草鱼有关。
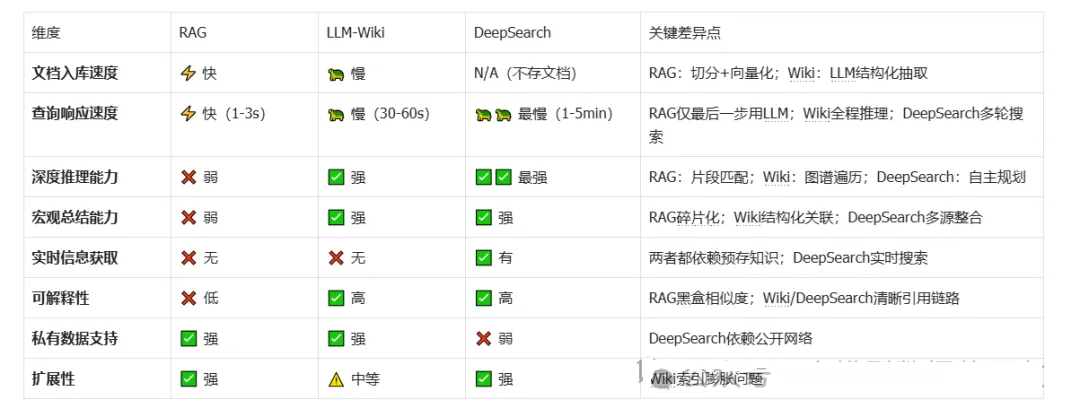
三种技术的查询方式对比
性能优化:知识沉淀与复用
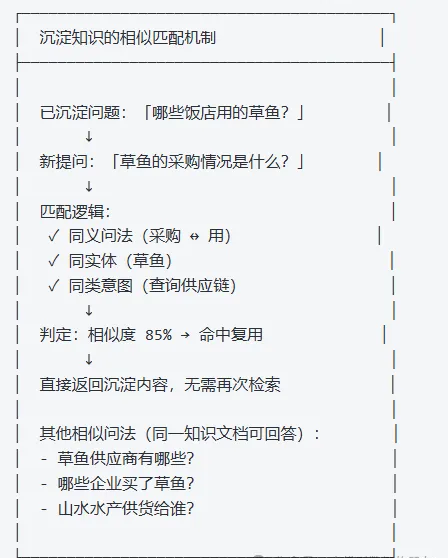
整个运转过程还是比较长的,时间消耗比较多。因为它可能涉及到一些知识的理解,反复调用大模型。所以可以把之前问过的问题knowledge文件夹,再沉淀到一个新的MD文件里,也就是说这个系统把之前问过的问题沉淀成新的文档。哪怕第一次很慢,后面就会快很多。所以这个系统其实是越用越聪明,越用速度越快。
相似问题匹配机制
这个文档每次用的时候它都会进行一次新的生成。比如问它饭店预制菜的情况,它就会把哪些饭店用了预制菜全部给我说出来,全部列在这里。下次再问相同问题的时候,它就可以直接来调用这个知识。
05技术对比与选型
三维对比框架
LLM-Wiki最核心的地方,它所有问题都是Skill来做的,它的检索都是通过CLI来做的。它整个检索流程,核心检索是通过CLI来检索。但它检索的数据怎么组织、数据检索哪些东西全是通过Skill来控制的。
它跟RAG其实完全是两个东西。RAG更加偏向于工作流,而Wiki其实是一个真正的智能体,直接加载Skill来做这个事情。
架构差异总览
性能特点详细对比
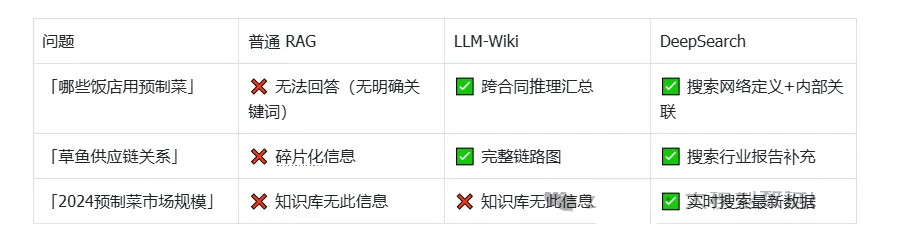
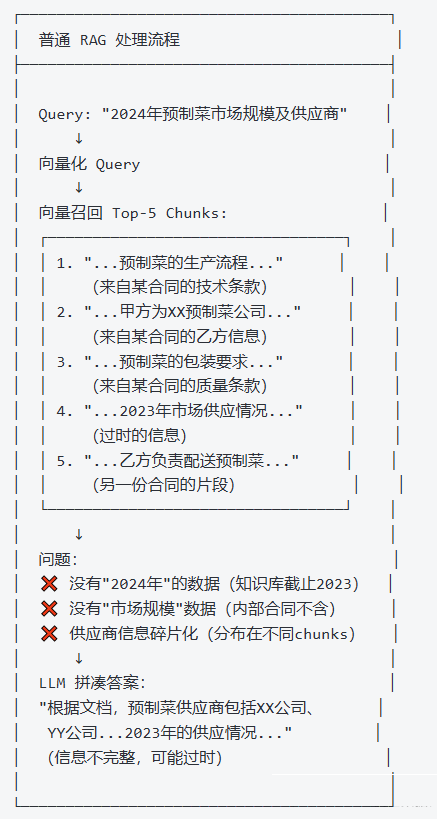
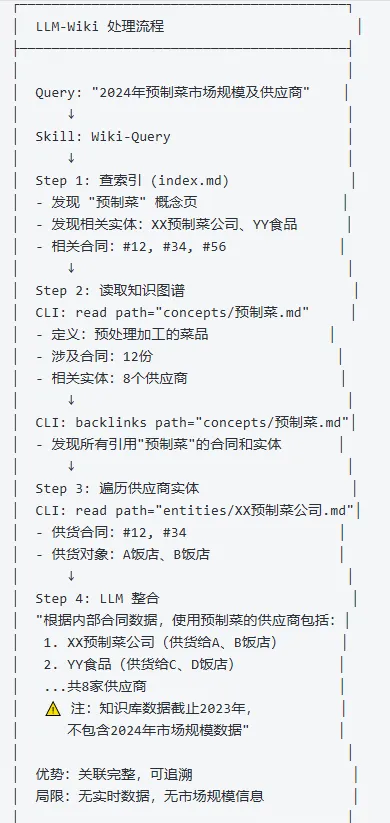
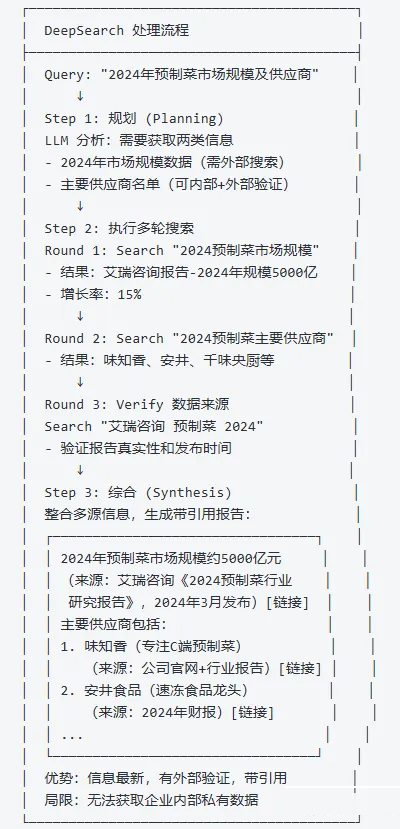
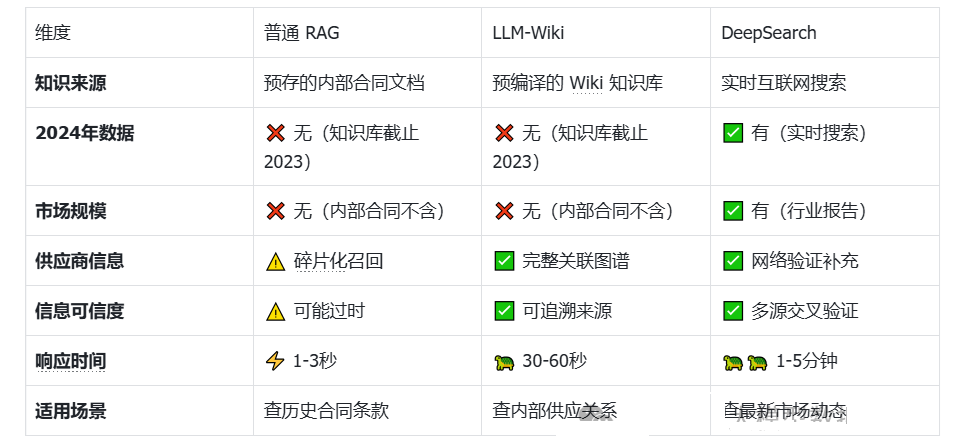
同一问题的三种解法
为了更直观地理解三者的区别,看同一个问题在三种系统中的处理方式:
问题:「2024年预制菜市场规模及主要供应商有哪些?」
普通RAG的处理
LLM-Wiki的处理
DeepSearch的处理
三种处理方式对比表
企业级融合架构
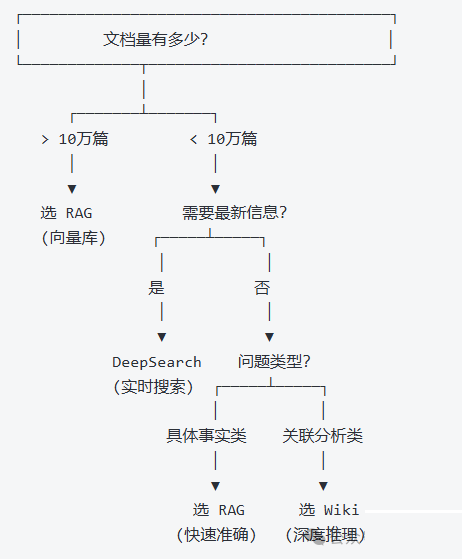
当你的文档量非常大,还是建议用RAG。而Wiki涉及到当文档量比较少,但是问答相对来说是比较有深度。深度问答和总结性质的东西的时候可以用Wiki。
RAG那种检索的方法出来的东西都是很碎片化。问具体的一两个点它其实挺好的。但是问哪个饭店有预制菜,它其实可能都没法检索,因为没有合同会写自己是预制菜,它都需要大量的理解。所以这时候LLM-Wiki
它的作用其实会很大的。
这两条技术其实更多应该是一个互补型的技术而不是相互矛盾的技术。
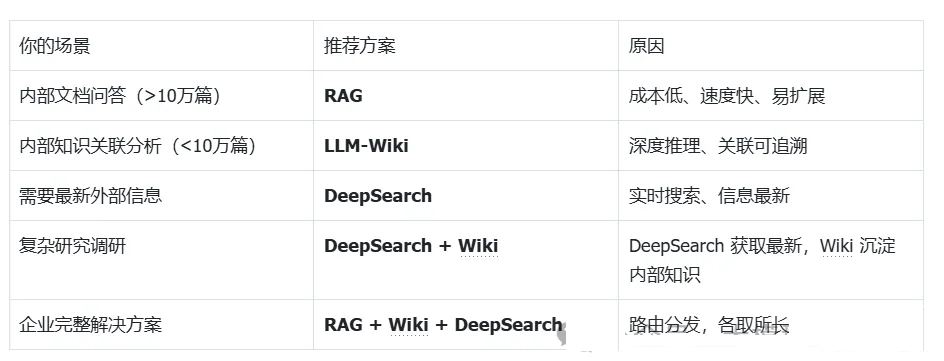
推荐融合方案
技术选型决策树
选型建议总结
06一句话总结
它诞生的客观条件
- 首先它的LLM基模能力强,它完全依赖于基模足够强。这里用的是32B的模型,如果换成个2B的模型,它的效果立刻下降,所以说这个技术对基模的要求比较高的。
- 第二个它对上下文的长度要求也是比较高的。就是因为skill,它不是文档单个片段进去,它是整个文档都进去,所以它对长度要求也比较高。
- 第三个问题,慢。这是LLM-Wiki先天带来的一些问题。
这个问答系统后面接一些Dify、LangChain、OpenClaw、workbuddy等就把问答的skill直接给它就天然的接上了。
所以说它跟这些就是现有的这些产品,智能体产品呢,想做一个融合的话呢,其实就以
skill 的方式提供出去就可以了。
07扩展
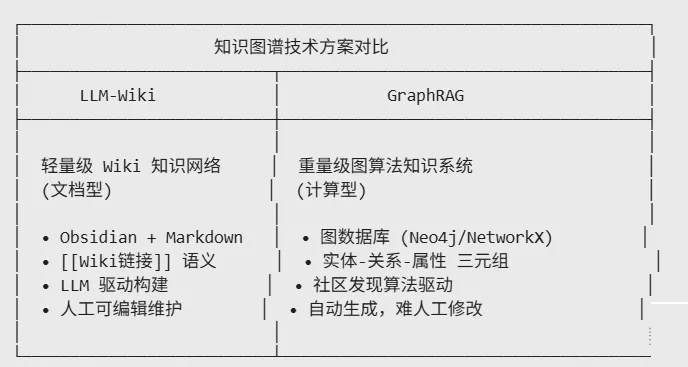
我们将LLM-Wiki与普通RAG、DeepSearch进行了对比。但还有一个重要的技术方案—GraphRAG(微软开源的图增强RAG方案)。LLM-Wiki用了知识图谱,那它和GraphRAG有什么区别呢?
核心定位的差异
= 用 Wiki 链接模拟图谱关系(文档型)
= 用 图数据库存储图谱关系(计算型)
| 
 学习助手




 订阅