| 编辑推荐: |
文章主要解读了一篇论文,该论文系统分析了 LLM 推理在 GPU 平台上的请求能耗与 Token 能耗,揭示了当前“按 Token 计费”与“按推理窗口耗能”之间的错位,并给出了构建能源感知 LLM 服务系统的实践指导, 希望对你的学习有帮助。
本文来自于模智空间,由火龙果软件Alice编辑推荐。 |
|
当我们在讨论大语言模型(LLM)的推理成本时,目光通常聚焦在两个地方:一是云服务商按Token数量明码标价的API账单(如OpenAI的定价),二是衡量服务性能的指标,如首Token延迟(TTFT)或每输出Token延迟(TPOT)。这些指标构成了我们熟悉的Token经济。
然而,这篇来自卡内基梅隆大学研究团队的论文《Characterization of Request and Token Energy Costs for LLM Inference Workloads on GPU Platforms》却指出了一个被长期忽视的问题: LLM服务按Token计费,但GPU的能源消耗却是按推理窗口(Inference Window)(即一个请求从开始到结束的完整时间段)来计算的。 这种错位导致了一个反直觉的现象: 平均每Token的能耗(J/token)降低了,并不代表总能耗真的减少了。
论文通过大量的实验数据,为我们拆解了LLM推理的能耗构成,揭示了请求能耗(Request Energy)与Token能耗(Token Energy)之间的微妙关系,并为构建真正能源感知(Energy-Aware)的LLM服务系统提供了指导原则。
拆解LLM推理的真实能耗
要理解这个错位,先得知道 LLM 推理是怎么跑的。推理分两个阶段, Prefill ( 预填充 )和 Decode(解码) 。
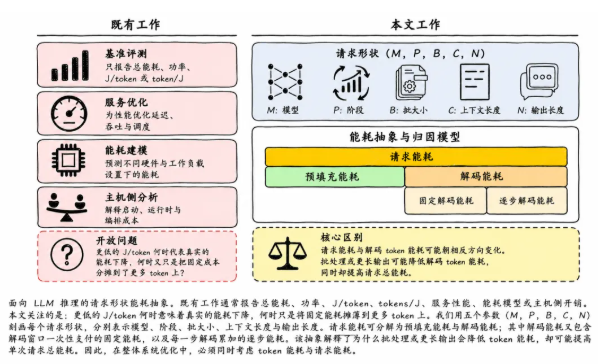
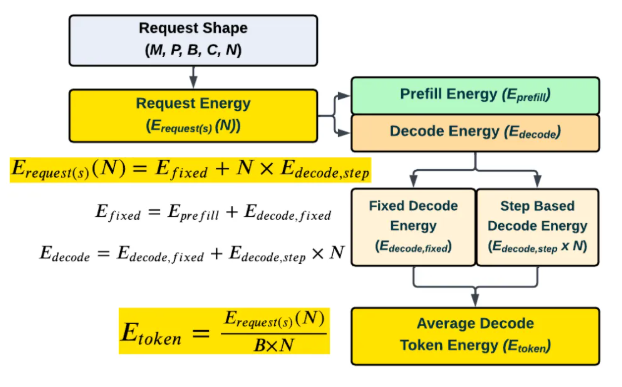
预填充阶段 :这是模型阅读和理解你输入的Prompt的阶段。它是一次性的、计算密集型的操作,GPU利用率高,功耗大,但时间相对较短。论文将这个阶段的主要能耗归为 固定能耗(E_fixed) 的一部分。
解码阶段 :这是模型写作或思考,逐字生成输出Token的阶段。它是自回归的,即每次只能生成一个Token,且后续步骤依赖于前面的结果。这个阶段的能耗进一步分解为两部分:
- 固定能耗(E_decode, fixed) :在开始生成第一个输出Token之前,模型需要进行一系列准备工作,如Kernel启动、CUDA环境同步等。这部分开销是固定的,无论你最终生成10个Token还是1000个Token,都需要支付这笔入场费。
- 边际能耗(E_decode, step) :这是生成 每一个额外Token 所增加的能耗。这部分成本主要来自模型的计算和访问不断增长的KV-Cache所带来的内存开销。
基于此,论文提出了一个核心公式,来描述一个批处理(Batch)请求的总能耗:
E_request(s)(N) = E_fixed + N × E_decode, step
其中,N代表输出长度。这个公式的意义在于,它将一个请求的总能耗清晰地划分为与输出长度无关的固定成本和与输出长度成正比的可变成本。
我们用打车来举例。打车的钱,等于起步价加里程费。起步价固定,坐一公里和坐十公里都要付。里程费才随距离涨。你坐得越远,起步价摊到每公里就越少,但总车费一定更高。
LLM 推理的能耗也是这个结构。而每 Token 能耗(J/Token)本质是把总能耗除以 Token 数,它把起步价也摊进去了。这就是所有误解的来源。
论文为了把这个结构讲清楚,把每一种实测场景都用五个参数来刻画:模型 M、阶段 P、batch 大小 B、上下文长度 C、输出长度 N。后面所有的结论,都是在这个五参数坐标系里得出的,而不是在孤立的每 Token 能耗上。
惊人的发现:表面省电反而结果更费电
有了这个模型作为基础,论文通过一系列在NVIDIA H100和H200 GPU上的实验,揭示了一些颠覆常识的结论。
1. 输出长度(N)的双刃剑效应
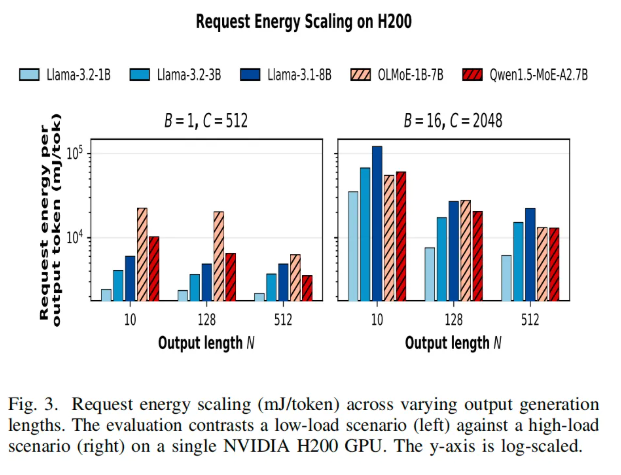
我们通常会认为,输出越长,每Token的平均能耗自然就越低。但论文指出,这种摊薄效应(Amortization)是有条件的。
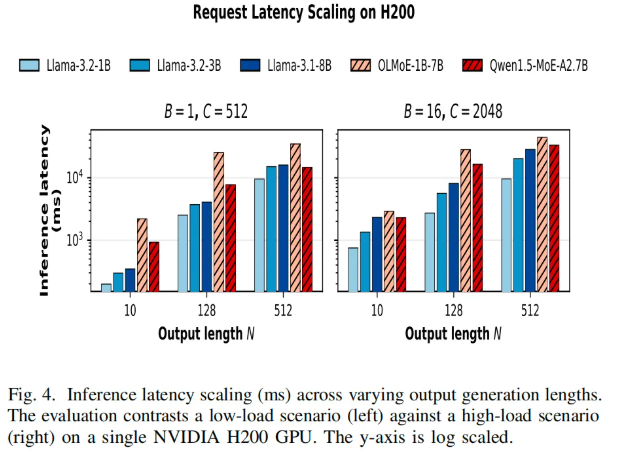
- 低负载场景下的微薄收益 :在低并发(Batch Size = 1)和短上下文的场景下,增加输出长度对降低每Token能耗的帮助微乎其微。这是因为推理窗口的绝大部分都被高昂的固定成本占据,增加几个Token的生成工作,根本无法有效摊薄这笔开销。
- 高负载场景下的显著改善 :在大并发(Batch Size = 16)时,情况则完全不同。此时,GPU的计算资源被充分利用,增加输出长度可以有效地将固定的入场费分摊到更多的Token上,从而显著降低每Token的平均能耗。
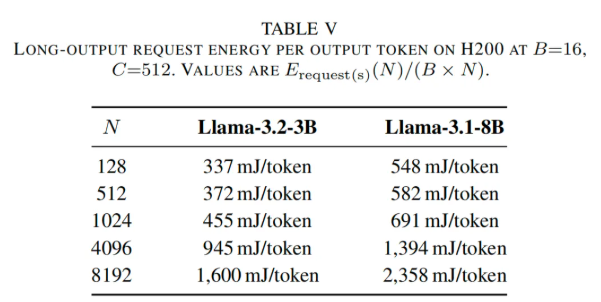
然而, 这种摊薄效应并非无限有效。 当输出长度极长时(如超过1024个Token),维护和读取庞大的KV-Cache所带来的边际成本会急剧上升,最终导致每Token的平均能耗不降反升。对于Llama-3.2-3B模型,当输出长度从128增加到8192时,每Token能耗从337 mJ飙升至1600 mJ。此时,推理进入了边际能耗主导的新阶段。
原因在于,输出越长,KV Cache 越大,每次解码要读的内存越多,单步能耗本身在膨胀。当单步能耗盖过固定能耗,摊薄就失效了。所以输出长度其实切出了两个区间。一个是固定能耗主导,加 Token 能摊薄;一个是单步能耗主导,加 Token 只会更贵。
2. 批处理(B)的优势与局限
批处理(Batching)是提升GPU利用率和吞吐量的经典方法,把多个请求塞进同一个推理窗口,让它们共享一次模型加载和 kernel 启动,理论上能摊薄固定能耗。论文证实,增加Batch Size能有效降低每Token能耗,但同样存在边界。
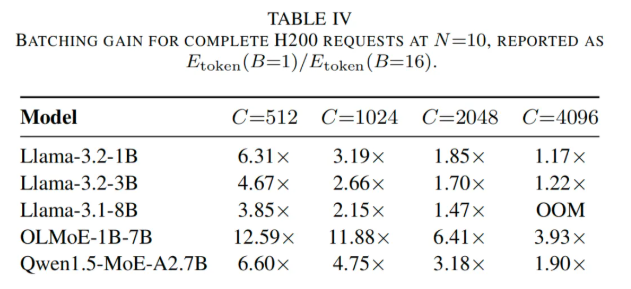
- 上下文长度(C)的限制 :表IV的数据非常说明问题。对于Llama-3.2-1B模型,当上下文长度为512时,Batch从1提升到16,能带来6.31倍的能耗收益。但当上下文长度增加到4096时,这个收益骤降至1.17倍。原因在于,更长的上下文意味着更大的KV-Cache,每次解码步骤需要搬运的数据量剧增。 这使得边际能耗水涨船高,从而压缩了批处理能够摊薄的固定成本空间。
- MoE模型的放大效应 :混合专家模型(MoE)因其计算效率高而备受青睐。但论文指出,MoE模型在低并发时,其复杂的路由和碎片化的专家执行会引入巨大的、与输出长度无关的固定能耗开销,导致其每Token能耗远高于同等参数量的稠密模型。但这种特性在批处理下也带来了更大的收益。当Batch Size增大时,这些开销被有效摊薄,MoE模型的能效优势才开始真正显现。
平台与模式的博弈:H200为何更省电?
论文还对比了在H100和H200两种GPU平台上的能效表现。
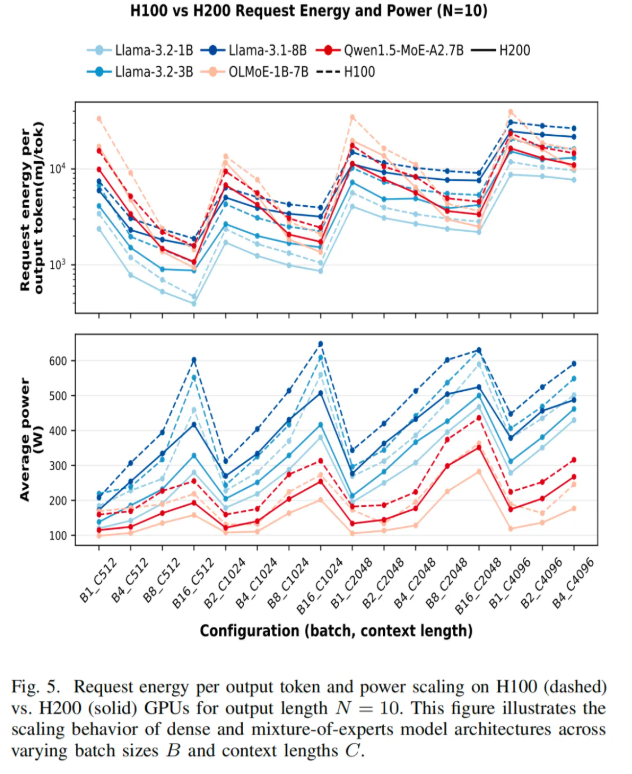
- H200的优势 :实验发现,对于稠密模型,H200相比H100能稳定降低Token能耗(约0.61-0.84倍)。这主要归功于其更高的HBM3e内存带宽(4.8 TB/s vs 3.35 TB/s)。在解码阶段,内存访问往往是瓶颈,更高的带宽能有效降低边际能耗。
- H200的局限性 :有趣的是,在MoE模型的高负载场景下,H200的能效优势会变得不明显,有时甚至能耗更高。这暗示了MoE模型的性能瓶颈可能不完全在内存带宽,而在于其计算模式和调度开销。
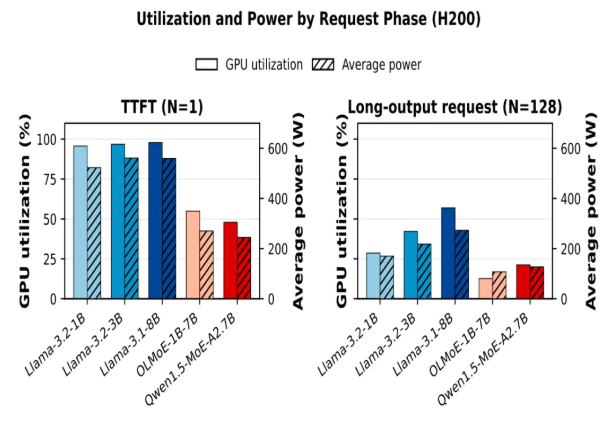
论文还对比了两种极端的请求形态。一种是 TTFT-oriented 请求,就是 N=1、只生成第一个 Token 的场景;一种是长输出请求,比如 N=128。
在 H200 上,batch 4、上下文 2048 时,Llama-3.1-8B 的 TTFT-oriented 请求,GPU 活跃时间利用率高达 97.9%,采样功率 559 瓦。这是一段预填充主导的高密度计算,GPU 几乎全程满载。
同样的模型,跑长输出请求(N=128)时,利用率掉到 56.9%,功率降到 273 瓦。Llama-3.2-1B 更夸张,从 N=1 的 95.7% 利用率、522 瓦,掉到 N=128 的 28.6% 利用率、170 瓦。
论文进一步解释了这种差异:在一个完整的推理窗口中,有相当一部分时间GPU即使没有执行有效的Kernel计算,也处于高功耗的执行空闲(Execution-Idle)状态,这部分地板能量(Floor Energy)在短请求中占比极高。
实践指南
论文最后将视角从微观的能耗测量提升到了宏观的系统设计,并通过一个效用感知推理实验,为实际应用提供了宝贵建议。
1. 效用(Utility) vs. 能耗(Energy)
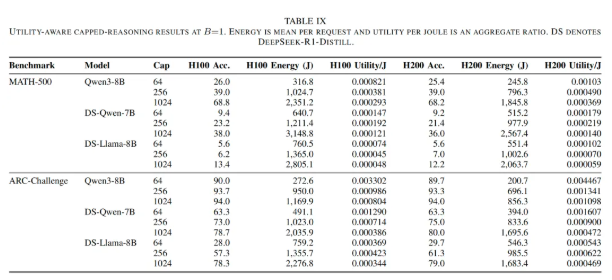
限制DeepSeek-R1等推理模型的思考Token预算,并观察其在MATH-500和ARC-Challenge任务上的表现。
实验结果表明:
- 更多的推理Token不一定带来更高的效用 。在某些任务上,准确率在消耗几百个Token后便趋于饱和。
- 最大化准确率的预算,远非能效最优的预算 。例如,在MATH-500上,Qwen3-8B模型在1024 Token预算下准确率最高,但其每焦耳效用却是64 Token预算下的1/3不到。
- 能效最优的预算因模型和任务而异 。DeepSeek-R1-Distill-Qwen-7B在MATH-500上的效用峰值出现在256 Token预算,而DeepSeek-R1-Distill-Llama-8B在ARC-Challenge上则是256 Token预算最佳。
总结
这篇论文从根本上挑战了我们衡量LLM推理效率的方式。它告诉我们, 仅仅盯着每Token成本是不够的,因为它可能掩盖了总能耗的实际增长,并误导我们做出次优的系统设计决策。 推理服务越来越卷,大家开始拼成本。可如果连成本是怎么算的都没搞清楚,卷的方向可能一开始就是错的。
| 
 学习助手




 订阅