| 编辑推荐: |
文章主要介绍了如何从0搭建一套覆盖Pytest、JMeter、接口测试和SQL检测的AI测试工具箱,通过规范测试设计到脚本落地的流程、建立质量评分与人工复核门禁,解决AI生成代码“能跑但无测试价值”的痛点,并分享了实践中的真实踩坑经验, 希望对你的学习有帮助。
本文来自于微信公众号,由火龙果软件Alice编辑推荐。 |
|
事情是这样的。
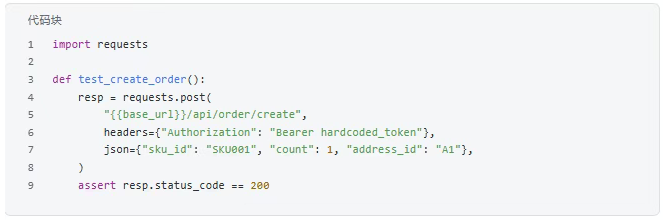
上周我把一个「创建订单」接口丢给 AI,三十秒就吐出一堆 pytest 代码。同事围过来看,觉得挺唬人。
我本地一跑,全绿。
再仔细看,断言只有一行 assert resp.status_code == 200 。Token 写死在脚本里。异常流一个没有。环境一切到预发,路径全炸。
那种感觉太熟悉了。效率看起来拉满,质量其实在裸奔。
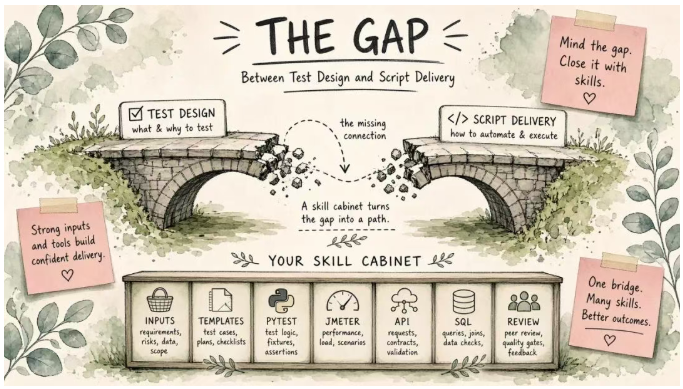
很多测试同学卡的,不是「完全不会自动化」,而是卡在 测试设计 → 脚本落地 这一段断层里。接口文档怎么转脚本、测试点怎么转断言、异常流怎么补齐、压测怎么先出方案、SQL 怎么变成可重复巡检……这些事天天做,却很难标准化。
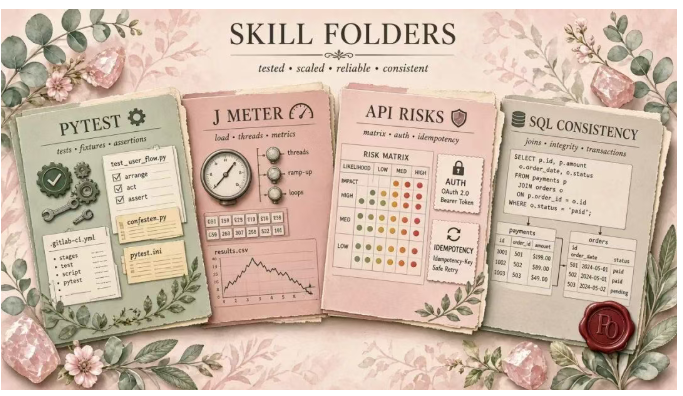
所以这一章我真正想聊的,不是「又一个会写代码的 AI」,而是怎么从 0 搭一套 Pytest + JMeter + 接口 + SQL 全覆盖的 AI 测试工具箱,让 AI 按测试工程规范干活。
也想老实讲讲,效率拉满的背后,我到底踩了多少坑。
一、先把痛点钉死,AI 会写代码 ≠ 会写测试工程代码
坦率的讲,我自己也踩过同样的坑。
直接对模型说「帮我写个创建订单自动化」,它会很勤奋地给你一段能跑的脚本。但测试工程要的东西它往往缺席。
你以为要的是代码。其实要的是这些能力。
接口文档怎么转脚本。测试点怎么转断言。异常流怎么自动覆盖。测试数据怎么参数化。脚本模板怎么统一。SQL 检查怎么脚本化。压测场景怎么结构化。
AI 生成很快,不等于能进仓库。能跑,不等于有测试价值。有价值,也不等于能长期维护。
我后来把标准压成三句话,贴在评审清单最上面。
可维护。 目录清晰、配置独立、公共封装、数据参数化。
断言准确。 不只判断 200,还要覆盖业务状态与关键字段。
异常流覆盖。 参数异常、鉴权异常、业务异常、边界异常都得有。
达不到这三条,哪怕跑得再快,也只是漂亮的噪音。
工具箱不是四个散装 Prompt。它是一套把「人的测试判断」固化进目录、模板、评分、复核门禁的工作方式。
二、工具箱总骨架,先建七个抽屉再谈生成
很多人一上来就问「Prompt 怎么写」。我觉得顺序反了。
先建骨架。骨架不对,后面生成得越多,越乱。
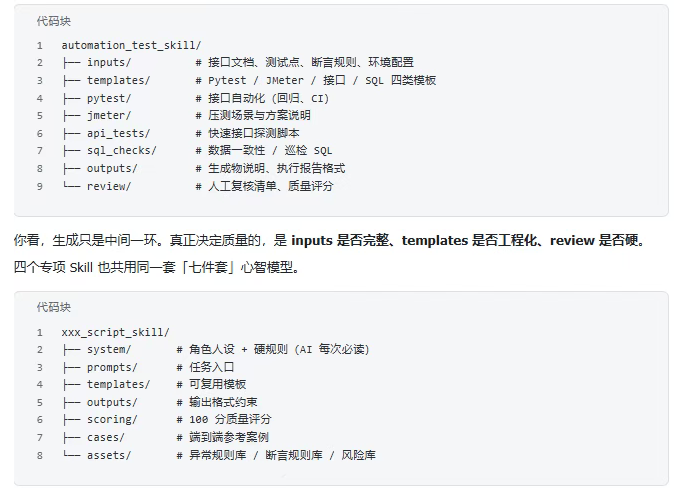
统一工作区我习惯叫 automation_test_skill/ ,七个抽屉各司其职。
说真的,这套抽屉比任何「神级 Prompt」都管用。因为你把测试人的经验,从聊天记录里挪进了可提交的仓库资产。
三、八步转换链路,跳一步就容易返工
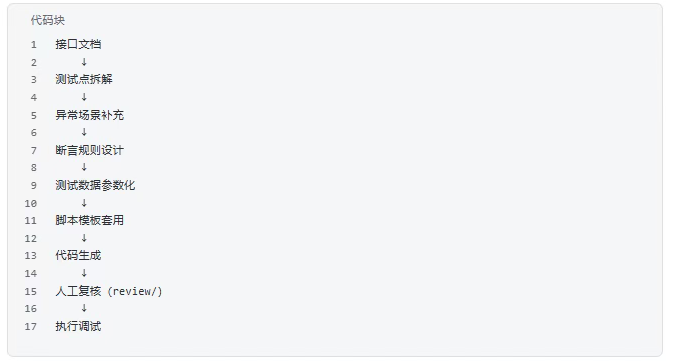
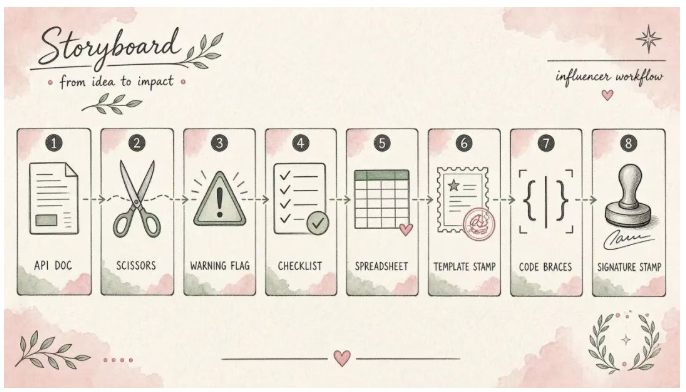
四大 Skill 表面技术栈不同,底层转换逻辑几乎一样。我把它写成八步,写进 conversion_workflow.md ,强制自己和 AI 都按这个走。
最容易被跳过的,是中间那几步。异常场景补充、断言规则设计、参数化。一跳,生成物就会退化成「能发请求的脚本」。
人机分工我也写死了。
AI 适合干的。按模板套结构、补异常清单、生成参数化数据骨架、输出统一格式、先做 scoring 自评。
人必须干的。确认业务规则对不对、断言有没有测到真风险、压测会不会打坏库存、危险 SQL 绝不能直接跑、合入仓库前签字。
AI 是加速器,不是签字人。 这句话我希望屏幕前的你也贴在显示器边上。
四、Pytest Skill,把「能跑」升级成「能回归」
为什么从 Pytest 开始?因为它最容易伪装成「已经自动化了」。
4.1 低质量 vs 专业断言,一眼就懂差距
低质量产物通常长这样。
它看起来很干净。问题也正好藏在干净里。Token 写死。URL 写死。只验 HTTP,不看业务 code,不看订单状态。不碰数据库。
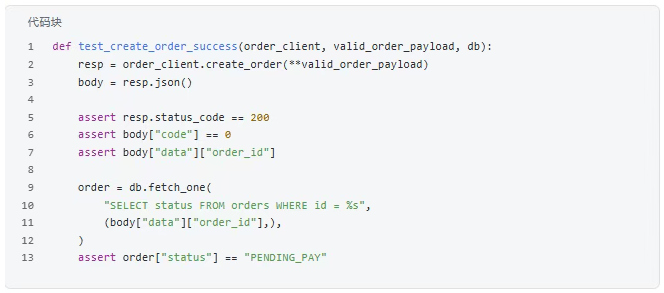
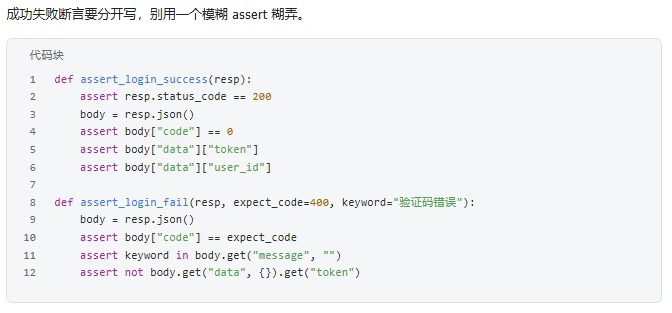
更专业的方向应该是这样。
同样是「创建订单」。一边是演示。一边是能进回归门禁的资产。
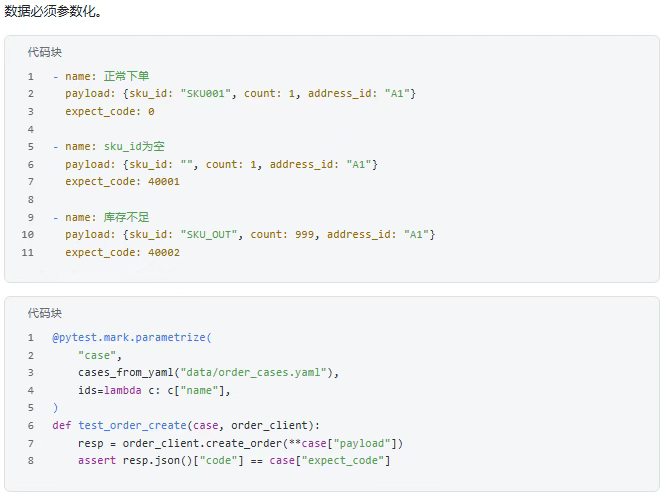
4.2 目录、封装、参数化,三位一体
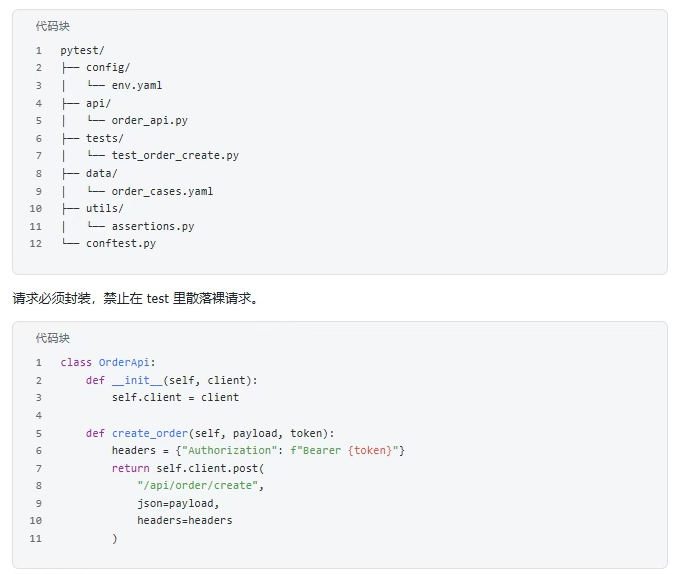
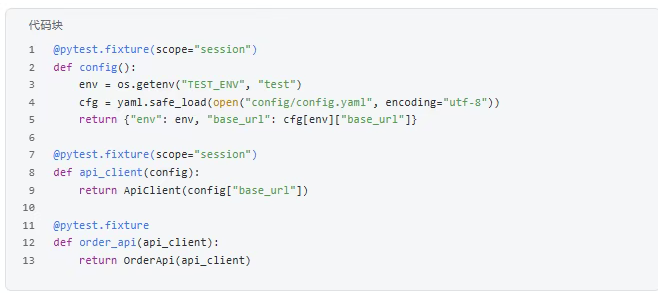
生成后的工程我建议固定成这个形状。
fixture 负责环境与依赖,而不是每个用例自己造轮子。
断言也要分层。HTTP → 业务 code → 关键字段 → 业务状态 → 可选 DB。缺一层,线上真问题就容易漏一层。
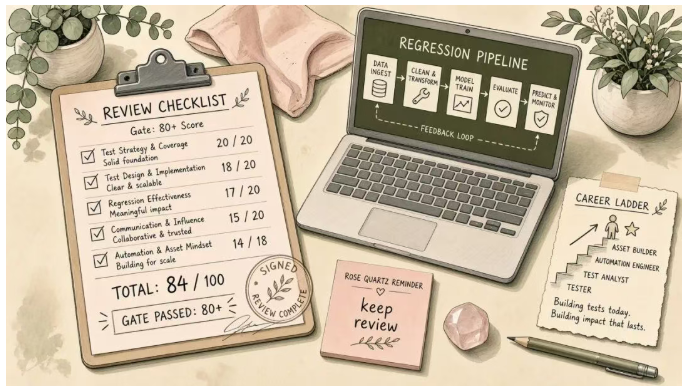
Pytest Skill 的 scoring 我按五维各 20 分。请求封装、参数化、断言完整、异常覆盖、fixture/配置。低于 80 分,不允许当「可交付」输出。
这块需要注意一下。一开始你会觉得建目录、写 system、写 assets「比直接生成慢」。是的。但慢在前面,快在后面。第二、第三个接口开始,你会明显感觉到复利。
五、JMeter Skill,先方案后脚本,否则效率是假的
压测这块我踩过更疼的坑。
有人直接让 AI「生成一个 500 并发的 jmx」。文件是有了。线程组乱、没有 Ramp-Up、没有 CSV、断言只看 200、正式压测还开着查看结果树。一压,监听器先把施压机干趴。
所以 JMeter Skill 的铁律只有一句。
先方案,后 .jmx。
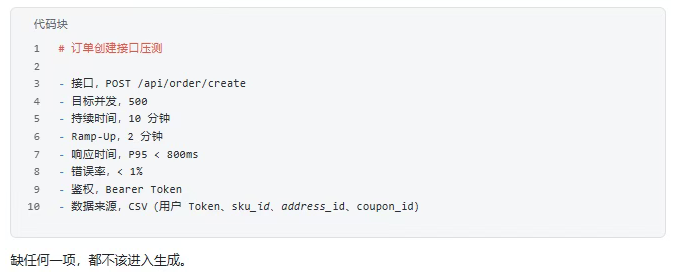
5.1 压测需求必须写全
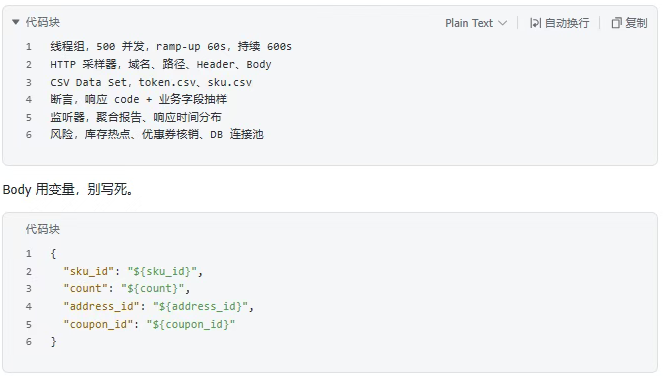
CSV 行数要 ≥ 并发数,避免数据互相踩。
断言至少覆盖响应码、业务成功字段、关键时长。正式压测关闭查看结果树,只留聚合类监听器。
并发估算可以参考 Little 定律思路,但落地时必须结合真实基线。基准跑 5–10 分钟,稳定性至少 30 分钟。更重要的是人工确认。库存会不会被打穿。订单表会不会污染。有没有压测许可。
这块我始终坚信。性能测试的危险,不在脚本写不出来,而在你「很高效地把生产打出事故」。
六、接口测试 Skill,价值在「自动补齐风险矩阵」
接口 Skill 和 Pytest Skill 容易被混为一谈。我自己的分工是这样。
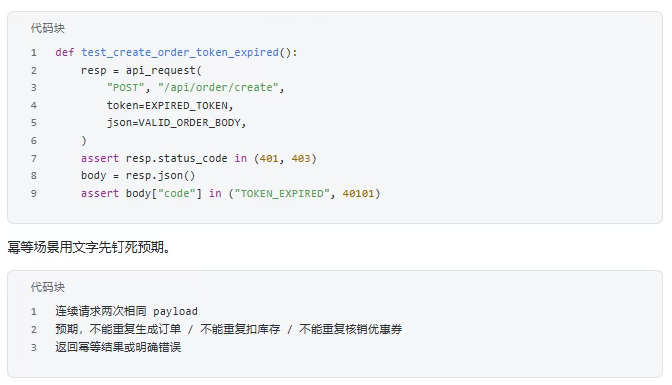
接口 Skill 负责把接口文档扩成 测试矩阵 。正常流、异常参数、鉴权失败、Token 失效、越权、重复请求幂等……先把「该测什么」铺满。
Pytest Skill 负责把矩阵落成 可维护工程 。封装、参数化、fixture、环境、报告。
你可以把接口 Skill 想成「测试设计加速器」,把 Pytest Skill 想成「工程落地加速器」。
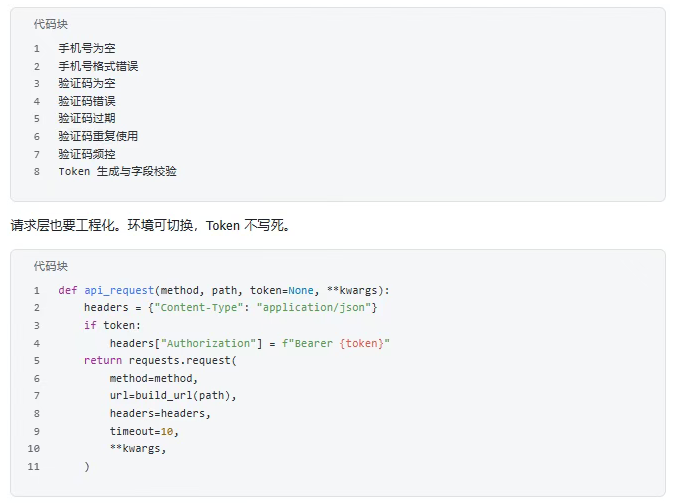
登录接口至少要自动想到这些异常流。
Token 失效和幂等,是很多人「效率拉满」时最爱漏的。
接口 Skill 的 outputs 我建议固定成多段结构。解析表、场景清单、脚本、断言、风险说明、scoring……结构一固定,团队评审才有抓手。
七、SQL 检测 Skill,把「救火经验」变成巡检资产
支付成功但订单还是未支付。这种单,测试人半夜见过一次就忘不了。
问题是,经验如果只活在某个人脑子里,下次还得重新查、重新拼 SQL、重新解释给开发听。
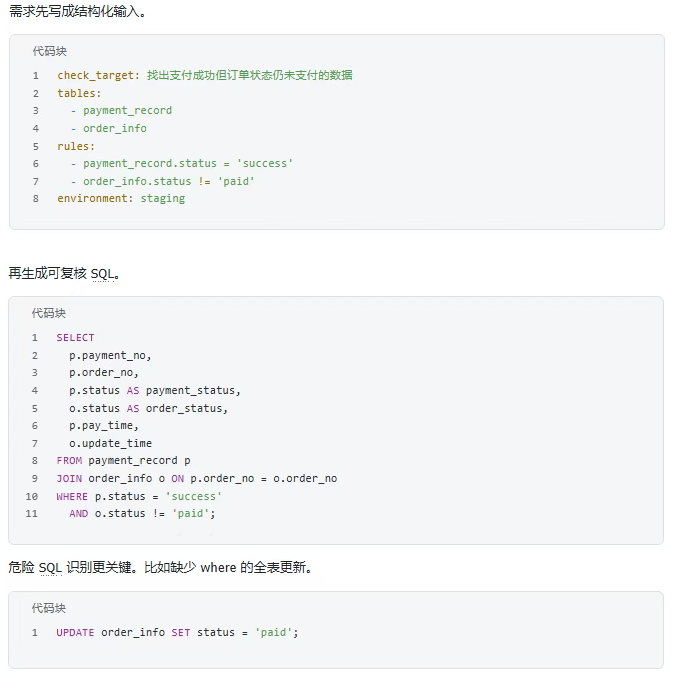
SQL 检测 Skill 要解决的,就是把数据核对经验脚本化。
7.1 七步检测流
AI 必须标成 P0 ,禁止直接执行,必须人工确认并补 where / limit。产线只允许 SELECT。这条是红线。
巡检报告至少包含这些字段。检测时间、环境、目标、SQL 原文、异常数量、脱敏样例、风险等级、影响模块、处理建议、人工复核点。
你会发现,SQL Skill 的「效率」不是少写几句 SQL,而是少经历几次「同样的数据事故换个人又不会查」。
八、效率拉满的背后,我真实踩过的坑
这块我想讲得难听一点。因为很多教程只秀结果,不秀伤疤。
坑 1,把演示脚本当工程资产。 能跑通不等于能合入。Token 写死、URL 写死、无参数化,三个月后没人敢动。
坑 2,断言只验 200。 业务已经失败了,脚本还在报喜。这是最危险的假阳性。
坑 3,异常流靠灵感。 灵感不稳定。必须沉淀 assets/ 规则库,让 AI 对照补齐。
坑 4,压测先出 jmx。 没有指标、没有风险、没有数据隔离,脚本越完整越危险。
坑 5,正式压测开查看结果树。 监听器先成为瓶颈,你却以为是被测服务不行。
坑 6,SQL 生成完就执行。 缺少 where 的更新、未脱敏的样例、prod 可写账号,都是事故燃料。
坑 7,没有 scoring 和 review。 没有门禁的生成,最后一定变成垃圾场。
所以工具箱真正贵的地方,不是四个 Skill 名字好听,而是你愿意把 评分、清单、人工复核 做成习惯。
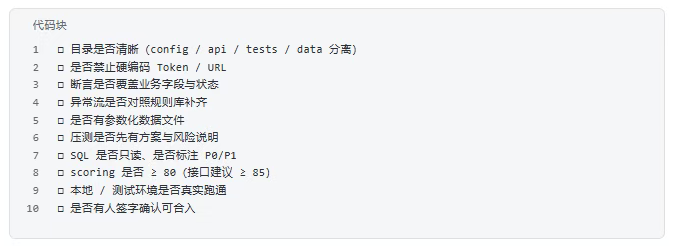
一个可复用的评审清单,建议至少勾这些。
九、落到日常,怎么把它变成测试人的职业资产
你如果只是收藏文章,收益几乎为零。
更有效的做法是,选一个你们组这周真实在测的接口,按最小闭环走一遍。
今天。建 automation_test_skill/ 七个抽屉,把该接口文档丢进 inputs/ 。
明天。用接口 Skill 扩出异常矩阵,再用 Pytest Skill 落成可跑工程。
本周。挑一个读多写少的查询,用 SQL Skill 做一致性巡检,输出带 P0/P1 的报告。
下一次回归。把 scoring ≥ 80 的脚本挂进你们已有的回归门禁,而不是继续躺在聊天记录里。
对测试人的职业价值,我自己的感受很直接。
以前你的价值常常被误解成「点点点」。现在你能交付的是 可复用的测试工程资产、可评分的生成规范、可解释的风险报告 。同样面对 AI,别人在要一段代码,你在沉淀一套团队能接手的工作流。
这不是玄学。这是把重复劳动产品化。
回到开头那个「三十秒全绿」的脚本。
它不是没用。它证明了生成速度已经不是瓶颈。
真正的瓶颈,是你有没有勇气承认,效率拉满的背后,缺的是规范、门禁和复核。
工具箱搭起来之后,AI 依然会犯错。但你会更快发现它在哪一步偷懒,也更知道自己该在哪一步签字。
大时代啊,朋友们。测试人真正该抢的,不是谁生成得更快,而是谁把质量标准写进了可执行的系统里。
把这套目录、八步链路、四个 Skill、三道质量门,收进你自己的仓库。下次再有人甩给你一句「让 AI 写一下脚本」,你可以很平静地回一句。
可以。先过 inputs,再过 scoring,最后过 review。
| 
 学习助手




 订阅