| 编辑推荐: |
本文主要介绍了英伟达开源了
Agent 效率框架 SoL-Pi,它不换模型也不精调提示词,而是让 AI 通过"递归自动研究循环"自主优化包裹模型的
Harness(工具、上下文、日志等),从而在几乎不损失能力的前提下省下 45%~49%
的 Token 和约三分之一的成本。希望对你的学习有帮助。
本文来自于微信公众号模智空间,由火龙果软件Alice编辑推荐。 |
|
过去两年,提升AI编程Agent效率的常见思路是:换更强模型、写更好的提示词、堆更多上下文。但一个问题越来越明显:它们每走一步都在烧钱,Token
就是算力账单上的金额,上下文越长、步骤越多,账单越吓人。
NVIDIA的SoL-Pi给了另一个答案:不换更大的模型,也不精调提示词,而是让AI自己动手优化Harness,就能省下
45%~49% 的 Token、约三分之一的成本,同时几乎不损失任务能力。SoL-Pi并不是完全从零开始搭建,而是基于开源的Pi框架做的扩展优化,其核心设计是让Agent自主研究如何去优化自身的
Harness。
能干的 AI,吓人的账单
过去几年,编程Agent的进化曲线又短又陡。它们从只会看代码进化到能根据反馈行动、修改自己周围的工具(对应两篇关键论文:Codex
初代与SWE-bench时代),再到像 Cursor 展示的那样自动驾驶整个代码库。到了这个阶段,一个Agent可以在无人监督的情况下连续跑几小时甚至几天,自主定位问题、修改代码、运行测试、修复报错。
听起来很美好,但一个基本问题随之而来:在这样漫长的自主运行里,每一个Token都在推动工作前进?还是说,冗余会随着轨迹变长而不断累积?
答案往往是后者。一个写代码的Agent在长任务中会反复烧掉Token的地方非常多,比如重复的系统提示、冗长的工具接口说明、反复回放的文件
diff……这些浪费单看一次都不起眼,但在几小时的长任务里会被反复放大。
现如今,行业把“让AI改进AI(递归自我改进,RSI)”当成下一个方向,Anthropic有专门的研究所,OpenAI的Codex系列也在朝这个方向走。但RSI本身极其烧钱:每一次尝试,无论成败,都要花
Token。 那么问题就变成了:在把RSI做大之前,是不是应该先让AI学会省着点花?
过去很多年,行业对效率的理解很单一:要么写更好的提示词,要么换一个更大、更强的模型。SoL-Pi
关注的不是换一个更聪明的模型,而是让现有模型少做无用功。SoL-Pi 的做法是用递归自动研究循环,自动生成对Harness的修改方案,比如观察过滤器、规划深度、日志策略、上下文组装方式,然后用受控试验对比改前改后,只留下真正有效的改动。不断积累这些小改进,最后汇成可观的节约。
SoL-Pi 的工作流程
SoL-Pi搭了一条流水线,先提出 152 个方向,经过自动研究循环,最终只有
4 个机制存活下来。虽然大多数想法失败,但广度搜索让少数真正有用的机制被发现。
第一关,广撒网:第一轮共提出 152
个候选改进方向,覆盖六大类,包括上下文管理(C)、进度控制(P)、工具使用(T)、委派(D)、提示词与策略(R)、改进与评估(M)。
第二关,预筛:在真正花试验预算之前,一个叫Oracle的分析阶段先用已有的轨迹估算每个方向的潜在收益,把明显不值得做的方向筛掉。
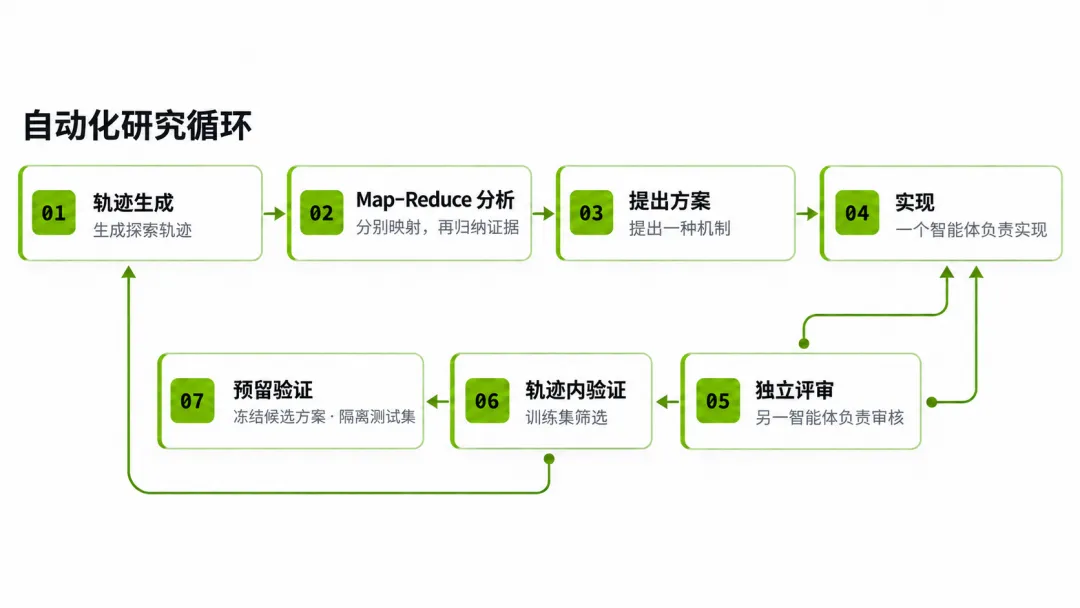
第三关,并行研究:每个幸存的方向进入一条独立的自动研究线。线内的循环是:先生成探索轨迹
→ 用Map-Reduce并行分析多条轨迹、合并证据 → 提出一个具体机制 → 由一个Agent实现
→ 由另一个Agent评审 → 通过双重验证。
第四关,残酷淘汰:最终只有4个机制活下来,成功率大约是每40个想法活1个。
这套流程里有几个值得细说的设计:
一是双人复核式实现。 实现环节不是让Agent一把梭,而是实现者与评审者分离:实现Agent迭代修改直到显式退出条件满足,另一个Agent检查实现是否符合行为契约,不合格就打回重改。
二是验证的严格隔离。 候选机制先在训练集上筛选,冻结之后才在完全隔离的留出集(EdgeBench,51
个长时任务)上终测。留出集的轨迹绝不进入后续分析,任何Agent都看不到留出结果,这保证了最终得分证明的是泛化能力,而不是背题能力。
三是能力下限红线。 这是整个研究里最重要的一条原则:省钱可以,但禁止靠少干事来省钱。
一个候选如果靠提前停止、跳过必要验证、删掉完成任务必需的证据来省Token,直接淘汰。每个机制通过两个门槛:所有能力指标必须在预先声明的容差内,且至少一项效率指标有改善。正因如此,四个机制叠加后,SoL-Pi在EdgeBench上保留了
Pi 基线约 94% 的平均得分,它省下的每一分钱都不是偷工减料换来的。
为了支撑这么大规模的研究,团队还建了535个可执行的训练环境,其中495个来自
GitHub 的issue-PR真实配对(用issue当任务、用被接受的补丁当标准答案,把仓库恢复到修复前一刻,并扣住PR和回归测试不让Agent看),另外40个是验证器驱动的合成任务(先定义可执行的验证器,再围绕它搭建开放式探索环境)。而EdgeBench的数据和验证器被严格排除在搜索之外,只用于最终考试。
活下来的四个机制,个个都是省钱大师
这4个机制别对应工具、上下文、观察和多Agent委派。
1. 动作融合(Action Fusion):一步到位,少一次来回
编程Agent有个高频动作模式:改完一个文件,紧接着跑测试或构建命令验证。传统流程里,改文件是一次模型决策,发命令又是一次模型决策,中间夹着一整轮模型思考
+ 往返传输。动作融合把这两步压进一个工具调用,Harness 在本地完成编辑并直接执行命令,然后一次性返回合并后的观察结果。省掉的是中间那轮模型决策,等于同时省Token和延迟。
2. 在线上下文压缩(Online Context Compact):干完一桩,清一桩
大模型的KV缓存复用机制通常倾向于能拖就拖,把上下文压缩推迟到很晚,结果上下文里堆积了大量已经完成任务的残留内容。SoL-Pi
换了一个时钟:把任务拆成子任务,每完成一个子任务就把它当作一个潜在的压缩点,重新评估是否值得压缩。但它不会盲目压缩,只有当未来节省能偿还重写成本时才行动。一句话:在任务边界及时瘦身,而不是憋到最后。
3. 观察打包(ObservationPack):归档,删除重复
这是最直观的浪费,一个大文件或一大段工具输出,会在之后每一次请求里原封不动地重复出现,同时占掉上下文和缓存。ObservationPack的做法是把这个大载荷存档到本地,上下文里只留一个稳定的稳定句柄和短摘录;模型真需要看具体内容时,再按页精确取回。这样既保留可访问性,又不再反复回放。
4. 精简器(Evidence-Preserving Reducer):让便宜的小模型先读,但摘要必须能对账
在构建和测试的长日志里,往往只有几行真正决定了下一步。传统做法是让主模型硬读整篇日志,或者让一个摘要Agent读完再转述,但转述不可信,你不知道它有没有漏关键信息。精简器的做法是把第一次阅读委派给更便宜的Agent,让它产出一份精简的诊断回执,但这份回执里的每一行引文,都必须能对着存档日志逐字验证,验证通过后才呈给主模型。
这4个机制单独都是小改进,但组合起来最终把 Token 和步骤数双双推向接近减半的水平。
到底省了多少?
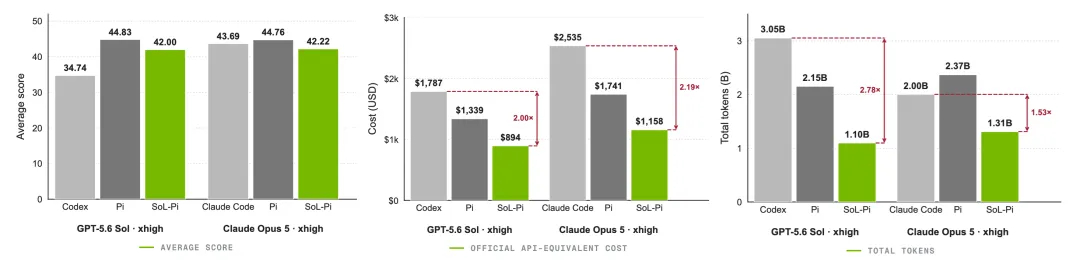
EdgeBench(51个长时任务,每个任务跑 2~12 小时):
- 相比 Pi 基线:Token 减少 45%~49%,成本大约降三分之一;
- 相比各模型自带的原生Harness(Codex、Claude Code 等):Token
减少 35%~~64%,按标价计算的 API 成本低 50%~~54%;
- 能力方面:保留 Pi 约 94% 的平均得分;在 GPT-5.6 Sol 后端上,甚至超过了该模型原生Codex
Harness 的成绩。
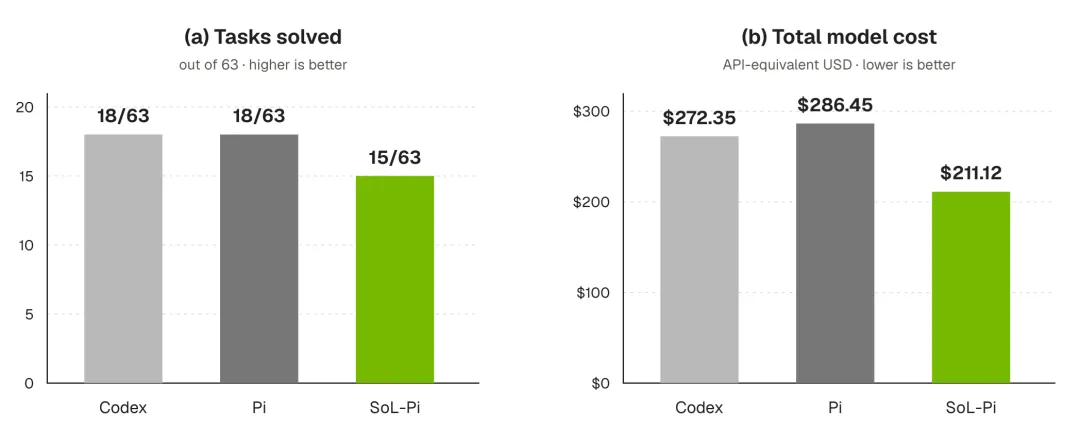
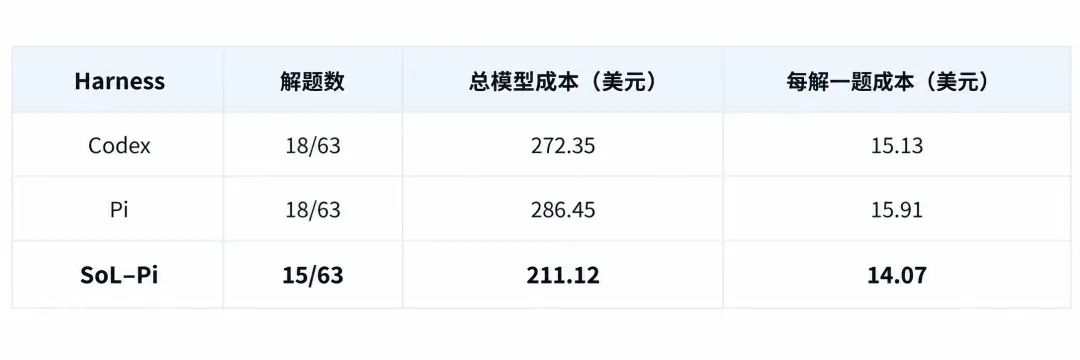
Terminal-Bench 4(63 个纯 CPU 任务):
注意这里有小细节:SoL-Pi解出的题数(15)少于Codex和Pi(都是
18),这正是能力下限原则的体现,它没有为了省钱而保解题数,但把总成本和单题成本都压到了全场最低。
20-Agent群体实验(一个更接近真实团队的场景):
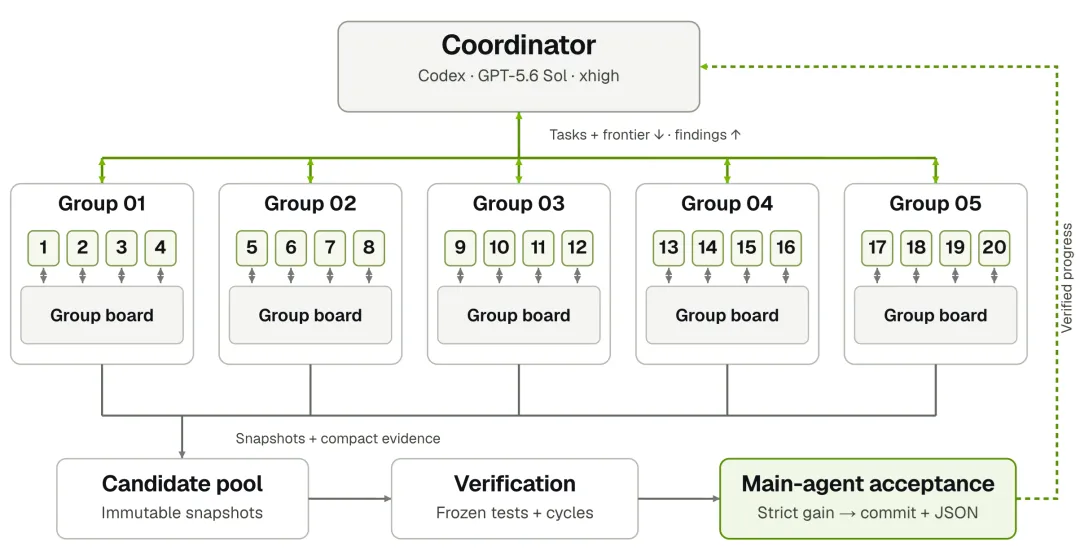
一个主协调Agent指挥20个worker Agent,分 5 组并行搜索,限时
2 小时。结果很有意思:
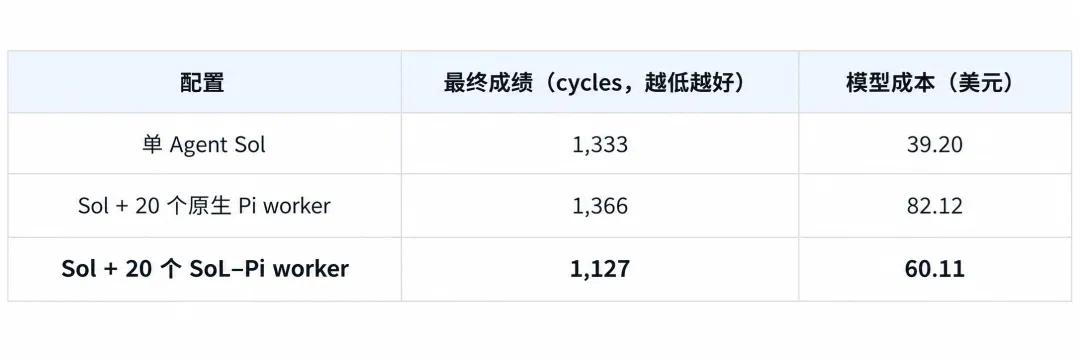
SoL-Pi 群比原生 Pi 群少花 17.5% 的算力、省下 26.8%
的成本,成绩反而更好。而一个反常识的发现是,更多的Agent并不等于更好,原生Pi群比单Agent贵了一倍多,成绩却还差一截。只有会省钱的
Agent群才真正买到了性价比。
对专业研究者个人来说,在单个问题上,SoL-Pi 相对原生Codex
/ Claude Code Harness 每小时省 8.75~13.50 美元,相对Pi每小时省
4.36~5.71 美元。跑一天,就是一顿饭钱;跑一个项目,就是一份预算。
SoL-Pi的意义
对工程团队:把省钱变成一套可落地的制度
SoL-Pi对工程和产品团队最大的启发是,别把省钱当成事后才想的优化,而要把它当作像可用性、延迟一样正式的指标来管,官方给出的落地路径很具体:
- 第一步,先埋点,再优化。按角色(系统、用户、工具、助手)分别统计Token用量、每轮延迟、工具调用的字节数、pass@k成功率。没有测量,就没有优化。
- 第二阶段,小步快跑的三期实施:第一期做观察增量+工具 schema
精简;第二期做日志采样脱敏 + 重复轨迹清理;第三期做自适应规划深度 + 提前退出检查。
- 每一期都设硬性门槛:比如成功率不倒退,Token 至少降
15%,P95 延迟至少降 10%;准备好回滚开关和漂移告警。
- 最重要的习惯:把优化当作 CI/CD。自动生成改动、跑受控试验、留下赢家、把改动的来龙去脉写进轨迹用于合规审计。
对行业:一场模型外效率的军备竞赛
SoL-Pi 的意义不止于省了多少钱,它揭开了一个更广的趋势:优化层正在成为标准配置。
未来,位于 Agent、工具和上下文存储之间的效率层,比如Harness 分析器、schema 编译器、自动调参会成为每家供应商的标配,而且这些优化可以跨模型家族迁移。
这对产业链上每一方都意味着位置的变化:
- 对买家(工程团队)来说,多了一个不依赖模型选型的ROI杠杆,也更容易走多模型策略,不再被绑死在某一家模型上。
- 对基础模型厂商来说,门槛提高了,新模型必须打败一个调优良好的Harness模型升级的有效增益会被重新定义。
- 对研究社区来说,模型外效率本身成了一个新赛道,Harness
编译器、观察规划器、上下文压缩器……这些都会成为下一代基础设施。
效率优化不是没有代价,SoL-Pi 把风险列得很清楚:
- 激进裁剪可能藏住边缘信息,导致静默失败,模型看似正常,其实漏掉了关键线索;
- 过度拟合基准套件,会造出图表很漂亮、生产环境一碰就碎的脆弱系统;
- 日志脱敏过度,事故发生时可能查不到原因;轨迹压得太短,可复现性会受损。
对应的治理措施也很具体:维护任务多样化的金丝雀测试;在 pass@k之外同时度量人工返工率;按任务类型设定最低观察下限;优先做结构化脱敏而不是一刀切截断;在模型输入之外保留一份完整保真的安全审计轨迹。优化要激进,但绝不能拿可复现性、审计需求、成功率稳定性去换。
展望
SoL-Pi 最有想象力的部分在最后——效率本身会递归。
团队已经在做两件更超前的事。
其一是预训练Harness:让系统自己收集或合成任务、搭建环境、收集轨迹、验证候选、更新自己的
Harness,即在部署之前,用不断扩大的自生成任务流来喂养Harness 搜索。他们预期会出现一条类比模型的Harness
规模定律:算力和环境多样性越大,Harness 越强。
其二是效率的最大化(efficiency for efficiency):一个更省钱的Harness,会让研究下一个更省钱的
harness这件事本身更便宜,同样一笔预算能覆盖更多环境、更多轨迹、更多研究想法。于是效率既是研究的结果,又是扩大下一轮研究的资源。
这也把人类的位置问题重新摆上台面:当 AI 开始改进自己周围的机器,人类该站在哪里?
SoL-Pi 的答案是混合循环:人类提供早期先验、过滤低价值方向、在候选存活后审查并重构实现;而一旦某个想法进入自动研究循环,中途完全不需要插手。
| 
 学习助手




 订阅