| 编辑推荐: |
文章以轻量级推理框架 Nano-vLLM 为例,结合请求处理流程、核心模块(LLM Engine、Scheduler、Model Runner、Block Manager)及关键代码分析,帮助读者快速构建对 LLM 推理框架知识体系的整体认识, 希望对你的学习有帮助。
本文来自于InfraTech,由火龙果软件Alice编辑推荐。 |
|
在学习主流的vLLM、SGLang推理框架时,由于其代码量通常超过十万行,对新手而言理解起来门槛较高。那么, 如何快速入门推理框架 ?我们可以借助一些轻量级框架(如Nano-vLLM、mini-SGLang)作为学习的起点,能显著提升学习效率。在《Nano-vLLM架构介绍》[1] 中,笔者已对Nano-vLLM的整体架构进行了简述,本文将在其基础上做进一步的详述,同时结合请求处理的示例,带读者快速构建对推理框架知识体系的认识。
Nano-vLLM是一个整体性的代码库,各模块之间存在一定的依赖关系,部分原子功能难以独立运行。为了便于学习,笔者对框架中用到的关键函数进行了解耦,并将其整理为可独立运行的Notebook示例,作为本文的配套演示。
1 请求处理的基本流程
在介绍推理框架的具体模块之前,我们先了解推理框架处理请求的基本流程,即框架是如何接收一个请求数据并最终返回结果的。其中涉及两个基础问题:一是序列(sequences/prompts)的编码过程,理解这一过程有助于理清数据之间的关系;二是Token的KV cache显存分配问题,即Attention计算所需的KV cache应以何种形式组织。
序列的编码过程
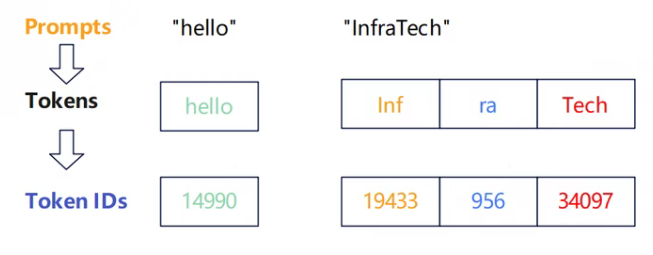
LLM的输入请求序列需要经过编码才能被模型运算,这个过程将prompt转换为token ids。编码中生成的token ids个数及具体数值与分词器(tokenizer)及其配置有关。以Qwen3的分词器为例,下面词组经过tokenizer处理后得到不同的token ids,例如“hello”仅对应一个id,而“InfraTech”则对应三个ids。
Token的KV cache显存分配
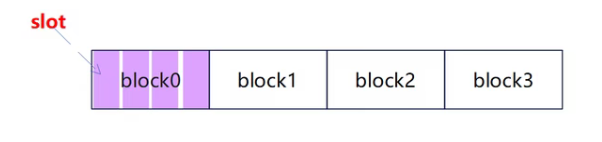
每个token id在Attention计算中所占用的显存量是相同的。通常我们用slot来表示单个token消耗的显存资源,多个slot构成一个block。为了方便KV cache的管理,我们会将连续的一段显存划分为多个block,为请求分配显存资源时,也以block作为基本单位。
如下图所示,将一段显存划分为4个blocks,每个block包含4个slots。这整段显存最多可以支持一个长度为16个token ids的序列进行计算。
单个请求一般形态
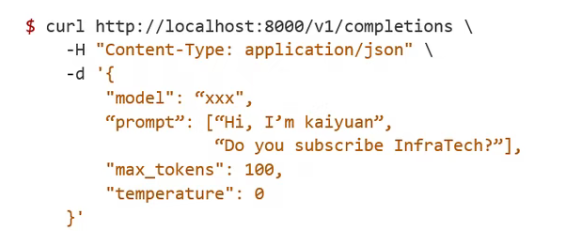
在部署推理框架后,我们通常接收的请求格式如下所示,其中prompt数组为多条请求的集合,示例中给出了两条请求。
关键步骤
推理框架在处理请求时,数据处理的大致步骤如下(以下结合上述示例进行讲解,过程中不考虑特殊token,如起始符号):
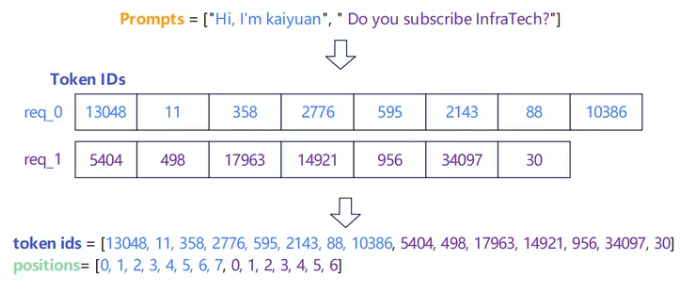
Step1:文字转token ids (Tokenization)。多个请求会拼接成一个数据(组成batch)。下图中,tokenizer按照Qwen3的模型配置计算得到token ids。
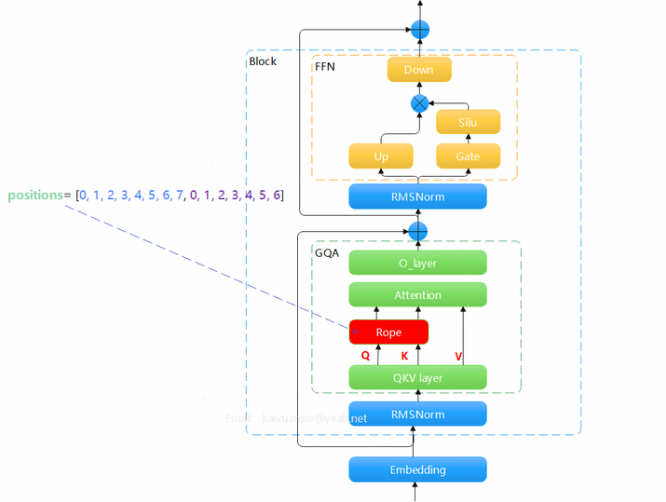
本步中会使用positions为请求的token ids序列进行编号,该数据主要在计算旋转位置编码时使用,因此prefill阶段和decode阶段传入的positions存在较大差异。
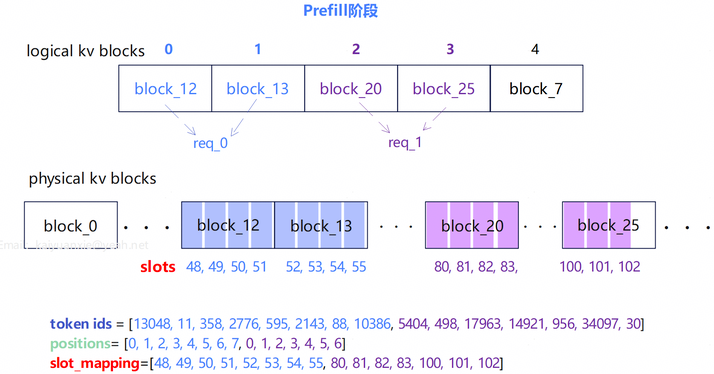
Step2:prefill阶段 。通过“block管理”分配逻辑块并计算slot。为了降低显存碎片,框架中采用两层结构来管理显存分配:
- 逻辑块(logical kv blocks):块与块之间可通过链表管理,以保证逻辑块使用的连续性。
- 物理块(physical kv blocks):实际存储数据的块,通过预先开辟一整段显存来构建。
逻辑块与物理块之间通过一个块表(block table)完成映射,实现逻辑块与物理块的一一对应。通常情况下,逻辑层分配的块是连续的,但物理块的分配不一定连续。在示例中,block size设置为4(即每个 block 包含 4 个 slot)。按照逻辑块中空闲block的顺序,会为请求0分配前两个block(序号0、1),然后为请求1分配两个block(序号2、3)。
物理块中每个slot的数据位置是全局唯一的,可以通过块编号和token在块内的相对位置计算得出:
𝑠𝑙𝑜𝑡=𝑏𝑙𝑜𝑐𝑘𝐼𝐷∗𝑏𝑙𝑜𝑐𝑘𝑆𝑖𝑧𝑒+𝑙𝑜𝑐
例如,请求1的最后一个字符为“?”,对应的token id是“30”,该token在最后一个block中的相对位置为2,则其slot序号为:
25∗4+2=102
在本阶段,model完成前向运算后,会相应地更新物理层的KV cache数据。
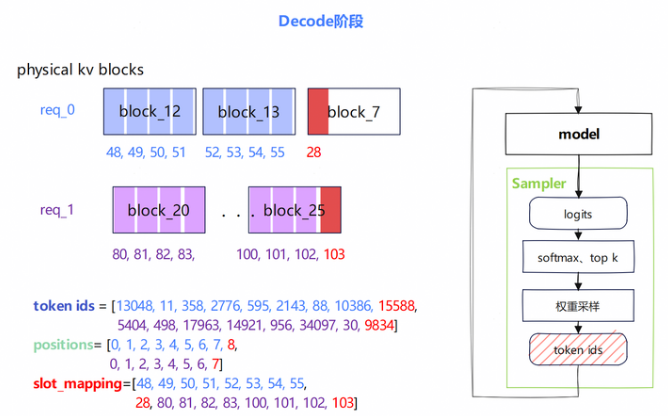
Step3:decode + sampling阶段 。本阶段为新token的生成阶段,KV cache数据会逐轮迭代生成,请求分配的blocks也可动态增加。例如示例中的req_0,在第一轮迭代生成时,管理层会再分配一个block来装载新的KV cache数据。
新的token ids的生成过程为:先经过model计算,再由sampler采样得到。采样过程中可以设置随机性,因此即便输入相同,生成的token id也可能不同。
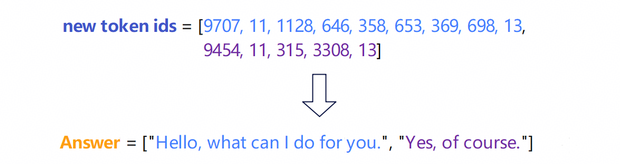
Step4: 将token ids还原成词(De-Tokenization) 。生成的token ids需经过解码得到具体的输出词汇,这些输出最终通过请求响应返回给用户。
数据转换的演示代码参考:nano_vllm.ipynb [2] 第1节
2 Nano-vLLM框架详解
为什么需要一套推理框架?在《 vLLM不知如何开始?看这篇:vLLM框架快速入门引导 [3] 》的第1节中曾讨论过此问题,结论是传统的方式已无法满足当前大语言模型(LLM)的推理需求,需要有一个专门的推理引擎来完成 高效的请求调度与资源分配 。
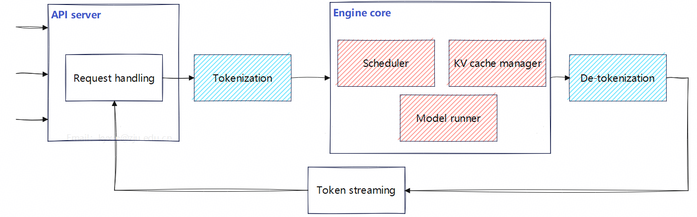
为实现这一目标,一套推理框架通常需要包含以下几个关键模块:
- 调度器( Scheduler ):负责处理多个请求之间的调度与协同问题;
- 显存管理( KV cache manager ):负责为请求分配KV cache所需的显存资源;
- 执行器( Model runner ):负责执行模型的具体计算。
推理框架示意图
一般会使用引擎核心(Engine Core)来承载关键模块,作为推理框架的主体。Nano-vLLM是一个轻量级的推理框架,实现了LLM推理所需的基本功能(当前不具备生产级部署能力),其框架主体简单清晰,非常适合用来了解推理框架的运作。下面将对它展开介绍。
2.1 架构图概览
Nano-vLLM实现了PagedAttention、Continuous batching、Prefix caching等特性,同时支持在单节点内以张量并行(Tensor Parallelism,TP)方式运行。代码总量约1.2k行,Decode阶段支持CUDA Graph。代码库采用纯Python实现,不涉及CUDA c++编译。
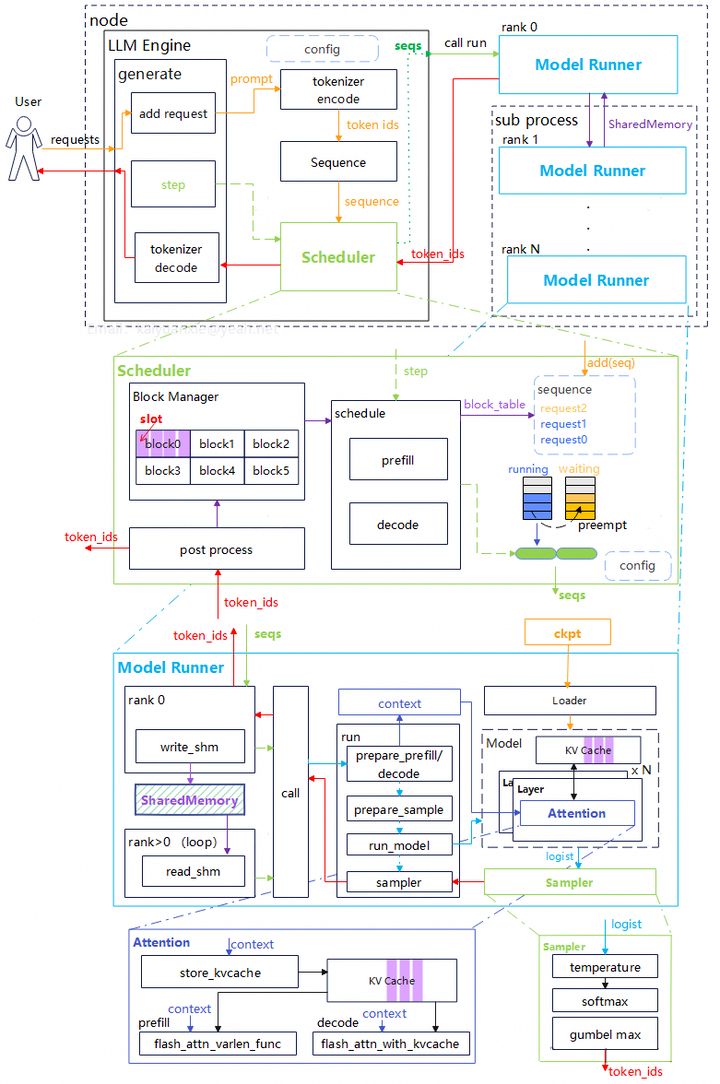
整体结构如下图所示:
关键组件:
- LLM Engine :创建推理服务所需的所有模块,提供处理用户请求的接口(generate),并完成请求数据的编码、执行与解码过程。
- Block Manager :基于PagedAttention原理管理KV cache的显存。
- Scheduler :通过队列维护待执行的请求,组织并下发每一步需要执行的请求。
- Model Runner :加载并运行模型,完成每个请求的运算。当TP > 1时,主进程会启动多个Model Runner实例,共同完成前向计算。
Continuous batching和Prefix caching的具体逻辑实现,主要在Scheduler和Block Manager中完成。
关键特性原理简介:
Continuous batching(持续批处理) :持续地向GPU中送入请求数据进行推理,而非采用离散的批处理方式。当一个请求结束后,会立即下发新的请求,这种处理方式能够有效提升GPU的利用效率。
continuous batching
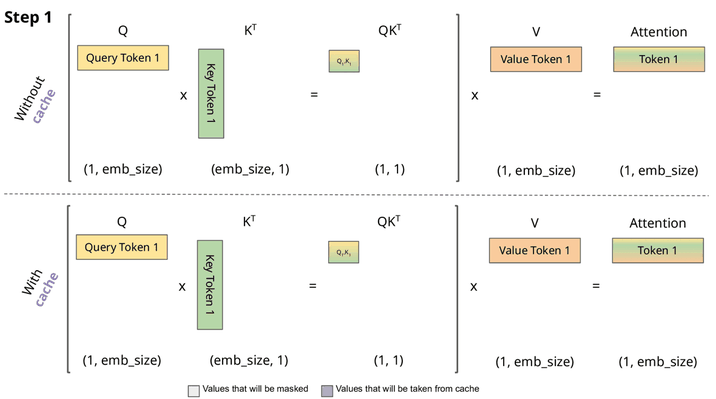
在Attention计算中,KV值的复用能够减少冗余计算。目前,KV cache已成为Attention推理计算的标准配置,推理框架需要管理多个不同请求的KV cache。Nano-vLLM中采用的KV cache管理技术主要是Paged Attention和Prefix Cache。
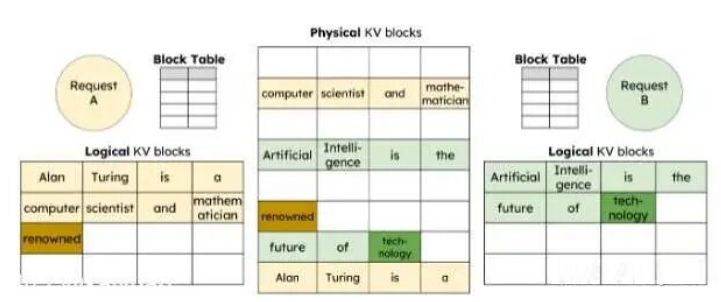
Paged Attention(分页注意力) 的核心逻辑是将Attention运算中的KV值通过类似虚拟内存的分页机制管理起来,如下图所示。图中有两个请求request A和B,它们各自拥有自己的逻辑块(logical kv blocks),并通过对应的映射表(block table)找到每个token在物理块(physical kv blocks)中的位置。这种方式的优势在于:能够充分利用显存,减少显存碎片;同时减少物理显存的反复申请与释放操作,从而提升效率。
PagedAttention基本原理示意
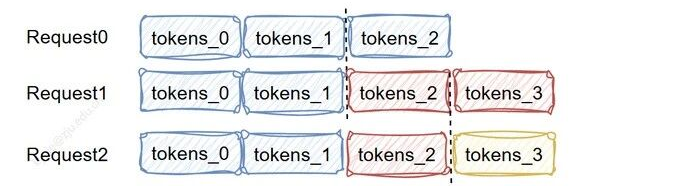
Prefix Caching(前置缓存) 的原理是通过跨请求/对话的KV cache复用来减少计算量。如下示例,推理三个不同的请求0、1、2。请求0计算完成后,可将计算得到的KV cache保存下来;在请求1计算时,前两个token块的cache可以直接复用。同样,请求3可复用3个块,仅需计算tokens_3的内容。Prefix Cache能够有效减少prefill阶段的总计算量。
prefix示例
2.2 LLM Engine
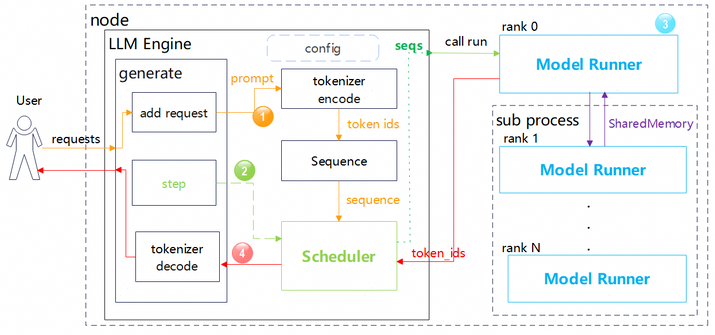
LLM Engine是推理框架的核心模块,它会创建一个Scheduler实例和至少一个Model Runner实例。其主要逻辑封装在generate函数中,数据在各模块之间通过参数传递。请求的资源分配在Scheduler中完成,前向运算在Model Runner中完成。其中,第一个Model Runner创建在主进程中,其他Model Runner创建在子进程中,主进程与子进程之间通过共享内存进行通信。
执行步骤如下(结合下图说明):
- 接收到用户请求后,通过tokenizer将prompt编码为token ids,并为每个请求创建一个Sequence实例。
- 调用step函数触发调度器执行,调度器将待执行的请求数据传递给Model Runner。若存在多个Model Runner,数据仅传输给rank 0的Model Runner。
- 在Model Runner中完成模型的前向计算,获得生成的token ids。
- 将token ids解码为字符串并返回给用户,同时调度器释放相应资源。
2.3 Scheduler
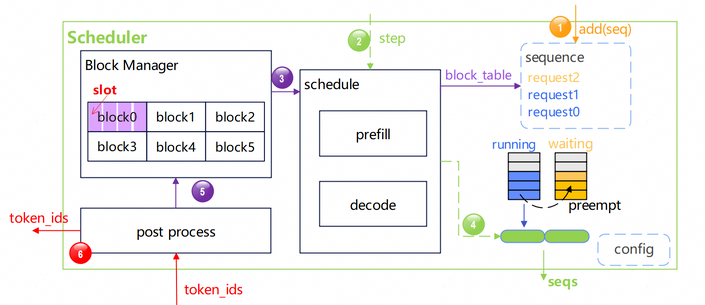
Scheduler(调度器)负责请求的下发与执行组织,内部维护两个队列:running队列和waiting队列,多个请求在这两个队列之间轮转。调度逻辑默认采用prefill优先策略,即当收到新的prefill请求时,可打断当前正在进行的decode执行,被中断的请求将被移入waiting队列。抢占逻辑为:当请求执行资源不足时,按照入队顺序将running队列中后进入的请求转移至waiting队列。
调度器内部会创建Block Manager实例,用于为请求分配KV cache blocks。其主要执行步骤如下(结合下图说明):
- 接收到新请求后,将其加入等待队列。
- 执行step,分为prefill和decode两个阶段。
- 为即将执行的请求分配blocks,信息记录在block table中。
- 打包当前需要执行的请求数组seqs。
- 前向计算完成后进行后处理,释放已结束请求占用的KV cache资源。
- 将token ids返回给tokenizer解码。
2.4 Model Runner
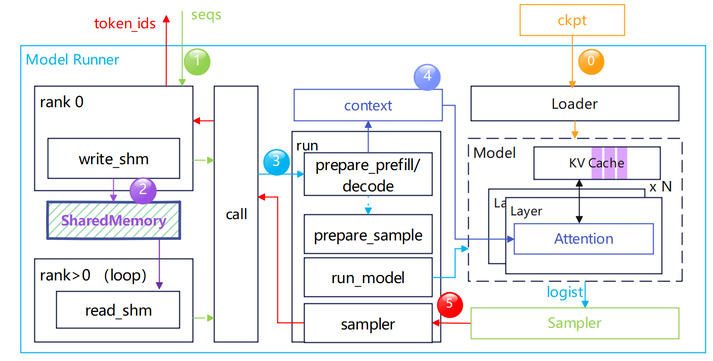
Model Runner(模型执行器)主要完成模型的前向运算。当TP>1时,通过multiprocessing管理各rank之间的协作。rank 0创建的Model Runner接收seqs数据,并通过SharedMemory与其他进程共享该数据,仅rank 0返回计算结果。Model Runner的关键函数为run。执行步骤如下(结合下图说明):
0. 推理服务启动时,需完成模型参数加载、KV cache创建及预热。
1. rank 0接收来自调度器的待执行请求。
2. rank 0将请求数据写入SharedMemory,其他rank通过循环调用loop函数读取SharedMemory,在读取到请求数据seqs后启动执行。
3. Model Runner执行run操作,包括数据准备、模型执行和logits采样。
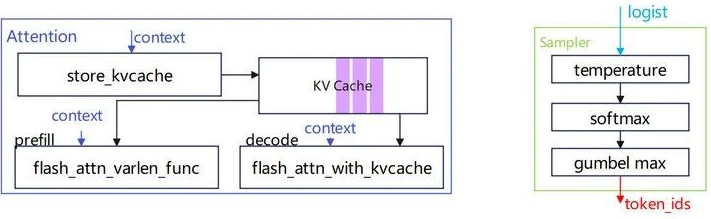
4. 在准备阶段会创建context数据,该数据主要用于Attention阶段的计算,为flash attention算子提供入参。
5. 模型前向计算得到的logits经采样器完成采样,采样结束后返回token ids。
在Attention阶段,KV cache会通过store_kvcache函数写入KV cache tensor中;Attention计算根据当前是prefill还是decode阶段调用不同的FA算子。目前采样的计算过程为:温度、softmax和gumbel max计算。
3 代码分析
Nano-vLLM的整体代码结构简单清晰,阅读源码时可以从LLM Engine类作为入口,逐层展开。本文将主要介绍其代码结构,并重点讲解其中的几个关键逻辑。
3.1 代码结构
代码编写中使用的主要外部模块:
- 采用PyTorch实现模型层,使用torch.distributed处理分布式计算;
- 采用flash_attn构建Attention模块,利用transformers的AutoTokenizer进行编码和解码;
- 使用multiprocessing的SharedMemory进行数据协同,用Event完成各Rank之间的同步;
- 使用triton库自定义KV cache存储函数,实现KV cache的快速写入;
- 利用safetensors库的safe_open构建模型参数加载函数。
代码组织:
- nanovllm.engine:框架关键模块定义位置,包含Sequence、Scheduler、ModelRunner、BlockManager等。
- nanovllm.layers:模型层实现,如activation、attention、linear、embedding、sampler等。
- nanovllm.models:具体模型结构实现,当前仅支持Qwen3模型。
- nanovllm.sampling_params:定义SamplingParams以存储采样参数。
- nanovllm.config:定义框架运行基本参数,如max_num_batched_tokens、max_num_seqs、gpu_memory_utilization等。
- nanovllm.utils:实现Context与load_model。每个进程仅实例化一个Context。
3.2 关键类/函数
KV cache的管理是推理框架负责的核心工作之一,本节将分析其中的关键环节:KV cache blocks的数量计算、blocks的分配与回收。
KV cache的数量计算
在模型加载完成后,框架需要计算出能够开辟的最大blocks数量,该逻辑位于nanovllm/engine/model_runner.py的allocate_kv_cache()函数中,通过该函数确定blocks的数量上限。首先,根据config配置确定单个block的大小,其中block_size为每个block对应的tokens数量,框架中默认值为 256(位于 Sequence类的公有变量中)。
block_bytes = 2 * num_hidden_layers * block_size * num_kv_heads * head_dim * fp_16_size
|
blocks数量的采样计算:
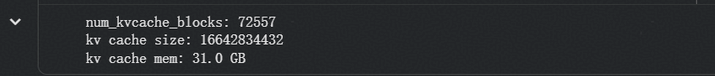
num_kvcache_blocks = int(total * gpu_memory_utilization - used - peak + current)
|
其中gpu_memory_utilization为用户配置的系数,表示框架最多可使用多少显存。total、used、peak、current是框架进行预热后由torch.cuda采集的显存数据,框架根据这些参数确定运行时的blocks上限。
可以参考nano_vllm.ipynb [2] 2.2节点的计算演示,配置参数后得到如下计算输出:
BlockManager运算
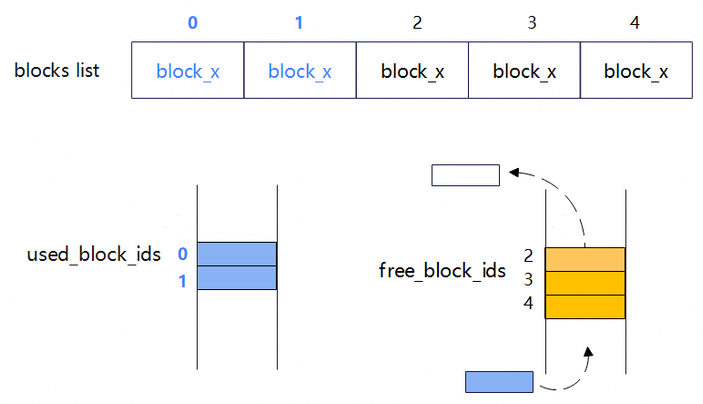
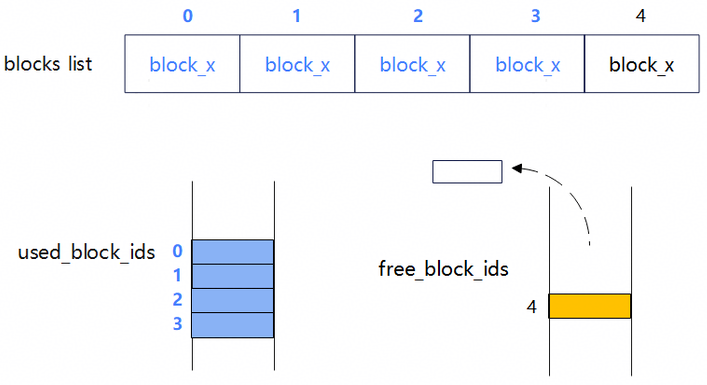
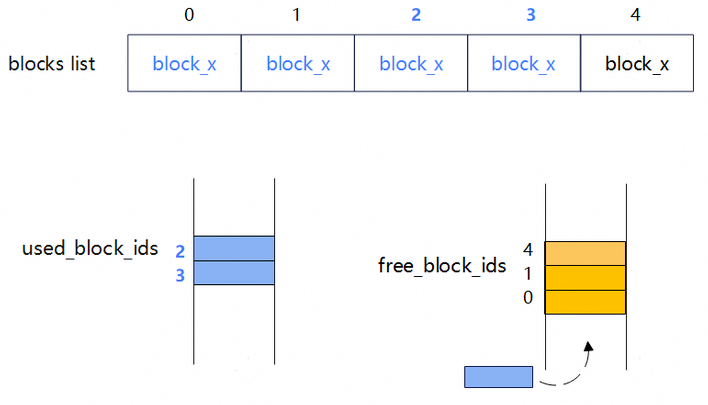
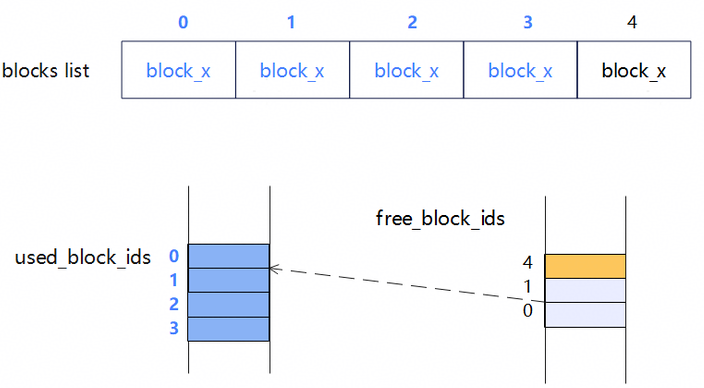
BlockManager负责管理逻辑显存,其核心任务是维护一个blocks列表(或称block池),并记录哪些block处于空闲状态,哪些blocks正在被使用。未被请求占用的blocks会被放入空闲队列(free_block_ids)中进行记录,该队列遵循先进先出(FIFO)原则,这一原则有利于历史数据的保存。已被请求占用的blocks则记录在使用列表(used_block_ids)中。
BlockManager的主要功能是分配与释放块,对应函数为allocate()和deallocate()。
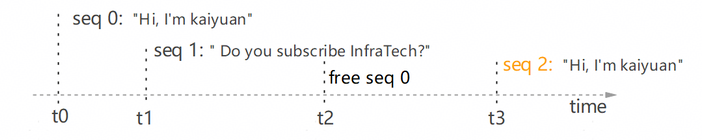
下面通过一个例子来讲解其运行逻辑。假设num_kvcache_blocks的大小为5,请求序列为seq0、seq1、seq2,每个请求需要2个block。其中seq0和seq1的序列内容相同。执行时序如下所示:
时刻0:为seq0分配blocks(序号0,1):
时刻1:为seq1分配blocks(序号2,3)。
时刻2:释放seq0的blocks(序号0,1)。
时刻3:为seq2分配blocks(序号0,1)。由于seq2的内容与seq0相同,且上一步释放的block值未被清除,prefix cache匹配动作中检测到相同前缀,则会让相关的block直接转入已使用队列中。
prefix cache的匹配通过哈希值计算完成,在compute_hash()函数中实现了对token ids序列的哈希计算。
        def compute_hash(cls, token_ids: list[int], prefix: int = -1):
              h = xxhash.xxh64()
              if prefix != -1:
                  h.update(prefix.to_bytes(8, "little"))
              h.update(np.array(token_ids).tobytes())
              return h.intdigest()
|
上述计算的整个过程,可以单独演示计算,参考nano_vllm.ipynb [2] 2.3节。
Attention运算
Attention运算是框架代码中的另一个关键部分,计算过程调用的是FlashAttention算子。在此之前,需要根据算子要求为每个数据构造好相应的入参。在flash-attention/flash_attn/flash_attn_interface.py中可以找到FlashAttention计算所需的数据格式要求:
- Q/K/V数据格式:(total_q, nheads, headdim),即计算decode时Q的格式为(batch_size, seqlen, nheads, headdim)
- KV cache数据格式:(num_blocks, page_block_size, nheads_k, headdim)
- cu_seqlens_q/cu_seqlens_k数据格式:(batch_size + 1,),表示batch中各序列长度的累积值
- max_seqlen_q/k:Q/K在batch中最长的序列长度
- cache_seqlens:cache的序列长度
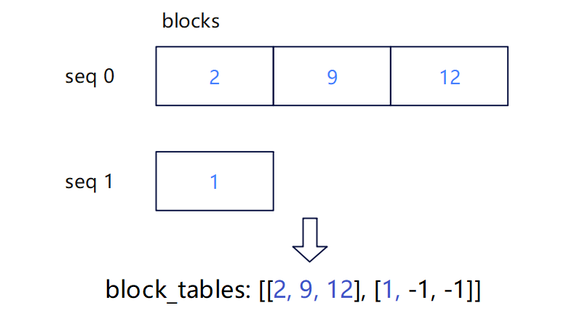
- block_tables数据格式:(batch_size, max_num_blocks_per_seq),用于索引KV cache的block数据
计算步骤:
- 创建请求转换数据
- 分配逻辑存储空间
- 分配物理存储空间
- 构建FA计算数据格式
- 完成FA计算
所谓的物理存储空间,实际上是通过一次性分配一整块KV cache,再按照数据索引进行使用。整个模型共用一个tensor数据,其构造逻辑如下:
kv_cache = torch.empty(2, num_hidden_layers, num_kvcache_blocks, kvcache_block_size, num_kv_heads, head_dim)
|
第一个维度“2”用于区分K值和V值,第二个维度num_hidden_layers表示模型的总层数,后续维度则按照FlashAttention算子的格式要求进行组织。每层的KV cache数据传入FA算子时,会按照如下方式进行索引:
layer_id = 0
k_cache = kv_cache[0, layer_id]
v_cache = kv_cache[1, layer_id]
|
Attention的计算示例参考nano_vllm.ipynb [2] 第3.1节。
CUDA Graph加速Decode计算
在Decode计算阶段,若配置enforce_eager=False,则允许使用CUDA Graph加速。具体做法是为每个batch size的输入记录一个CUDA Graph,当再次遇到相同batch size时,直接调用graph replay来提升速度。图的捕获逻辑位于nanovllm/engine/model_runner.py的capture_cudagraph函数中。
笔者编写了一段可独立运行的代码,用于模拟nano-vLLM运行过程中用到的逻辑,具体请参考 nano_vllm.ipynb [2] 第3.2节。
KV cache的写入函数
每次运算时,KV数据需要写入KV cache中,其中关键参数是slot_mapping,该参数已在本文第1节中介绍。其计算示例代码如下:
 def get_slots(block_ids, block_size, seq_len):
      slots = []
       for block_id in block_ids[:-1]:
           start = block_id * block_size
           end = start + block_size
           slots.extend(list(range(start, end)))
      # 最后一个block
       start = block_ids[-1] * block_size
       end = start + (seq_len - (len(block_ids)-1) * block_size)
      slots.extend(list(range(start, end)))
       return slots
|
slot的计算示例参考nano_vllm.ipynb [2] 第1.2节。
有了slot_mapping之后,就可以正确更新KV cache数据。在框架中,使用了Triton代码实现了这一函数功能,位于nanovllm/layers/attention.py中的store_kvcache_kern。
Scheduler的逻辑
Scheduler的代码逻辑比较清晰简单,主要体现在对prefill和decode阶段的区分处理,以及对两个队列的处理顺序与优先级。关于具体的调度过程,笔者在之前的一篇文章中已有介绍:vLLM Scheduler逻辑难啃?先手搓一个基础调度器
补充问题
为什么仅在decode阶段使用CUDA Graph?
CUDA Graph的加速要求输入尺寸固定,这样才能利用图缓存来提升性能。在decode阶段,每个请求的输入长度始终为1,其他输入保持不变,这种固定输入格式适合使用图缓存;而prefill阶段的计算长度不固定,若要构造图缓存,需要较大的显存空间和初始化时间,因此通常不支持CUDA Graph加速。
Nano vLLM和miniSGLang、vLLM、SGLang是什么关系?
Nano-vLLM与vLLM之间没有直接的代码关联,Nano-vLLM的处理流程可以理解为vLLM v0版本的简化实现。Nano-vLLM和miniSGLang均不适用于生产环境部署,而是作为学习推理框架内部原理的理想学习材料。
| 
 学习助手




 订阅