| 编辑推荐: |
本文主要介绍了anythingllm的功能、设置、以及使用。希望对你的学习有帮助。
本文来自于微信公众号稀土掘金,由火龙果软件Alice编辑推荐。 |
|
一、什么是anythingllm以及它的原理是什么?
(1)什么是anythingllm?
Anythingllm其实是一个框架,将大语言模型llm、嵌入模型、向量数据库组合起来的这么一个东西。
用土木话来举例:
anythingllm:它相当于就是一个工地,里面已经帮你找好了各种设施和人,你直接可以进去当项目经理了。
大语言模型llm:说白了就是一个技术总工这个职位,它知识渊博,但是没有专门针对你的项目的知识,你问他东西时最好给它一堆你的项目资料,这样它才能针对你这个项目进行准确的回答。这个总工可以是你公司自带的(用你自己电脑运行的,能力根据你的电脑好坏决定),也可以是临时调过来的(就是调用大公司的服务器,按说话多少收费,价格还好,但能力强,但会有隐私问题嘛)
我们常说的deepseek,openai,claude,QWEN这些语言模型,就是这个技术总工的职位。
嵌入式模型:工地里面的资料员,它负责将你给它的资料整理好,放到资料柜里面。同时,它也负责找资料。你不要想用技术总工来找资料,找不到的。(这些嵌入式模型也是专门训练将数据转化成向量坐标,也可以将向量坐标转化成文字。)
向量数据库:档案室里面的专门一排一排的资料柜(这种是专门用于AI存储和搜索的数据库)
(2)anythingllm的原理
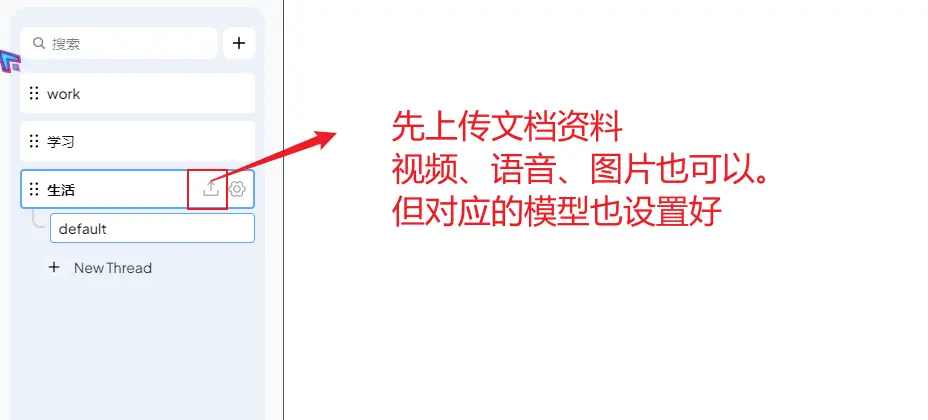
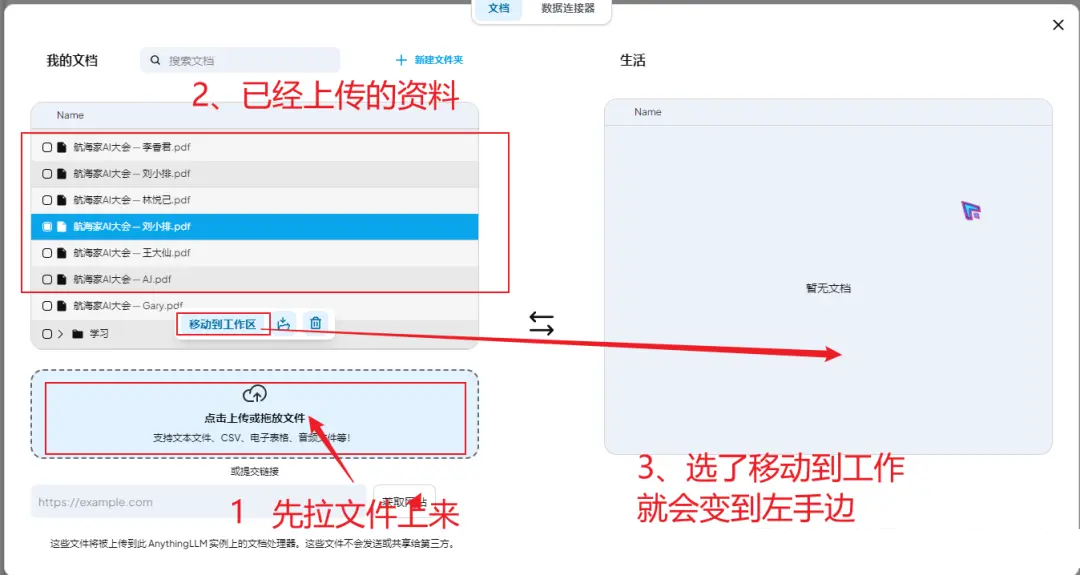
(1)先上传资料(一堆资料)
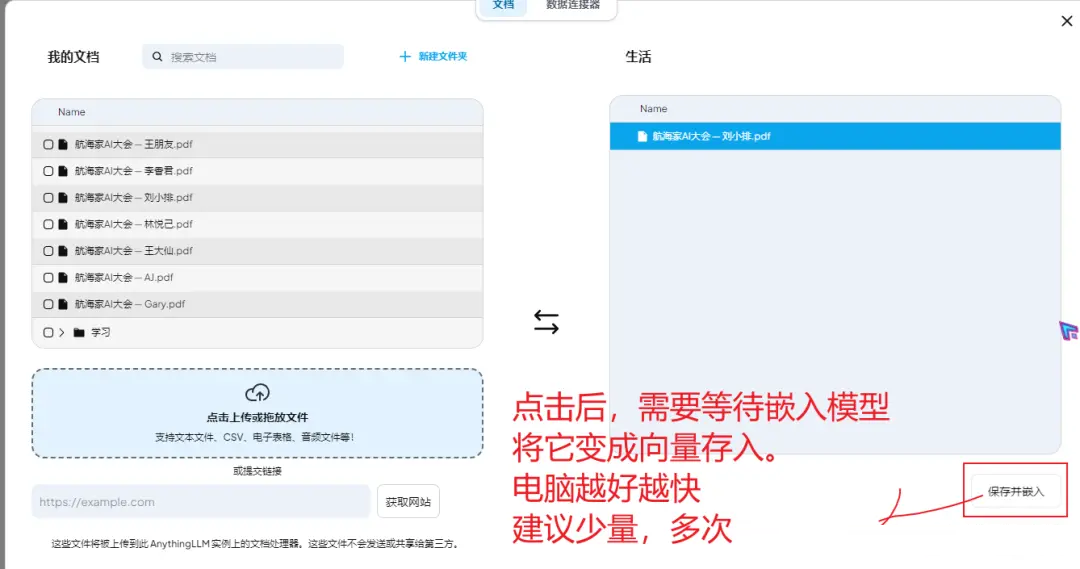
(2)资料员这资料分块(按照大小、语言意思、标点符号)等
(3)存入档案室
(4)你提出问题A
(5)资料员找出A意思相近的几个资料B
(6)总工拿到资料A和B,回答你的问题
二、怎么设置好anythingllm
由于今天我测试时候发现,anythingllm安装的时候自带的ollama是封装版本还不能升级,
不好用,所以我重新下载了专门的windows版本。
(建议新安装版本,不然用不了最新的qwen3嵌入模型)
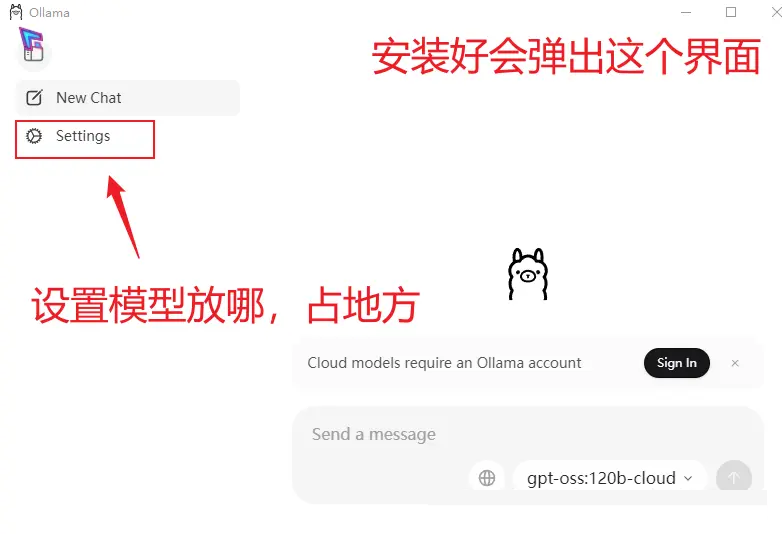
(1)ollama.com/download
(2)右键安装包“以管理员身份安装”【只能默认安装在C盘】
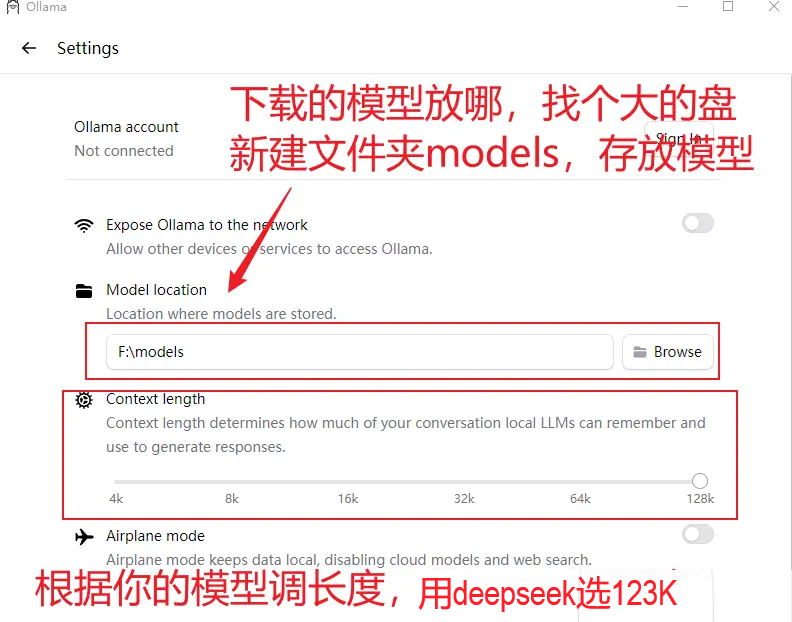
(3)调设置,如果没有自动打开,打开左下角开始菜单,找ollama打开。
(4)记住刚才放模型这个文件夹位置,我的是f:\models
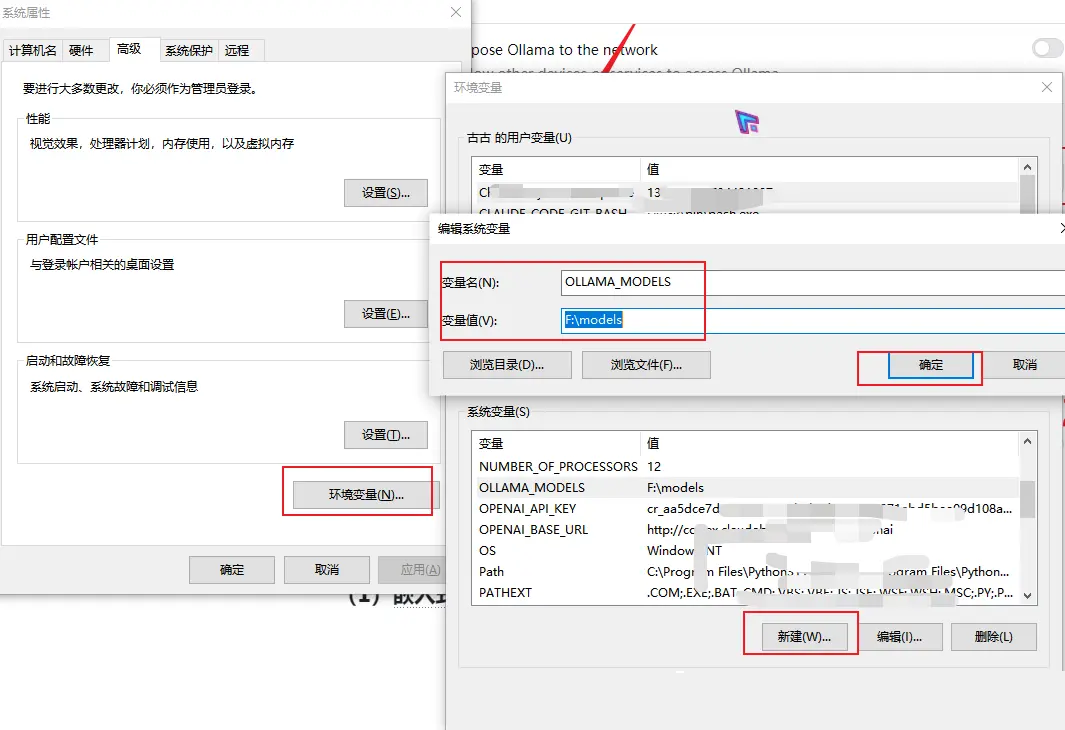
右键--我的电脑--属性--高级系统设置--环境变量--(系统变量)新建
设置参数:变量名:OLLAMA_MODELS
变量值:F:\models(你刚设定的地址)
以后大模型就下载到这里,不占用C盘大小。
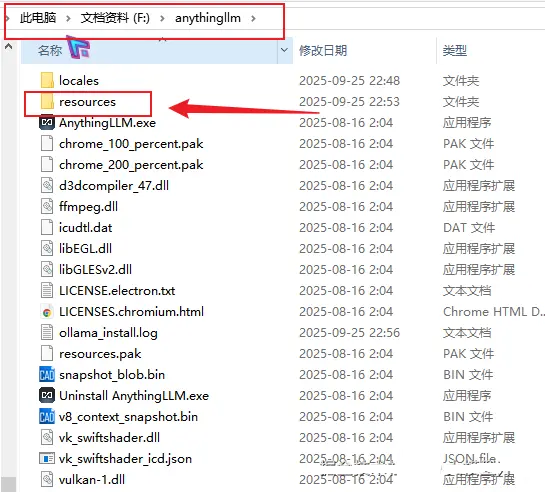
(5)关闭原来anythingllm自带的ollama
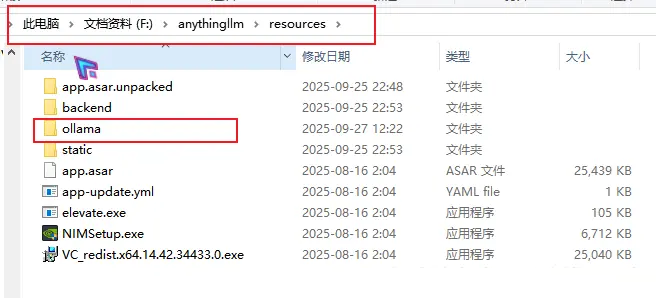
找到你安装anythingllm的位置。进入resources文件
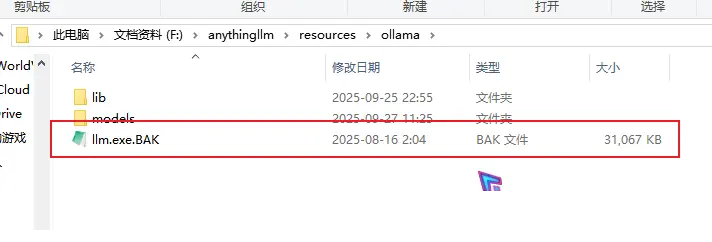
找到llm.exe这个文件,改他的名字成llm.exe.bak或者直接删除它。
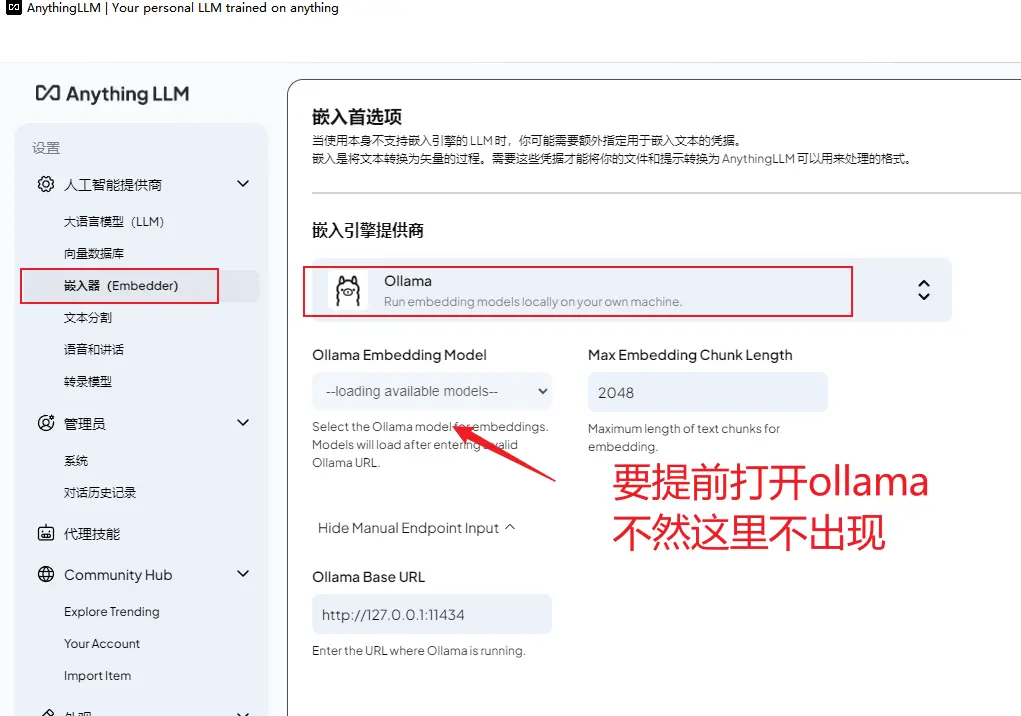
(1)嵌入式模型
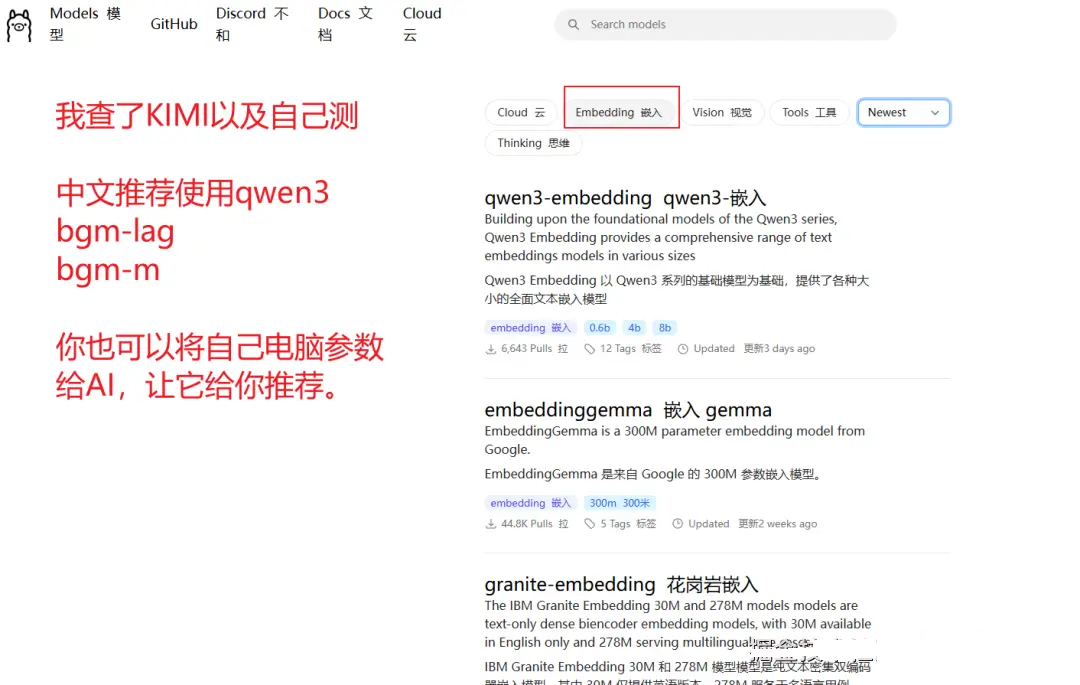
嵌入模型有很多种,我测试过,
anythingllm自带的嵌入模型不好用,不适合中文的。
所以建议重新下载。
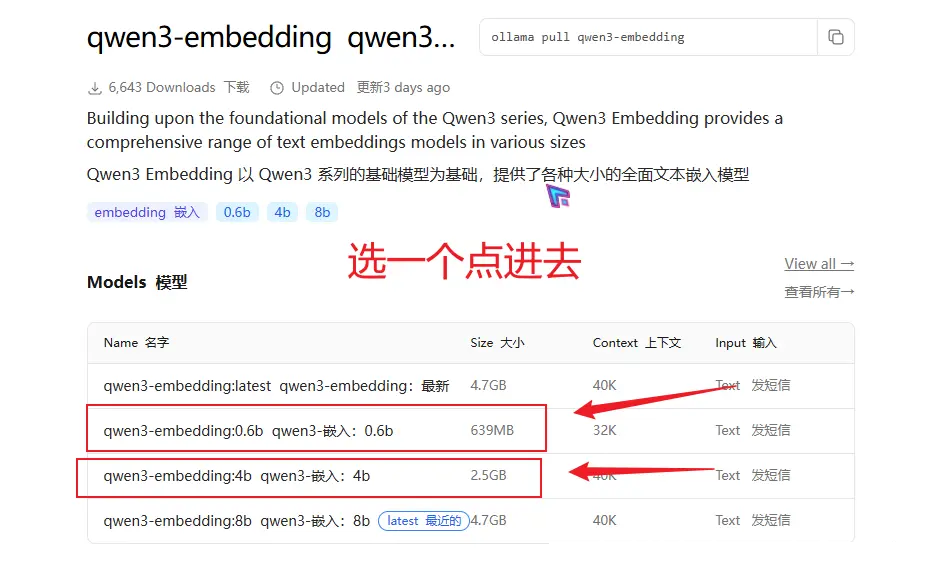
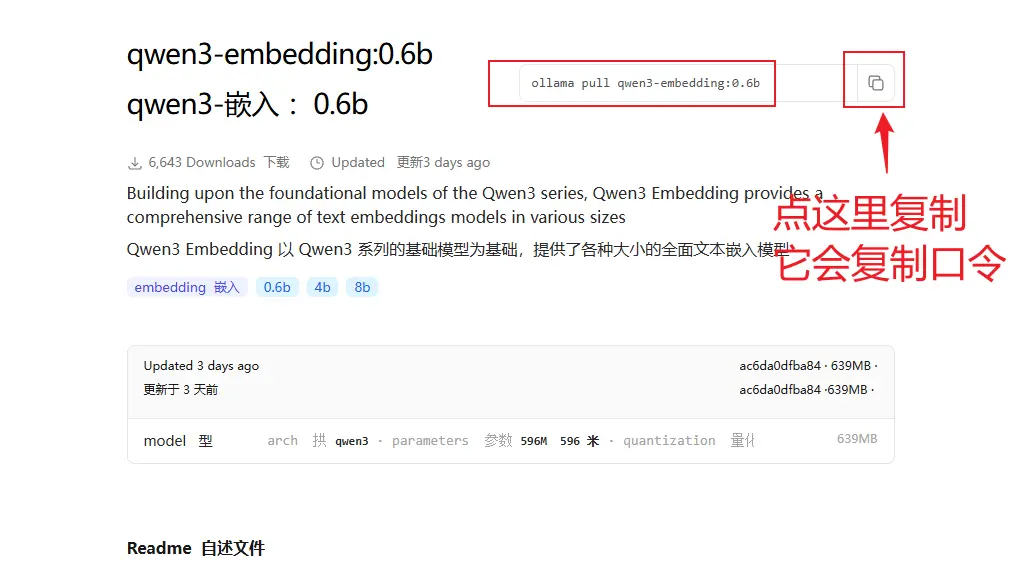
(1)到ollama的官网ollama.com/search
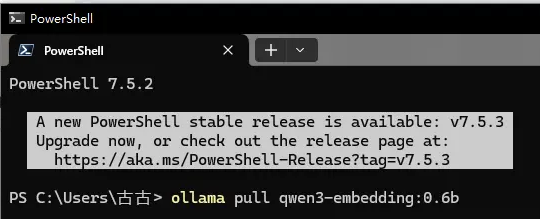
(2)打开你的CMD或者powershell
输入进去,回车。等待下载安装。
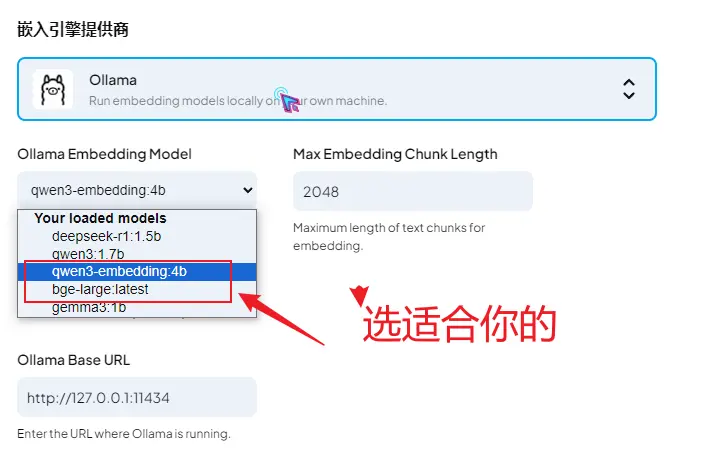
(3)选择嵌入模型
返回到anythingllm
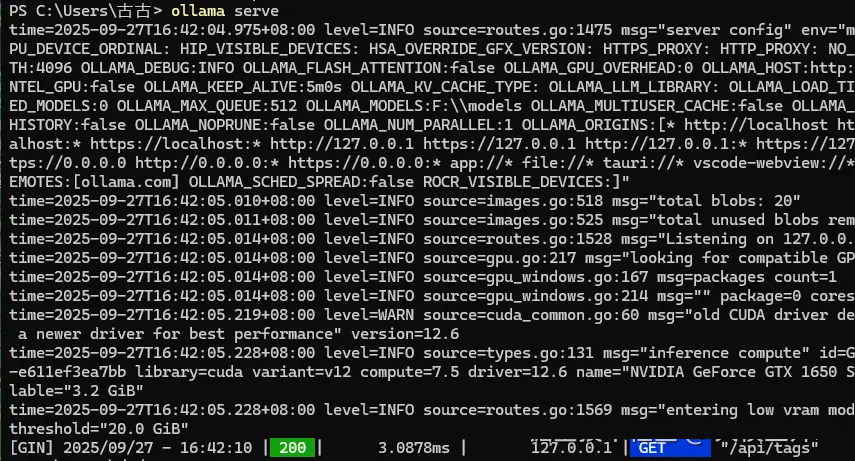
1、要么在cmd中输入ollama serve打开它
2、要么点击开始-ollama打开它才会出现选择
(2)LLM大语言模型
这个同样的操作,到ollama官网上下载合适你电脑大小的大语言模型
推荐
(1)deepseek r1的1.3b-----支持128k上下文
(2)qwen3:1.7b--最新发布
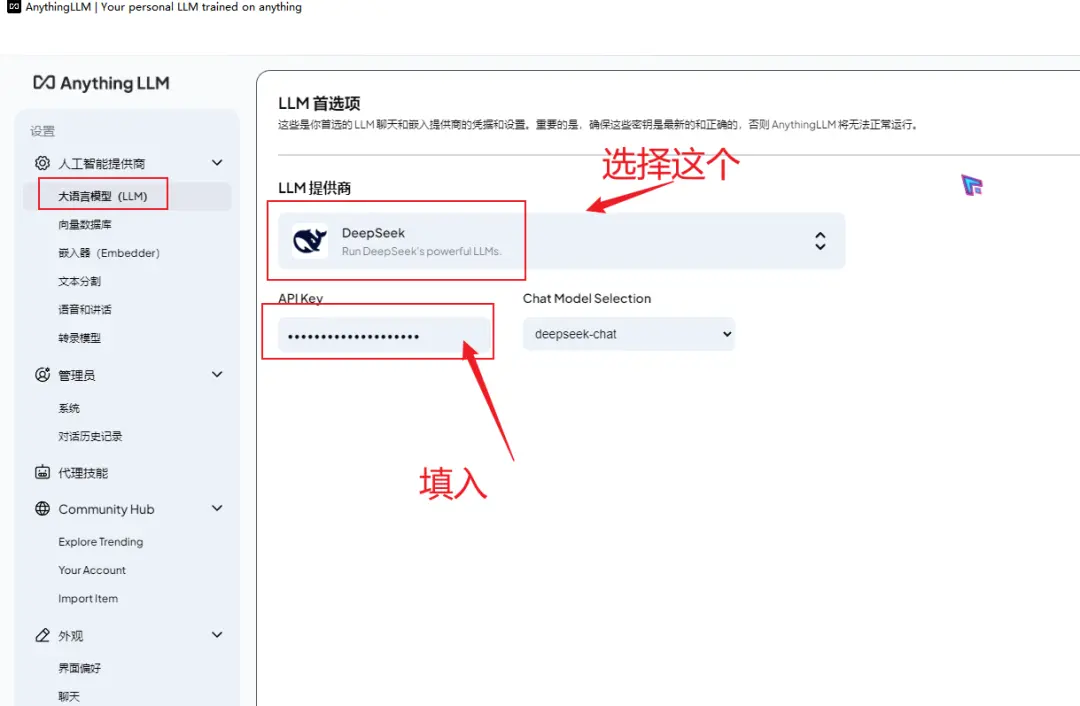
(3)选择调用API模型
anythingllm里面可以选deepseek和moonshot两个
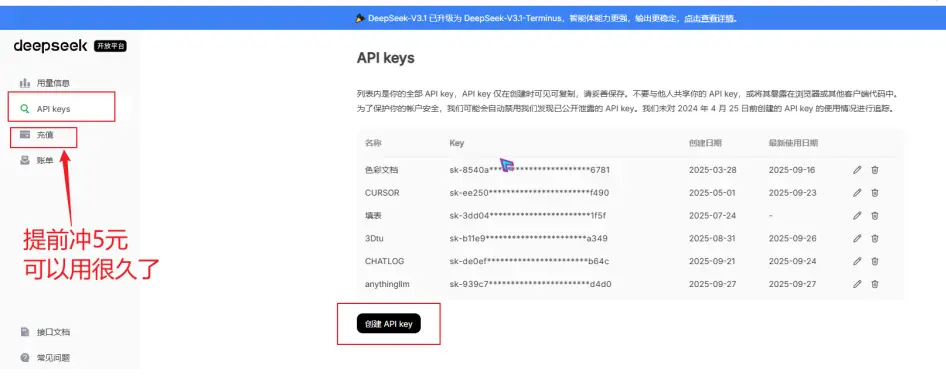
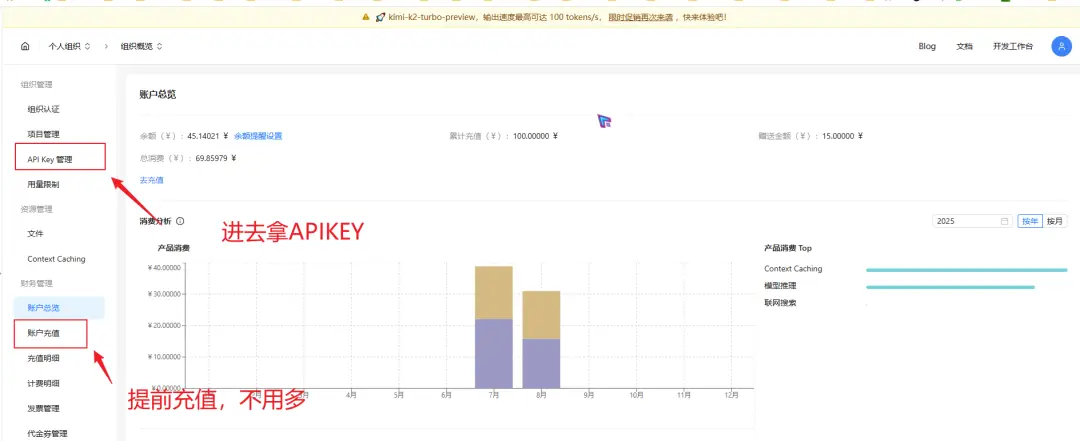
到官网注册platform.deepseek.com/usage
冲5元可以用很久了。复制自己的api key。
moonshot月之暗面
platform.moonshot.cn/console/acc…
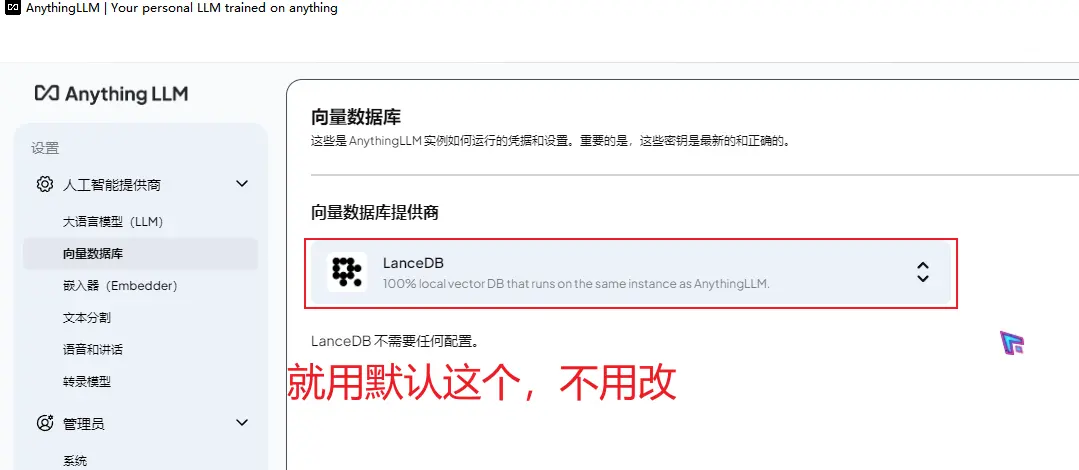
(3)向量数据库的设置
就用默认这个,我查过问过很多次了
lanceDB适合个人使用,包括后续升级、迁移到服务器以及响应和性价比,都是最适合个人的。
| 向量数据库 |
语义检索 |
全文/BM25 |
元数据过滤 |
混合召回 |
规模/延迟 |
推荐场景 |
| LanceDB |
✅ HNSW |
✅ 内置 FTS |
✅ SQL 语法 |
✅ 滑杆权重 |
单机千万级/1 ms 级 |
笔记本、单 Docker,零配置 |
| Chroma |
✅ HNSW |
❌ |
✅ 简单 where |
❌ |
百万级/5 ms |
快速 PoC,脚本调试 |
| Qdrant |
✅ HNSW+PQ |
✅ 1.8 起 |
✅ 丰富过滤 |
✅ 原生 hybrid |
10 亿级/10 ms |
本地高性能、多云 |
| Weaviate |
✅ HNSW+PQ |
✅ BM25+Filter |
✅ 类 GraphQL |
✅ 融合算分 |
10 亿级/15 ms |
需要 GraphQL 接口、企业多租户 |
| Milvus/Zilliz |
✅ IVF、HNSW、DiskANN |
✅ 2.4 起 |
✅ expr 字符串 |
✅ 融合算分 |
100 亿级/20 ms |
超大规模、K8s 云原生 |
| Pinecone |
✅ HNSW |
❌ |
✅ 简单过滤 |
❌ |
同区 1 亿+/25 ms |
完全托管、无运维,生产即服务 |
- AnythingLLM 的召回=“向量 + 可选全文 + 可选过滤 + 可选重排”。
- 能否玩“全文”“混合”完全取决于你选的向量数据库——LanceDB/Qdrant/Weaviate/Milvus
可以,Chroma/Pinecone 不行。
- 2025 年想“开箱即用”选 LanceDB;要“企业级高并发”选 Qdrant;要“百亿向量云原生”选
Milvus/Zilliz;要“零运维托管”选 Pinecone。
| 维度 |
LanceDB(默认) |
Chroma |
Qdrant |
Weaviate |
Milvus/Zilliz |
Pinecone |
| 部署难度 |
0(随 AnythingLLM 自带) |
1 行 pip |
需起 Docker |
需起 Docker |
需 3 容器/K8s |
0(托管) |
| 单机资源占用 |
内存 200 MB 起 |
内存 500 MB 起 |
内存 2 GB+ |
内存 2 GB+ |
内存 8 GB+ |
无 |
| 最大单机能存 |
~1 亿向量 |
~数百万向量 |
~5 千万向量 |
~5 千万向量 |
无上限 |
无上限 |
| 混合检索 (BM25) |
✅ 内置 |
❌ |
✅ |
✅ |
✅ |
❌ |
| 运维/升级 |
无感知 |
重启脚本即可 |
手动重启容器 |
手动重启 |
需监控 etcd+minio |
全自动 |
| 云费用(腾讯云轻量 4C8G) |
60 元/月 |
60 元/月 |
120 元/月 |
120 元/月 |
250+ 元/月 |
按量 30-100 元/月 |
| 闭源锁定 |
无 |
无 |
无 |
无 |
无 |
❌ 完全托管 |
| 推荐指数(单人) |
⭐⭐⭐⭐⭐ |
⭐⭐ |
⭐⭐⭐ |
⭐⭐ |
⭐ |
⭐⭐⭐⭐ |
~1 亿向量~数百万向量~5 千万向量~5 千万向量无上限无上限混合检索
(BM25)✅ 内置❌✅✅✅❌运维/升级无感知重启脚本即可手动重启容器手动重启需监控 etcd+minio全自动云费用(腾讯云轻量
4C8G)60 元/月60 元/月120 元/月120 元/月250+ 元/月按量 30-100 元/月闭源锁定无无无无无❌
完全托管推荐指数(单人)⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐
(3)参数怎么设置
anythingllm里面有很多参数直接影响问答的效果,但并没有完全正确的答案,只能因为每个人的资料不同而最佳参数不一。
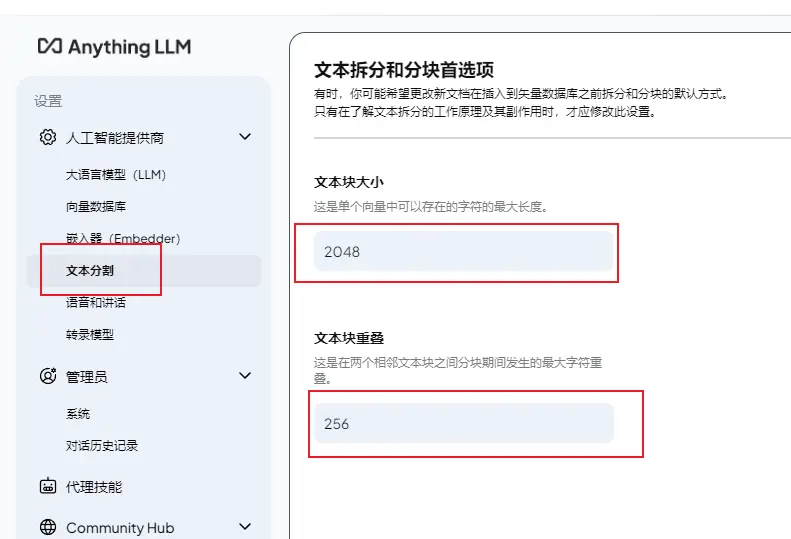
1、文本拆分和分块首选
因为我们将资料放入AI知识库不是整个文档放入,而是将文档拆成差不多大小的一张资料,这样存放的。
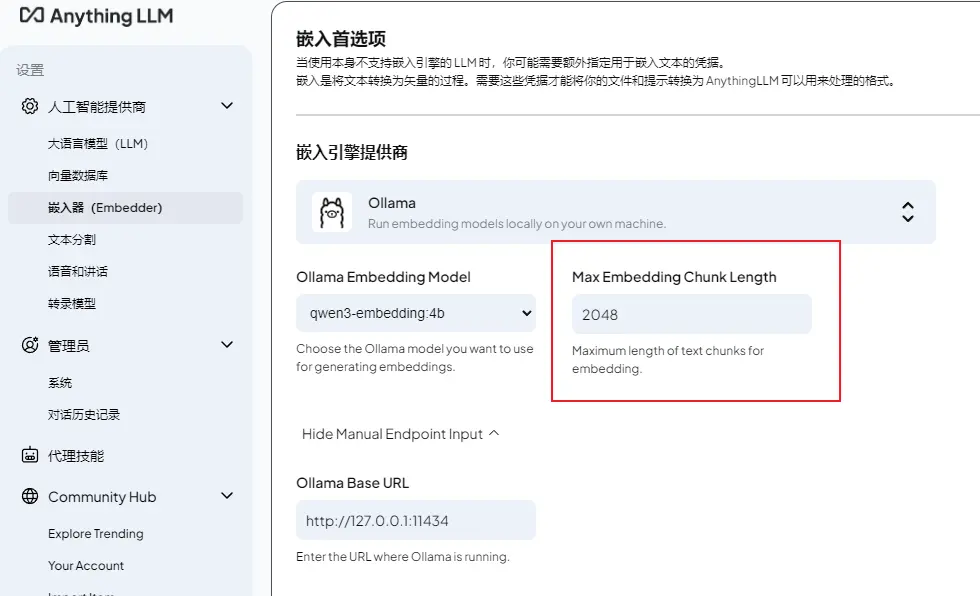
我这里设置的是最大可以2048个字符作为一张资料,然后下一张资料开头会复制上一张资料的后256个字符。
通俗讲:
““把一整本设计图纸切成一段段‘钢筋笼’(块),每根笼最长 2 048
字符;相邻两根笼要互相搭接 256 字符的箍筋,保证受力连续不脱节。”
为什么要这样做?
你的资料员不够强!
如果我想将整个资料盒放一块可以吗?
可以,加钱。
同时你的总工要够厉害,不然这么短时间读不懂这么多资料。
加钱也可以解决。
建议处理:将你的电脑参数发给AI,要包含内存大小、CPU、显卡等参数,让它推荐你最佳参数。
这个是允许你的资料员将资料拆成多大。
这个数越大,对电脑要求越高。
和上面这个文本拆分填一致也可以。
问ai
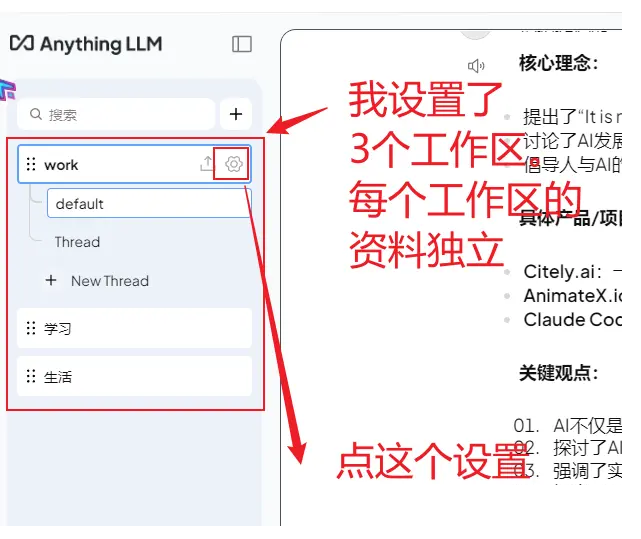
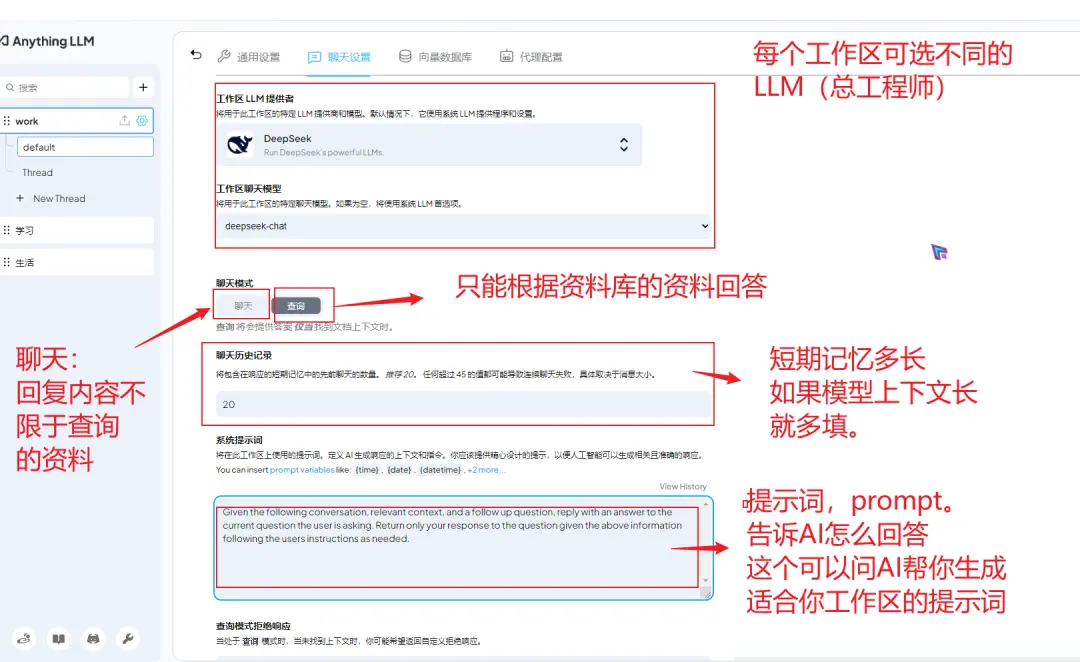
2、工作区如何设置?
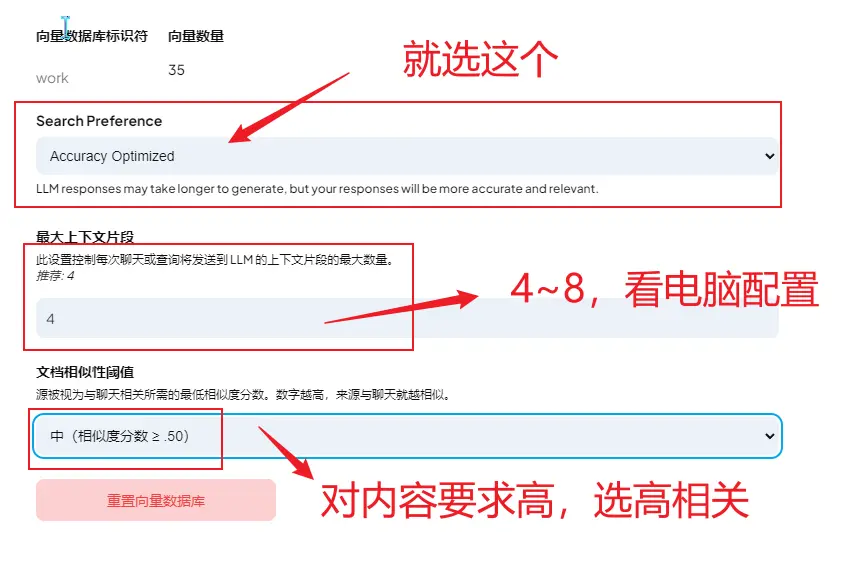
Search Preference(搜索策略)
- Accuracy Optimized =「宁可多花 10 秒,也要把钢筋笼焊牢」 系统会:
- 多召回几段 → 用 rerank 重打分 → 再送 LLM
- 速度变慢,但「漏钢筋」概率最低
最大上下文片段(Max Source Chunks)
- 官方文字:每次聊天/查询最多送多少段文档给大模型
- 土木类比:「一次吊装最多几根钢筋笼」
- 段数越多 → 吊车越大 → 答案越全,但 token 费用↑
- 段数越少 → 吊装快,但可能漏关键受力区
文档相似性阈值(Similarity Threshold)
- 官方文字:「低于这个分数的文档段,一律不要」
- 土木类比:「低于 XX MPa 的混凝土,一律退场」
建议选中或高→ 过滤「看起来有点像但实则无关」的段,答案更干净。你的提问越精准,建议选高。先手选低或无限制,后面调高。
三、开始操作
| 
 学习助手




 订阅