| 编辑推荐: |
文章探讨了企业数字化转型中Ontology(本体)并非普适方案,而是应聚焦于反复发生、需跨系统协作且持续变化的决策场景,并通过分层构建、现场实践和渐进式自动化来沉淀可演进的业务知识,而非追求静态的标准答案。, 希望对你的学习有帮助。
本文来自于公众号:打工人小伊,由火龙果软件Alice编辑推荐。 |
|
智能化时代,核心要先解决业务知识沉淀和转化问题。但一个处于快速创新的公司,本体这套逻辑能否落地,我表示深度怀疑。对于成熟业务,越标准化越容易落地;可既然已经标准化,效能提升空间可能又很有限,也就不需要本体了。
这个质疑让我想了很久。
如果公司变化得快,对象、规则和流程刚建好就过时;如果业务已经很稳定,ERP、CRM 和工作流似乎又足够。
两头都说得通,那么 Ontology 的价值究竟在哪里?
这个问题,正好适合用来为 《读懂 Palantir Ontology》 收尾。(后续再讲本体,就不以系列形式出现了,而是基于日常的实践与思考给大家分享)
我先给出结论: Ontology 并不是所有企业的必选项。它更适合那些反复发生、需要跨系统协作,同时又在持续变化的决策。
业务变化不是反对建本体的充分理由。但如果根本没有值得重复的决策,那就不要建。
第一类,是还在纯探索阶段的业务。
假设一家初创公司每两周都在换目标客户,产品打包方式、定价和交付流程都没定。今天叫「项目」的东西,下周可能会被拆成订阅和专业服务;这一轮试出来的审批玩法,下一轮可能直接取消。
此时应该尽快获得真实反馈。表格、临时脚本、人工操作和轻量原型都可能更合适。太早建一套公共本体,反而会把尚未成熟的猜测写成「公司标准」。
第二类,是已经简单、稳定、单系统可完成的流程。
比如一个固定规则的费用报销,数据都在同一套系统里,审批路径明确,例外很少,每次处理的后果也不会传导到五个部门。这时把现有工作流修好,往往比引入一层 Ontology 更实在。
不用本体,不是技术落后。它可能只是一笔算清楚的账。
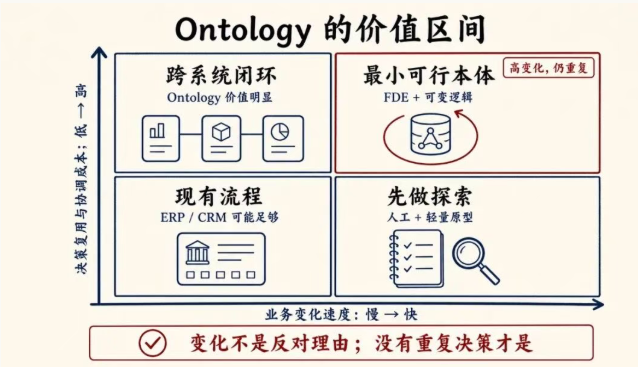
问题不在「标准化程度」
把业务画在「创新」和「成熟」之间,很容易落入开头那个悖论。
更有用的两条轴是:
- 业务变化有多快;
- 一类决策是否反复出现,每次要付出多大的跨系统协调成本。
变化快、重复决策少的业务,适合先由人探索。变化慢、协调成本低的业务,普通工作流就可以解决。
真正需要关注的,是右上角:业务在变,但某类决策一直在重复,而且每次都要跨越数据、流程和部门边界。
一家快速增长的企业软件公司,可能每个季度都在调整产品套餐、合同条款和客户成功策略。可每周仍要回答同一类问题:
哪些客户的续约风险正在上升,今天由谁介入?
这个决策要综合 CRM 里的客户关系、合同系统里的到期日与承诺、产品日志里的使用变化、工单里的故障以及财务系统里的回款。客户、合同、产品、工单这些对象并没有每天消失,但风险判断和处理策略一直在变。
这里要沉淀的是决策结构:涉及谁、用了什么事实、谁可以采取什么行动,以及结果如何回到下一次判断中。某一版风险公式只是其中的可变部分。
本体会过时,但过时的不该是整个世界
快速变化的公司能不能做 Ontology,取决于团队把什么写进了本体。
如果折扣阈值改了,就要重建「客户」对象;产品经理换了一种评分方法,整条客户关系都要迁移,那当然落不下去。这不一定是业务变得太快,也可能是把易变的规则错当成了稳定的业务语义。
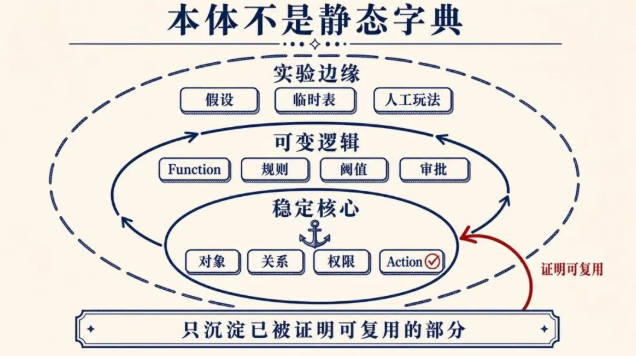
我更倾向把生产中的 Ontology 分成三层。
最里面是稳定核心: 对象的身份、基本关系、权限边界、Action 的业务含义,以及一次决策需要留下哪些证据。它们不是永远不变,只是不应该因为一次运营调整就全部推倒。
中间是可变逻辑: 评分模型、阈值、Function、审批环节、Agent 可调用的工具范围。这些内容本来就应该随策略、数据和组织经验调整。
最外面是实验边缘: 一次性假设、临时表格、新客群玩法和还没有证明可复用的经验。它们可以先留在沙盘、原型或人工流程里,不用急着升格为全公司契约。
Palantir 为 Ontology 提供了 branch、proposal、review、rebase 和 merge 等变更机制。
这些功能不会自动让业务模型变对,但它们提醒了一件事: 本体应该按生产软件的方式演进,不是在会议室里审议一次,然后永久封存。
企业 AI 最难沉淀的,不是文档
读者留言里最重要的一句,其实是「先解决业务知识沉淀和转化」。
信息化让许多事实进入了系统,数字化让报表和指标越来越丰富。
可业务真正如何运转,往往还是藏在缝隙里:
- 老员工 看到哪两个信号,就知道这单不对劲;
- 什么情况可以 绕过常规规则 ,什么情况必须升级给经理;
- 哪个字段虽然叫「完成」,实际上只代表上游系统不再处理;
- 做了一个决定之后,要去哪个系统、找谁、留下什么证据。
把这些经验整理成一本知识库还不够。
一个 Agent 知道「遇到供应中断要考虑客户优先级」,不代表它知道当前受影响的客户是谁、优先级从哪里取、能调用哪个调拨 Action,更不代表它已获得写回权限。
所以「知识沉淀」真正困难的部分,是把经验转成可识别的对象、可测试的逻辑、有权限边界的动作,再让结果回来修正下一次决策。
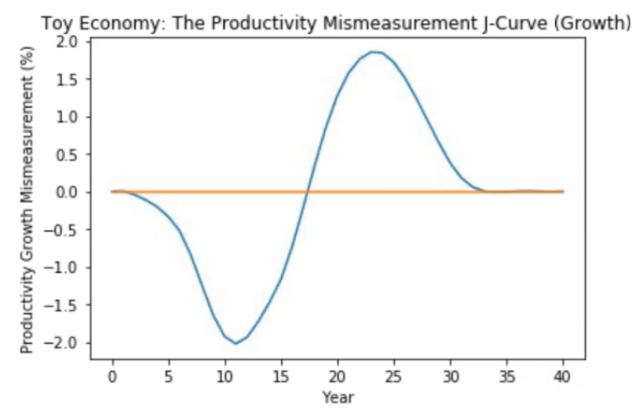
NBER 的「生产力 J 曲线」(Productivity J-Curve)研究讨论过一个更宽泛的问题:AI 这类通用技术要变成生产力,还需要对流程、产品、商业模式和人力资本进行配套投资。
模型接入某个界面的那天,这些投资并不会自动完成。
FDE:把现场知识变成系统
这就连到了 FDE(Forward Deployed Engineer,前线部署工程师)。
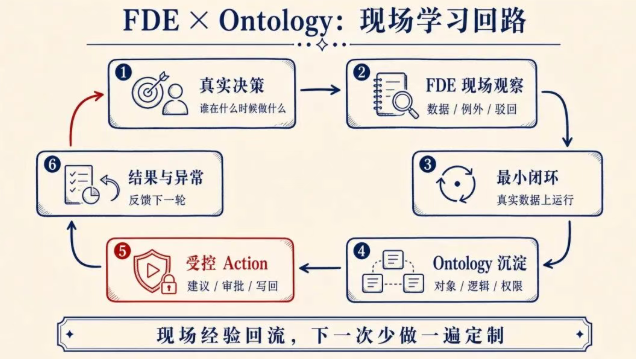
FDE 需要进入客户现场,和业务人员一起找到真问题,用真实数据写出可以运行的解法,并且对结果负责。现场学到的东西还要回到产品,让后面的客户少做一遍定制开发。
Palantir 现在也有一个叫 AI FDE 的产品能力,它是一个通过自然语言操作 Foundry 的 Agent,能构建数据转换、编辑 Ontology、写 Function 和运行测试。这个名称很容易与人类 FDE 混在一起。前者是工具,后者首先
这些例外才是业务知识的原材料。
经过几轮真实运行,团队才能分出哪些是必须稳定的概念,哪些只是暂时策略;哪些应该进入 Function,哪些必须保留人工判断;哪些 Action 可以由 Agent 提议,哪些永远需要第二个人批准。
没有这个现场学习过程,Ontology 容易变成会议室里的业务词典。没有一层可复用的语义、逻辑和动作,FDE 又容易困在一个又一个定制项目里。
企业 AI 落地,通常不是卡在模型上
回到企业 AI 转型,真正难处理的问题往往有四个。
第一,团队选了一个「AI 看起来能做」的任务,却没有人对决策结果负责。 项目可以展示、验收,甚至获得不错的模型指标,但业务方没有一个固定岗位会因它改变今天的工作。
第二,显性规则进了 Prompt,例外却还留在人脑里。 一旦进入生产,误报、驳回、临时绕行和上下游数据冲突会迅速淹没演示时的完美路径。
第三,AI 能提建议,但没有受控的 Action。 最后仍由人复制订单号、切换系统、重新录入结果。系统没有记录建议是否被接受,更不知道这次决定后来是对是错。
第四,第一个客户的问题被解决了,但没有东西被留下来。 连接器、异常类型、评估集、权限模板和客户自己的运营经验,都没有变成下一个项目能复用的产品资产。团队越成功,反而越需要堆人。
这四个问题,任何一个都不能靠换一个更强的模型直接解决。
一条更实际的 Ontology × FDE 落地回路
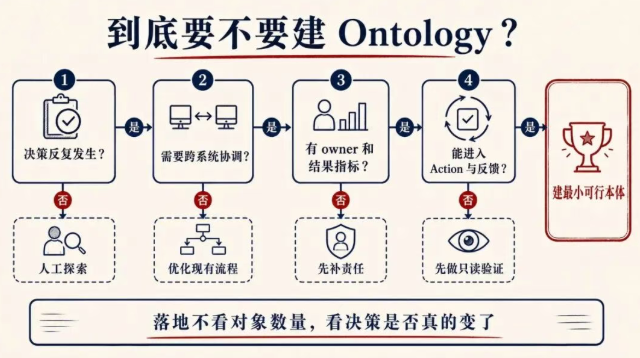
如果团队确实找到了一类高价值、反复发生的跨系统决策,可以按以下顺序推进。
先写决策,不要先写对象清单。
明确谁在什么时间点要做什么决定,现在需要多久,出错有什么后果。如果连业务 owner 和结果指标都找不到,先停在这里。
再跟着用户做一遍,不要只听他怎么说。
记录数据来源、临时补充的表格、被忽略的系统状态、需要问人的例外,以及最终结果被写到了哪里。
然后只沉淀稳定核心。
第一版只需要足以支撑这次决策的对象、关系、权限和一两个 Action。尚未稳定的评分和策略,放在可测试、可替换的逻辑层。
自动化程度要一级一级开放。
先只读观察,再生成建议,然后允许系统暂存 Action 并等待人审批。只有在误报、驳回、权限和失败处理都经过真实运行之后,才考虑让 Agent 自动闭环。
把驳回和例外当作产品数据。
不要只记录「用户没采用」。要知道是数据旧了、规则错了、建议缺少证据,还是用户考虑了系统看不到的组织因素。这些原因决定下一轮要改的是数据、逻辑,还是人机分工。
最后再谈复制。
第二个团队接入时,检查是否真正复用了对象定义、权限模板、Action、评估集和异常分类。如果只是又驻场写了一套新代码,那么这还是项目成功,不是组织能力。
什么情况下,应该果断不建本体
Ontology 是一项需要长期维护的软件资产。没有人对它负责,它一定会过时。
下面几种情况,我会建议先不做:
- 待解决的问题是一次性的,找不到稳定重复的决策;
- 数据、规则和动作都在一套现有系统里,修好原流程就能解决;
- 没有业务项目只做查询和展示,无法进入行动,也拿不到结果反馈;
- 团队既没有变更流程,也没有测试、审计和运营机制,却想一次性建出全公司数字孪生;
- 每次决策节省的成本,明显低于持续建模、集成和治理的成本。
如果一个项目同时命中了好几条, 就不要用「企业 AI 底座」之类的大词把它硬推下去。 先回到原问题,往往更专业。
我们讲的其实不是一款产品
我们从「为什么有了数仓、BI、RAG 和大模型,企业仍然缺少决策闭环」开始,一路讲了 Object、Link、Interface、Function、Action、权限、应用、搜索、Scenario、Agent 和变更管理。
第十六篇把范围收到一个最小决策闭环,番外篇又把 Ontology 放回 CRM、ERP 和存量系统的现实里。
写到这里,我越来越觉得,整个系列其实只在问一件事:
企业能不能把「我们实际上怎样工作」,变成一套可以共同使用、接受检查,并且随现实修改的软件?
Palantir 给这个问题提供了一套很完整的产品答案,但它不是唯一答案,也不会自动解决组织问题。
如果你的公司没有反复发生、出错代价高、需要跨系统协作的决策,不建 Ontology 完全没问题。
但如果你每周都在花费大量时间,让不同团队重新对齐同一批对象、重新解释同一类异常、重新人肉串起同一条决策链,那么「业务在变」未必是拒绝本体的理由。 它反而说明,企业需要一套更便宜的方式,来修改自己对业务的理解。
真正值得沉淀的,往往不是今天那个标准答案,而是企业如何得出答案、采取行动,以及发现错了以后怎么改。
接下来请选一个真实决定,进现场,看它完整地跑一遍。这比继续加名词难得多。
参考来源
[1] Palantir 文档:Why create an Ontology?
https://www.palantir.com/docs/foundry/ontology/why-ontology/
[2] Palantir 文档:The Ontology system
https://www.palantir.com/docs/foundry/architecture-center/ontology-system/
[3] Palantir 文档:Branching the ontology
https://www.palantir.com/docs/foundry/ontologies/branching-ontology/
[4] Palantir 文档:Action types overview
https://www.palantir.com/docs/foundry/action-types/overview/
[5] Palantir 文档:AI FDE overview
https://www.palantir.com/docs/foundry/ai-fde/overview/
[6] 范冰:《前线部署工程师:人工智能时代的客户价值交付秘籍》
https://github.com/xdash/FDE-the-Guidance-Book-of-Forward-Deployed-Engineer
[7] Erik Brynjolfsson , Daniel Rock, Chad Syverson: The Productivity J-Curve
https://www.nber.org/papers/w25148
| 
 学习助手




 订阅