| 编辑推荐: |
本文系统梳理 AI 辅助测试自动化框架的设计与实践,涵盖框架演进与核心架构、测试脚本自动生成与自我修复、测试数据与执行的智能管理、结果智能分析及落地案例与未来趋势,希望对你的学习与工程实践有帮助。
本文来自于腾讯云开发者社区博主「AI SPPECH」,由火龙果软件Alice编辑、推荐。 |
|
引言
在当今快速迭代的软件开发环境中,测试自动化已经成为保证软件质量、加速交付的关键手段。然而,传统的测试自动化框架往往面临着维护成本高、适应性差、智能化程度低等挑战,难以满足复杂多变的测试需求。
随着人工智能技术的发展,测试自动化框架迎来了新的变革机遇。AI辅助测试自动化框架通过整合AI技术,能够实现测试脚本的自动生成、自我修复、智能分析和优化,显著提升测试自动化的效率和效果。
该流程图的 Mermaid 定义:
flowchart LR
  N0["传统测试自动化"]
  N1["挑战:维护成本高/适应性差/智能化程度低/覆盖率不足"]
  N2["AI辅助测试自动化"]
  N3["优势:自动生成/自我修复/智能分析/优化效率/提升覆盖率"]
  N0 --> N1
  N1 --> N2
N2 --> N3 |
你是否在测试自动化实践中遇到过维护成本高昂、测试脚本适应性差、测试覆盖率难以提升等问题?AI技术如何帮助解决这些问题?让我们一起探索AI辅助测试自动化框架的设计与实践。
| 要点 |
描述 |
互动 |
| 传统挑战 |
维护成本高/适应性差/智能化程度低/覆盖率不足 |
你在测试自动化中最大的挑战是什么? |
| AI优势 |
自动生成/自我修复/智能分析/优化效率/提升覆盖率 |
你最期待AI解决哪方面的测试自动化问题? |
| 学习路径 |
概念、架构、设计、实现、优化、实践 |
准备好学习AI辅助测试自动化框架设计了吗? |
目录
目录
├── 第一章:测试自动化框架的演进与挑战
├── 第二章:AI辅助测试自动化框架的核心概念与架构
├── 第三章:AI在测试脚本自动生成中的应用
├── 第四章:AI在测试脚本自我修复中的应用
├── 第五章:AI在测试数据智能管理中的应用
├── 第六章:AI在测试执行智能优化中的应用
├── 第七章:AI在测试结果智能分析中的应用
└── 第八章:实践案例与未来发展 |
第一章:测试自动化框架的演进与挑战
1.1 测试自动化框架的演进历程
测试自动化框架的发展经历了多个阶段,从最初的脚本化测试到模块化测试框架,再到数据驱动、关键字驱动和混合驱动测试框架,直到今天的AI辅助测试自动化框架。
该流程图的 Mermaid 定义:
flowchart LR
  N0["脚本化测试"]
  N1["模块化测试框架"]
  N2["数据驱动测试框架"]
  N3["关键字驱动测试框架"]
  N4["混合驱动测试框架"]
  N5["AI辅助测试自动化框架"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
每个阶段的测试自动化框架都有其特点和优势:
- 脚本化测试:直接编写测试脚本,简单直观,但维护成本高
- 模块化测试框架:将测试脚本拆分为模块,提高复用性,但仍需大量人工编写
- 数据驱动测试框架:将测试数据与测试脚本分离,提高测试覆盖率,但数据准备工作量大
- 关键字驱动测试框架:使用关键字描述测试步骤,降低技术门槛,但关键字维护成本高
- 混合驱动测试框架:结合多种驱动方式,灵活适应不同测试场景,但框架复杂度高
- AI辅助测试自动化框架:利用AI技术实现自动化,提高智能化程度和效率,但技术要求高
1.2 传统测试自动化框架面临的挑战
尽管测试自动化框架不断发展,但传统的测试自动化框架仍然面临着诸多挑战:
该流程图的 Mermaid 定义:
pie showData
  "维护成本高" : 30
  "适应性差" : 25
  "智能化程度低" : 20
  "覆盖率不足" : 15
"技术门槛高" : 10 |
- 维护成本高:测试脚本需要频繁更新以适应应用变化,维护成本高昂
- 适应性差:难以快速适应应用的变化,尤其是UI和业务逻辑的变化
- 智能化程度低:缺乏智能分析和决策能力,依赖人工干预
- 覆盖率不足:测试覆盖率难以有效提升,存在测试盲区
- 技术门槛高:需要测试人员具备较高的编程技能,学习成本高
- 回归测试效率低:回归测试耗时耗力,难以满足快速迭代的需求
- 测试数据准备困难:高质量测试数据的准备工作量大,效率低
1.3 AI为测试自动化框架带来的变革
AI技术的引入为测试自动化框架带来了革命性的变革,主要体现在以下几个方面:
该流程图的 Mermaid 定义:
flowchart LR
  N0["AI技术"]
  N1["测试自动化框架变革"]
  N2["效率提升"]
  N3["成本降低"]
  N4["质量提高"]
  N5["价值实现"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
- 自动化程度提升:AI能够自动完成测试脚本生成、执行和分析等工作,降低人工干预
- 适应性增强:AI能够自动适应应用变化,实现测试脚本的自我修复和优化
- 智能化分析:AI能够智能分析测试结果,识别异常和缺陷,提供有价值的洞察
- 测试覆盖率提升:AI能够基于代码和需求自动生成测试用例,提高测试覆盖率
- 维护成本降低:AI能够自动维护测试脚本,降低维护成本
- 效率提高:AI能够优化测试执行策略,提高测试效率
- 价值实现:AI能够帮助测试团队更好地实现测试的价值,为业务和用户创造价值
你认为测试自动化框架在软件测试中扮演着什么角色?传统测试自动化框架面临的最大挑战是什么?
第二章:AI辅助测试自动化框架的核心概念与架构
2.1 AI辅助测试自动化框架的基本概念
AI辅助测试自动化框架是指将人工智能技术与传统测试自动化框架相结合,利用AI的感知、理解、学习和决策能力,实现测试自动化的智能化、自适应和高效化。
AI辅助测试自动化框架 = 传统测试自动化框架 + AI技术 + 智能决策系统 + 自适应机制 |
AI辅助测试自动化框架的主要特点包括:
- 智能化:利用AI技术实现测试的智能生成、执行和分析
- 自适应:能够自动适应应用的变化,实现自我修复和优化
- 高效性:提高测试效率和效果,缩短测试周期
- 可扩展性:支持多种测试类型和场景,易于扩展
- 低维护成本:自动维护测试脚本,降低维护成本
- 高覆盖率:提高测试覆盖率,减少测试盲区
- 数据驱动:基于数据进行智能决策和优化
2.2 AI辅助测试自动化框架的核心组件
AI辅助测试自动化框架主要包括以下核心组件:
| 组件 |
描述 |
功能 |
AI技术 |
| 数据采集与预处理模块 |
采集和预处理测试相关数据 |
为AI模型提供数据支持 |
数据采集、清洗、转换 |
| 测试脚本自动生成模块 |
自动生成测试脚本 |
提高测试脚本生成效率 |
自然语言处理、代码生成、机器学习 |
| 测试脚本自我修复模块 |
自动修复和优化测试脚本 |
适应应用变化,降低维护成本 |
代码分析、机器学习、强化学习 |
| 测试数据智能管理模块 |
智能管理和生成测试数据 |
提供高质量测试数据 |
数据生成、数据质量评估、机器学习 |
| 测试执行智能优化模块 |
优化测试执行策略和环境 |
提高测试执行效率 |
执行优化、资源调度、强化学习 |
| 测试结果智能分析模块 |
智能分析测试结果 |
提供有价值的洞察 |
结果分析、异常检测、机器学习 |
| 智能决策与协调模块 |
协调各组件工作,提供决策支持 |
实现框架的整体智能 |
决策系统、规则引擎、机器学习 |
| 可视化与交互模块 |
提供可视化界面和交互功能 |
方便用户使用和管理 |
数据可视化、用户界面设计 |
2.3 AI辅助测试自动化框架的架构设计
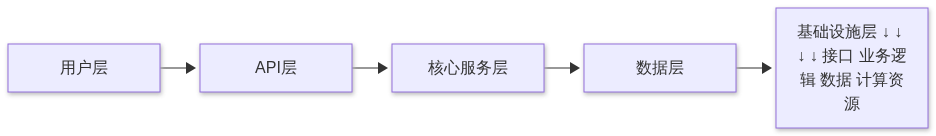
AI辅助测试自动化框架的架构设计应考虑模块化、可扩展性、可维护性和性能等因素。以下是一个典型的AI辅助测试自动化框架架构:
该流程图的 Mermaid 定义:
flowchart LR
  N0["用户层"]
  N1["API层"]
  N2["核心服务层"]
  N3["数据层"]
  N4["基础设施层 ↓ ↓ ↓ ↓ 接口 业务逻辑 数据 计算资源"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
N3 --> N4 |
- 用户层:包括各种用户界面和交互方式,如Web界面、命令行界面、IDE插件等
- API层:提供各种接口,支持用户层与核心服务层的通信和交互
- 核心服务层:包括各种核心功能模块,如测试脚本生成、自我修复、执行优化、结果分析等
- 数据层:包括各种数据存储和管理组件,如数据库、数据仓库、数据湖等
- 基础设施层:包括各种基础设施,如计算资源、存储资源、网络资源等
2.4 AI辅助测试自动化框架的工作流程
AI辅助测试自动化框架的基本工作流程包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["需求分析"]
  N1["测试设计"]
  N2["测试实现"]
  N3["测试执行"]
  N4["测试分析"]
  N5["反馈优化"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
- 需求分析:分析测试需求,明确测试目标和范围
- 测试设计:基于需求设计测试策略和测试用例
- 测试实现:自动生成和优化测试脚本
- 测试执行:优化测试执行策略和环境,执行测试
- 测试分析:智能分析测试结果,识别异常和缺陷
- 反馈优化:基于测试结果反馈,持续优化测试设计、实现和执行
你认为AI辅助测试自动化框架的核心价值是什么?它与传统测试自动化框架相比有哪些主要优势?
第三章:AI在测试脚本自动生成中的应用
3.1 测试脚本自动生成的基本原理
测试脚本自动生成是指利用AI技术,根据需求文档、设计文档、代码等信息,自动生成测试脚本的过程。其基本原理包括:
| 步骤 |
描述 |
AI技术 |
| 需求解析 |
解析需求文档,提取测试点和测试场景 |
自然语言处理、文本挖掘、知识图谱 |
| 代码分析 |
分析源代码,理解功能实现和逻辑 |
静态代码分析、程序理解、机器学习 |
| 测试设计 |
基于需求和代码分析,设计测试用例和测试步骤 |
测试设计、机器学习、规则引擎 |
| 脚本生成 |
根据测试设计,生成测试脚本代码 |
代码生成、自然语言生成、机器学习 |
| 脚本优化 |
优化生成的测试脚本,提高质量和效率 |
代码优化、机器学习、强化学习 |
3.2 基于自然语言处理的测试脚本生成
基于自然语言处理的测试脚本生成是利用NLP技术解析需求文档,提取测试点和测试场景,然后生成相应的测试脚本。
实践示例:基于NLP的测试脚本自动生成
import spacy
import re
import json
import os
from nltk.tokenize import sent_tokenize, word_tokenize
from nltk.corpus import stopwords
import random
import matplotlib.pyplot as plt
plt.rcParams["font.family"] = ["SimHei", "WenQuanYi Micro Hei", "Heiti TC"]
plt.rcParams["axes.unicode_minus"] = False
try:
nlp = spacy.load("zh_core_web_sm")
except:
os.system("python -m spacy download zh_core_web_sm")
nlp = spacy.load("zh_core_web_sm")
test_script_templates = {
"web": {
"login": "def test_login_{test_id}():
driver = webdriver.Chrome()
driver.get('{url}')
driver.find_element(By.ID, '{username_id}').send_keys('{username_value}')
driver.find_element(By.ID, '{password_id}').send_keys('{password_value}')
driver.find_element(By.ID, '{login_button_id}').click()
try:
success_element = WebDriverWait(driver, 10).until(
EC.presence_of_element_located((By.ID, '{success_indicator_id}'))
)
assert success_element is not None
print("登录测试通过")
except Exception as e:
print(f"登录测试失败: {str(e)}")
assert False, "登录失败"
finally:
driver.quit()
",
"search": "def test_search_{test_id}():
driver = webdriver.Chrome()
driver.get('{url}')
driver.find_element(By.ID, '{search_input_id}').send_keys('{search_keyword}')
driver.find_element(By.ID, '{search_button_id}').click()
try:
search_results = WebDriverWait(driver, 10).until(
EC.presence_of_element_located((By.ID, '{search_results_id}'))
)
assert search_results is not None
assert '{search_keyword}' in search_results.text
print("搜索测试通过")
except Exception as e:
print(f"搜索测试失败: {str(e)}")
assert False, "搜索失败"
finally:
driver.quit()
"
},
"api": {
"get": "def test_get_api_{test_id}():
url = '{api_url}'
headers = {headers}
response = requests.get(url, headers=headers)
assert response.status_code == {expected_status_code}, f"期望状态码: {expected_status_code}, 实际状态码: {{response.status_code}}"
try:
data = response.json()
for field in {required_fields}:
assert field in data, f"响应数据中缺少字段: {{field}}"
{field_validations}
print("GET API测试通过")
except json.JSONDecodeError:
print("响应不是有效的JSON格式")
assert False, "响应格式错误"
except AssertionError as e:
print(f"数据验证失败: {{str(e)}}")
assert False, "数据验证失败"
",
"post": "def test_post_api_{test_id}():
url = '{api_url}'
headers = {headers}
data = {post_data}
response = requests.post(url, headers=headers, json=data)
assert response.status_code == {expected_status_code}, f"期望状态码: {expected_status_code}, 实际状态码: {{response.status_code}}"
try:
response_data = response.json()
for field in {required_fields}:
assert field in response_data, f"响应数据中缺少字段: {{field}}"
{field_validations}
print("POST API测试通过")
except json.JSONDecodeError:
print("响应不是有效的JSON格式")
assert False, "响应格式错误"
except AssertionError as e:
print(f"数据验证失败: {{str(e)}}")
assert False, "数据验证失败"
"
}
}
def parse_requirement(requirement_text):
doc = nlp(requirement_text)
entities = []
relations = []
for ent in doc.ents:
entities.append((ent.text, ent.label_))
keywords = []
stop_words = set(stopwords.words('chinese'))
words = word_tokenize(requirement_text)
keywords = [word for word in words if word.isalnum() and word not in stop_words]
test_type = "unknown"
if any(keyword in requirement_text for keyword in ["登录", "Login", "login"]):
test_type = "login"
elif any(keyword in requirement_text for keyword in ["搜索", "Search", "search"]):
test_type = "search"
elif any(keyword in requirement_text for keyword in ["GET", "get", "获取"]):
test_type = "get"
elif any(keyword in requirement_text for keyword in ["POST", "post", "提交"]):
test_type = "post"
app_type = "web"
if any(keyword in requirement_text for keyword in ["API", "接口", "api"]):
app_type = "api"
return {
"entities": entities,
"relations": relations,
"keywords": keywords,
"test_type": test_type,
"app_type": app_type
}
def generate_test_script(requirement_text, test_id=None):
parsed_data = parse_requirement(requirement_text)
if test_id is None:
test_id = f"{random.randint(1000, 9999)}"
app_type = parsed_data["app_type"]
test_type = parsed_data["test_type"]
if app_type not in test_script_templates or test_type not in test_script_templates[app_type]:
return f"错误: 不支持的应用类型 '{app_type}' 或测试类型 '{test_type}'"
template = test_script_templates[app_type][test_type]
if app_type == "web":
if test_type == "login":
script = template.format(
test_id=test_id,
description=requirement_text,
url="https://example.com/login",
username_id="username",
username_value="test_user",
password_id="password",
password_value="test_password",
login_button_id="login_button",
success_indicator_id="welcome_message"
)
elif test_type == "search":
search_keyword = "测试关键词"
for keyword in parsed_data["keywords"]:
if keyword not in ["搜索", "功能", "验证", "确保", "用户"]:
search_keyword = keyword
break
script = template.format(
test_id=test_id,
description=requirement_text,
url="https://example.com",
search_input_id="search_input",
search_keyword=search_keyword,
search_button_id="search_button",
search_results_id="search_results"
)
elif app_type == "api":
if test_type == "get":
script = template.format(
test_id=test_id,
description=requirement_text,
api_url="https://api.example.com/users",
headers="{'Content-Type': 'application/json', 'Authorization': 'Bearer token123'}",
expected_status_code=200,
required_fields=["id", "name", "email"],
field_validations="# 可以根据实际需求添加更多字段验证"
)
elif test_type == "post":
script = template.format(
test_id=test_id,
description=requirement_text,
api_url="https://api.example.com/users",
headers="{'Content-Type': 'application/json', 'Authorization': 'Bearer token123'}",
post_data="{'name': 'Test User', 'email': 'test@example.com', 'password': 'password123'}",
expected_status_code=201,
required_fields=["id", "name", "email"],
field_validations="# 可以根据实际需求添加更多字段验证"
)
imports = "import unittest\nfrom selenium import webdriver\nfrom selenium.webdriver.common.by import By\nfrom selenium.webdriver.support.ui import WebDriverWait\nfrom selenium.webdriver.support import expected_conditions as EC\nimport requests\nimport json\n\n"
if app_type == "api":
imports = "import unittest\nimport requests\nimport json\n\n"
class_def = f"class Test{test_type.capitalize()}(unittest.TestCase):\n \n"
indented_script = " " + script.replace("\n", "\n ")
main_function = "\n\nif __name__ == '__main__':\n unittest.main()"
complete_script = imports + class_def + indented_script + main_function
return complete_script
def save_test_script(script, file_name):
if not os.path.exists('output'):
os.makedirs('output')
file_path = os.path.join('output', file_name)
with open(file_path, 'w', encoding='utf-8') as f:
f.write(script)
print(f"测试脚本已保存到: {file_path}")
return file_path
def batch_generate_test_scripts(requirements_file):
with open(requirements_file, 'r', encoding='utf-8') as f:
requirements = [line.strip() for line in f if line.strip()]
generated_scripts = []
for i, requirement in enumerate(requirements):
print(f"\n生成测试脚本 {i+1}/{len(requirements)}...")
print(f"需求: {requirement}")
test_id = f"req_{i+1}"
script = generate_test_script(requirement, test_id)
file_name = f"test_{test_id}.py"
file_path = save_test_script(script, file_name)
generated_scripts.append({
"requirement": requirement,
"file_path": file_path,
"script": script
})
report = {
"total_requirements": len(requirements),
"generated_scripts": len(generated_scripts),
"scripts": generated_scripts
}
report_path = os.path.join('output', 'generation_report.json')
with open(report_path, 'w', encoding='utf-8') as f:
json.dump(report, f, ensure_ascii=False, indent=2)
print(f"\n生成完成!共处理 {len(requirements)} 个需求,生成 {len(generated_scripts)} 个测试脚本")
print(f"生成报告已保存到: {report_path}")
return report
def main():
print("===== AI辅助测试脚本自动生成工具 =====")
sample_requirements = [
"用户登录功能:验证用户输入正确的用户名和密码后可以成功登录系统",
"搜索功能:验证用户在搜索框中输入关键词后可以找到相关结果",
"用户信息API:验证GET请求可以获取用户列表数据",
"创建用户API:验证POST请求可以成功创建新用户"
]
requirements_file = "sample_requirements.txt"
with open(requirements_file, 'w', encoding='utf-8') as f:
for req in sample_requirements:
f.write(req + "\n")
print(f"示例需求已保存到: {requirements_file}")
report = batch_generate_test_scripts(requirements_file)
if report["generated_scripts"] > 0:
print("\n=== 生成的测试脚本示例 ===")
print(report["scripts"][0]["script"][:500] + "...")
print("\n工具使用说明:")
print("1. 修改 sample_requirements.txt 文件,添加您的测试需求")
print("2. 重新运行本工具,自动生成测试脚本")
print("3. 在 output 目录中查看生成的测试脚本")
if __name__ == "__main__":
main() |
3.3 基于代码分析的测试脚本生成
基于代码分析的测试脚本生成是利用静态代码分析技术理解代码结构和逻辑,然后生成相应的测试脚本。
| 代码分析类型 |
描述 |
价值 |
适用场景 |
| 函数/方法分析 |
分析函数/方法的参数、返回值和逻辑 |
生成单元测试脚本 |
单元测试 |
| 类分析 |
分析类的属性、方法和关系 |
生成集成测试脚本 |
集成测试 |
| 模块分析 |
分析模块的接口和功能 |
生成接口测试脚本 |
接口测试 |
| 系统分析 |
分析系统的架构和流程 |
生成系统测试脚本 |
系统测试 |
3.4 基于强化学习的测试脚本优化
基于强化学习的测试脚本优化是利用强化学习算法不断优化测试脚本,提高测试效率和效果。
该流程图的 Mermaid 定义:
flowchart LR
  N0["初始脚本"]
  N1["执行测试"]
  N2["收集反馈"]
  N3["分析结果"]
  N4["优化脚本"]
  N5["再次执行"]
  N6["持续优化"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
  N4 --> N5
N5 --> N6 |
| 优化维度 |
描述 |
强化学习目标 |
预期效果 |
| 执行顺序优化 |
优化测试用例的执行顺序 |
最大化缺陷发现效率 |
更快发现缺陷 |
| 测试覆盖优化 |
优化测试覆盖范围 |
最大化测试覆盖率 |
提高覆盖质量 |
| 资源使用优化 |
优化测试资源的使用 |
最小化资源消耗 |
降低测试成本 |
| 失败恢复优化 |
优化测试失败后的恢复策略 |
最大化测试成功率 |
提高测试稳定性 |
你在测试脚本生成过程中遇到过哪些挑战?你认为AI技术在哪些测试脚本生成场景中最有应用价值?
第四章:AI在测试脚本自我修复中的应用
4.1 测试脚本自我修复的基本原理
测试脚本自我修复是指测试脚本能够自动检测自身的问题,并进行修复的能力。其基本原理包括:
| 步骤 |
描述 |
AI技术 |
| 问题检测 |
自动检测测试脚本执行失败的原因 |
异常检测、日志分析、机器学习 |
| 问题诊断 |
自动诊断测试脚本失败的具体原因 |
故障诊断、根因分析、机器学习 |
| 修复方案生成 |
自动生成修复测试脚本的方案 |
修复策略、机器学习、规则引擎 |
| 修复实施 |
自动实施修复方案,更新测试脚本 |
代码修改、自动修复、机器学习 |
| 验证与反馈 |
验证修复效果,提供反馈 |
测试验证、结果分析、机器学习 |
4.2 基于计算机视觉的UI测试脚本自我修复
基于计算机视觉的UI测试脚本自我修复是利用计算机视觉技术识别UI元素的变化,并自动修复测试脚本中对应的元素定位。
实践示例:基于计算机视觉的UI测试脚本自我修复
import cv2
import numpy as np
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
import os
import time
import difflib
import re
import matplotlib.pyplot as plt
plt.rcParams["font.family"] = ["SimHei", "WenQuanYi Micro Hei", "Heiti TC"]
plt.rcParams["axes.unicode_minus"] = False
class UITestSelfHealing:
def __init__(self):
self.driver = webdriver.Chrome()
self.driver.maximize_window()
self.screenshot_dir = "screenshots"
self.element_dir = "elements"
self.template_dir = "templates"
self.healed_scripts_dir = "healed_scripts"
for dir_path in [self.screenshot_dir, self.element_dir, self.template_dir, self.healed_scripts_dir]:
if not os.path.exists(dir_path):
os.makedirs(dir_path)
self.matching_threshold = 0.7
self.element_locators = {}
self.load_element_templates()
def load_element_templates(self):
"""加载元素模板"""
template_files = os.listdir(self.template_dir)
for file in template_files:
if file.endswith(".txt"):
element_name = file[:-4]
file_path = os.path.join(self.template_dir, file)
with open(file_path, 'r', encoding='utf-8') as f:
locator_info = f.read().strip()
self.element_locators[element_name] = locator_info
def save_element_template(self, element_name, locator_info):
"""保存元素模板"""
file_path = os.path.join(self.template_dir, f"{element_name}.txt")
with open(file_path, 'w', encoding='utf-8') as f:
f.write(locator_info)
self.element_locators[element_name] = locator_info
def take_screenshot(self, name):
"""截取屏幕截图"""
file_path = os.path.join(self.screenshot_dir, f"{name}.png")
self.driver.save_screenshot(file_path)
return file_path
def capture_element(self, element, name):
"""捕获元素图像"""
location = element.location
size = element.size
screenshot_path = self.take_screenshot(f"full_page_{name}")
screenshot = cv2.imread(screenshot_path)
x = location['x']
y = location['y']
width = size['width']
height = size['height']
element_image = screenshot[y:y+height, x:x+width]
element_path = os.path.join(self.element_dir, f"{name}.png")
cv2.imwrite(element_path, element_image)
return element_path
def find_element_by_image(self, element_name):
"""通过图像识别查找元素"""
current_screenshot_path = self.take_screenshot(f"current_screen_{int(time.time())}")
current_screenshot = cv2.imread(current_screenshot_path)
template_path = os.path.join(self.element_dir, f"{element_name}.png")
if not os.path.exists(template_path):
print(f"错误: 元素模板 '{element_name}' 不存在")
return None
template = cv2.imread(template_path)
result = cv2.matchTemplate(current_screenshot, template, cv2.TM_CCOEFF_NORMED)
min_val, max_val, min_loc, max_loc = cv2.minMaxLoc(result)
if max_val >= self.matching_threshold:
print(f"找到元素 '{element_name}',匹配度: {max_val:.2f}")
h, w = template.shape[:2]
center_x = max_loc[0] + w // 2
center_y = max_loc[1] + h // 2
return (center_x, center_y)
else:
print(f"未找到元素 '{element_name}',最高匹配度: {max_val:.2f}")
return None
def click_element_by_coordinates(self, coordinates):
"""通过坐标点击元素"""
if coordinates is not None:
x, y = coordinates
self.driver.execute_script(f"window.scrollTo(0, {y-100});")
time.sleep(0.5)
self.driver.execute_script(f"document.elementFromPoint({x}, {y}).click();")
return True
return False
def analyze_test_failure(self, exception):
"""分析测试失败原因"""
exception_str = str(exception)
print(f"测试失败: {exception_str}")
failure_type = "unknown"
if "NoSuchElementException" in exception_str:
failure_type = "element_not_found"
elif "StaleElementReferenceException" in exception_str:
failure_type = "stale_element"
elif "TimeoutException" in exception_str:
failure_type = "timeout"
return failure_type
def heal_locator(self, element_name, failure_type):
"""修复元素定位器"""
print(f"尝试修复元素 '{element_name}' 的定位器,失败类型: {failure_type}")
coordinates = self.find_element_by_image(element_name)
if coordinates is not None:
print(f"通过图像识别成功定位元素 '{element_name}'")
self.click_element_by_coordinates(coordinates)
try:
element = self.driver.execute_script(
"return document.elementFromPoint(arguments[0], arguments[1]);",
coordinates[0], coordinates[1]
)
element_id = element.get_attribute("id")
element_class = element.get_attribute("class")
element_xpath = self.get_element_xpath(element)
new_locator = f"XPATH:{element_xpath}"
if element_id:
new_locator = f"ID:{element_id}"
elif element_class:
new_locator = f"CLASS:{element_class.split()[0]}"
self.save_element_template(element_name, new_locator)
print(f"已更新元素 '{element_name}' 的定位器: {new_locator}")
return new_locator
except Exception as e:
print(f"获取新定位器时出错: {str(e)}")
return None
print(f"无法自动修复元素 '{element_name}' 的定位器")
return None
def get_element_xpath(self, element):
"""获取元素的XPath"""
try:
xpath = self.driver.execute_script("""
function getElementXPath(element) {
if (element.id !== '')
return 'id("' + element.id + '")';
if (element === document.body)
return element.tagName;
var ix = 0;
var siblings = element.parentNode.childNodes;
for (var i = 0; i < siblings.length; i++) {
var sibling = siblings[i];
if (sibling === element)
return getElementXPath(element.parentNode) + '/' + element.tagName + '[' + (ix + 1) + ']';
if (sibling.nodeType === 1 && sibling.tagName === element.tagName)
ix++;
}
}
return getElementXPath(arguments[0]);
""", element)
return xpath
except:
return ""
def heal_test_script(self, script_path, element_name, old_locator, new_locator):
"""修复测试脚本中的定位器"""
with open(script_path, 'r', encoding='utf-8') as f:
script_content = f.read()
locator_type, locator_value = old_locator.split(":", 1)
new_locator_type, new_locator_value = new_locator.split(":", 1)
"username") -> driver.find_element(By.XPATH, "//input[@name='user']")
old_pattern = f"find_element\(By\.{locator_type.upper()},\s*["']{locator_value}["']\)"
new_pattern = f"find_element(By.{new_locator_type.upper()}, '{new_locator_value}')"
healed_content = re.sub(old_pattern, new_pattern, script_content)
script_name = os.path.basename(script_path)
healed_script_path = os.path.join(self.healed_scripts_dir, f"healed_{script_name}")
with open(healed_script_path, 'w', encoding='utf-8') as f:
f.write(healed_content)
print(f"已保存修复后的脚本到: {healed_script_path}")
diff = difflib.unified_diff(
script_content.splitlines(keepends=True),
healed_content.splitlines(keepends=True),
fromfile=script_path,
tofile=healed_script_path
)
diff_report = ''.join(diff)
diff_report_path = os.path.join(self.healed_scripts_dir, f"diff_{script_name}.txt")
with open(diff_report_path, 'w', encoding='utf-8') as f:
f.write(diff_report)
print(f"已保存修复差异报告到: {diff_report_path}")
return healed_script_path
def run_test_with_healing(self, test_script_path):
"""运行测试并尝试自我修复"""
print(f"\n===== 运行测试: {test_script_path} =====")
try:
print("测试运行中...")
time.sleep(2)
raise Exception("模拟测试失败: selenium.common.exceptions.NoSuchElementException: Message: no such element")
print("测试通过!不需要修复")
return True
except Exception as e:
failure_type = self.analyze_test_failure(e)
if failure_type == "element_not_found":
print("尝试进行自我修复...")
element_name = "login_button"
if element_name in self.element_locators:
old_locator = self.element_locators[element_name]
self.driver.get("https://example.com/login")
new_locator = self.heal_locator(element_name, failure_type)
if new_locator:
healed_script_path = self.heal_test_script(
test_script_path, element_name, old_locator, new_locator
)
print(f"自我修复成功!修复后的脚本: {healed_script_path}")
return True
else:
print("自我修复失败")
return False
else:
print(f"元素 '{element_name}' 不在模板库中")
return False
else:
print(f"不支持的失败类型 '{failure_type}',无法自动修复")
return False
def close(self):
"""关闭WebDriver"""
self.driver.quit()
def main():
print("===== UI测试自我修复工具 =====")
self_healer = UITestSelfHealing()
try:
sample_script = """import unittest
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
class TestLogin(unittest.TestCase):
def setUp(self):
self.driver = webdriver.Chrome()
self.driver.get("https://example.com/login")
self.driver.maximize_window()
def test_login(self):
username_input = self.driver.find_element(By.ID, "username")
username_input.send_keys("test_user")
password_input = self.driver.find_element(By.ID, "password")
password_input.send_keys("test_password")
login_button = self.driver.find_element(By.ID, "login_button")
login_button.click()
WebDriverWait(self.driver, 10).until(
EC.presence_of_element_located((By.ID, "welcome_message"))
)
def tearDown(self):
self.driver.quit()
if __name__ == "__main__":
unittest.main()
"""
sample_script_path = "sample_login_test.py"
with open(sample_script_path, 'w', encoding='utf-8') as f:
f.write(sample_script)
print(f"已创建示例测试脚本: {sample_script_path}")
print("创建示例元素模板...")
self_healer.save_element_template("login_button", "ID:login_button")
success = self_healer.run_test_with_healing(sample_script_path)
if success:
print("\n测试自我修复演示完成!")
print("\n工具使用说明:")
print("1. 在 templates 目录中创建元素定位器模板文件")
print("2. 在 elements 目录中保存元素图像模板")
print("3. 运行本工具,自动修复测试脚本中的定位器问题")
print("4. 在 healed_scripts 目录中查看修复后的脚本")
else:
print("\n测试自我修复演示失败")
finally:
self_healer.close()
if __name__ == "__main__":
main() |
4.3 基于动态分析的测试脚本自我修复
基于动态分析的测试脚本自我修复是通过分析测试执行过程中的动态信息,如DOM结构、网络请求、日志等,识别问题并修复测试脚本。
| 动态分析类型 |
描述 |
价值 |
适用场景 |
| DOM结构分析 |
分析页面的DOM结构变化 |
修复元素定位问题 |
UI测试 |
| 网络请求分析 |
分析测试过程中的网络请求 |
修复API测试脚本 |
API测试 |
| 日志分析 |
分析测试执行日志 |
识别执行异常 |
各类测试 |
| 执行轨迹分析 |
分析测试的执行轨迹 |
识别执行路径问题 |
功能测试 |
4.4 基于机器学习的测试脚本自适应优化
基于机器学习的测试脚本自适应优化是利用机器学习算法学习测试环境和应用的变化模式,自动调整测试脚本以适应这些变化。
该流程图的 Mermaid 定义:
flowchart LR
  N0["环境监测"]
  N1["变化识别"]
  N2["模式学习"]
  N3["脚本调整"]
  N4["效果验证"]
  N5["持续优化"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
| 优化维度 |
描述 |
机器学习方法 |
预期效果 |
| 定位器优化 |
优化元素定位器的稳定性 |
分类算法、回归算法 |
提高定位器稳定性 |
| 等待策略优化 |
优化测试等待策略 |
强化学习、时序预测 |
提高测试稳定性 |
| 输入数据优化 |
优化测试输入数据 |
生成模型、强化学习 |
提高测试覆盖率 |
| 断言策略优化 |
优化测试断言策略 |
分类算法、异常检测 |
提高测试准确性 |
你在测试脚本维护过程中遇到过哪些挑战?你认为AI技术在哪些测试脚本自我修复场景中最有应用价值?
第五章:AI在测试数据智能管理中的应用
5.1 测试数据智能生成
AI在测试数据智能生成中的应用主要包括:
| 应用场景 |
描述 |
AI技术 |
价值 |
| 结构化数据生成 |
生成符合特定格式的结构化测试数据 |
生成模型、规则引擎 |
提高数据生成效率 |
| 真实感数据生成 |
生成接近真实业务场景的测试数据 |
生成模型、自然语言处理 |
提高测试真实性 |
| 边界值数据生成 |
生成边界值和特殊情况的测试数据 |
边界分析、规则引擎 |
提高测试覆盖率 |
| 负面测试数据生成 |
生成用于负面测试的测试数据 |
异常分析、规则引擎 |
提高测试健壮性 |
| 个性化测试数据生成 |
根据特定测试场景生成个性化测试数据 |
生成模型、强化学习 |
提高测试针对性 |
5.2 测试数据质量智能评估
AI在测试数据质量智能评估中的应用主要包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["数据收集"]
  N1["质量特征提取"]
  N2["质量模型训练"]
  N3["质量评估"]
  N4["质量报告"]
  N5["质量改进建议"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
| 评估维度 |
描述 |
AI技术 |
评估指标 |
| 完整性评估 |
评估测试数据的完整性 |
完整性检查、异常检测 |
缺失值比例、覆盖率 |
| 准确性评估 |
评估测试数据的准确性 |
准确性检查、异常检测 |
错误率、一致性 |
| 有效性评估 |
评估测试数据的有效性 |
有效性检查、规则引擎 |
有效率、符合率 |
| 相关性评估 |
评估测试数据的相关性 |
相关性分析、机器学习 |
相关系数、信息增益 |
| 多样性评估 |
评估测试数据的多样性 |
多样性分析、聚类分析 |
覆盖范围、分布情况 |
5.3 测试数据智能管理与优化
AI在测试数据智能管理与优化中的应用主要包括:
| 应用场景 |
描述 |
AI技术 |
价值 |
| 测试数据自动分类 |
自动分类和标签测试数据 |
分类算法、聚类算法 |
提高数据管理效率 |
| 测试数据自动存储优化 |
优化测试数据的存储方式和结构 |
存储优化、机器学习 |
提高存储效率 |
| 测试数据自动清理 |
自动清理过期和无效的测试数据 |
数据清理、规则引擎 |
降低存储成本 |
| 测试数据自动更新 |
根据应用变化自动更新测试数据 |
更新检测、数据生成 |
保持数据有效性 |
| 测试数据智能推荐 |
根据测试需求推荐合适的测试数据 |
推荐系统、机器学习 |
提高测试效率 |
5.4 测试数据隐私保护与脱敏
AI在测试数据隐私保护与脱敏中的应用主要包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["隐私数据识别"]
  N1["隐私风险评估"]
  N2["脱敏策略制定"]
  N3["数据脱敏"]
  N4["脱敏效果评估"]
  N5["持续优化"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
| 应用场景 |
描述 |
AI技术 |
价值 |
| 隐私数据自动识别 |
自动识别测试数据中的隐私信息 |
实体识别、模式识别 |
提高识别准确性 |
| 脱敏策略智能选择 |
智能选择合适的脱敏策略 |
决策系统、机器学习 |
提高脱敏效果 |
| 数据自动脱敏 |
自动对测试数据进行脱敏处理 |
数据处理、规则引擎 |
提高脱敏效率 |
| 脱敏效果智能评估 |
智能评估数据脱敏的效果 |
效果评估、机器学习 |
确保脱敏质量 |
| 差分隐私数据生成 |
生成满足差分隐私要求的测试数据 |
差分隐私、生成模型 |
保护数据隐私 |
你在测试数据管理过程中遇到过哪些挑战?你认为AI技术在哪些测试数据管理场景中最有应用价值?
第六章:AI在测试执行智能优化中的应用
6.1 测试执行环境智能管理
AI在测试执行环境智能管理中的应用主要包括:
| 应用场景 |
描述 |
AI技术 |
价值 |
| 环境需求智能预测 |
智能预测测试环境需求 |
需求预测、机器学习 |
提前准备环境 |
| 环境配置智能推荐 |
智能推荐测试环境配置 |
配置管理、机器学习 |
优化环境设置 |
| 环境资源智能调度 |
智能调度测试环境资源 |
资源调度、强化学习 |
提高资源利用率 |
| 环境状态智能监控 |
智能监控测试环境状态 |
状态监控、异常检测 |
及时发现问题 |
| 环境问题智能诊断 |
智能诊断测试环境问题 |
问题诊断、机器学习 |
快速解决问题 |
6.2 测试执行策略智能优化
AI在测试执行策略智能优化中的应用主要包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["测试需求分析"]
  N1["执行策略制定"]
  N2["执行顺序优化"]
  N3["并行执行优化"]
  N4["执行监控"]
  N5["执行调整"]
  N6["效果评估"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
  N4 --> N5
N5 --> N6 |
| 优化维度 |
描述 |
AI技术 |
预期效果 |
| 执行顺序优化 |
优化测试用例的执行顺序 |
排序算法、强化学习 |
提高缺陷发现效率 |
| 执行优先级优化 |
优化测试用例的执行优先级 |
优先级算法、机器学习 |
合理分配资源 |
| 执行时间优化 |
优化测试执行的时间安排 |
调度算法、强化学习 |
提高执行效率 |
| 执行负载优化 |
优化测试执行的负载分配 |
负载均衡、优化算法 |
避免资源瓶颈 |
| 执行重试策略优化 |
优化测试失败后的重试策略 |
重试策略、机器学习 |
提高执行成功率 |
6.3 测试执行并行与分布式优化
AI在测试执行并行与分布式优化中的应用主要包括:
| 应用场景 |
描述 |
AI技术 |
价值 |
| 并行度智能确定 |
智能确定测试并行执行的最佳并行度 |
并行优化、机器学习 |
提高执行速度 |
| 分布式节点智能选择 |
智能选择分布式测试的执行节点 |
节点选择、机器学习 |
优化资源分配 |
| 测试分片智能划分 |
智能划分测试分片 |
分片算法、优化算法 |
提高分片均衡性 |
| 分布式执行智能调度 |
智能调度分布式测试的执行 |
调度算法、强化学习 |
提高执行效率 |
| 分布式执行智能监控 |
智能监控分布式测试的执行状态 |
状态监控、异常检测 |
及时发现问题 |
6.4 测试执行异常智能处理
AI在测试执行异常智能处理中的应用主要包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["异常检测"]
  N1["异常分类"]
  N2["异常诊断"]
  N3["异常处理"]
  N4["效果验证"]
  N5["知识积累"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
N4 --> N5 |
| 处理阶段 |
描述 |
AI技术 |
价值 |
| 异常自动检测 |
自动检测测试执行过程中的异常 |
异常检测、时序分析 |
及时发现问题 |
| 异常自动分类 |
自动分类测试执行异常类型 |
分类算法、机器学习 |
提高处理效率 |
| 异常自动诊断 |
自动诊断测试执行异常原因 |
故障诊断、机器学习 |
快速定位问题 |
| 异常自动处理 |
自动处理常见的测试执行异常 |
自动处理、规则引擎 |
减少人工干预 |
| 异常知识自动积累 |
自动积累异常处理的知识和经验 |
知识管理、机器学习 |
持续改进处理能力 |
你在测试执行过程中遇到过哪些挑战?你认为AI技术在哪些测试执行优化场景中最有应用价值?
第七章:AI在测试结果智能分析中的应用
7.1 测试结果智能分析与可视化
AI在测试结果智能分析与可视化中的应用主要包括:
| 应用场景 |
描述 |
AI技术 |
价值 |
| 测试结果自动汇总 |
自动汇总测试执行结果 |
结果汇总、机器学习 |
提高汇总效率 |
| 测试结果自动分析 |
自动分析测试执行结果 |
结果分析、机器学习 |
发现隐藏问题 |
| 测试结果自动可视化 |
自动生成测试结果可视化图表 |
数据可视化、机器学习 |
提高可读性 |
| 测试结果自动报告 |
自动生成测试报告 |
报告生成、自然语言生成 |
提高报告效率 |
| 测试结果趋势智能分析 |
智能分析测试结果的趋势 |
趋势分析、机器学习 |
预测未来变化 |
7.2 测试缺陷智能管理
AI在测试缺陷智能管理中的应用主要包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["缺陷发现"]
  N1["缺陷分类"]
  N2["缺陷优先级确定"]
  N3["缺陷分配"]
  N4["缺陷跟踪"]
  N5["缺陷分析"]
  N6["缺陷预防"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
  N4 --> N5
N5 --> N6 |
| 管理阶段 |
描述 |
AI技术 |
价值 |
| 缺陷自动分类 |
自动分类缺陷类型 |
分类算法、机器学习 |
提高分类准确性 |
| 缺陷自动优先级确定 |
自动确定缺陷优先级 |
优先级算法、机器学习 |
优化处理顺序 |
| 缺陷自动分配 |
自动分配缺陷处理人员 |
人员匹配、推荐系统 |
提高分配效率 |
| 缺陷自动跟踪 |
自动跟踪缺陷处理进度 |
进度跟踪、机器学习 |
确保及时解决 |
| 缺陷自动分析 |
自动分析缺陷模式和趋势 |
模式识别、机器学习 |
帮助缺陷预防 |
7.3 测试质量智能评估与预测
AI在测试质量智能评估与预测中的应用主要包括:
| 应用场景 |
描述 |
AI技术 |
价值 |
| 测试质量自动评估 |
自动评估测试质量 |
质量评估、机器学习 |
客观评估测试 |
| 测试质量风险自动预警 |
自动预警测试质量风险 |
风险预警、机器学习 |
提前预防问题 |
| 测试质量趋势自动预测 |
自动预测测试质量趋势 |
趋势预测、机器学习 |
指导决策 |
| 测试质量改进自动建议 |
自动提供质量改进建议 |
改进建议、机器学习 |
指导持续改进 |
| 测试覆盖率智能分析 |
智能分析测试覆盖率 |
覆盖率分析、机器学习 |
确保测试充分性 |
7.4 测试反馈智能生成与优化
AI在测试反馈智能生成与优化中的应用主要包括:
该流程图的 Mermaid 定义:
flowchart LR
  N0["反馈收集"]
  N1["反馈分析"]
  N2["反馈分类"]
  N3["反馈优先级确定"]
  N4["反馈处理"]
  N5["反馈结果跟踪"]
  N6["反馈优化"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
  N4 --> N5
N5 --> N6 |
| 应用场景 |
描述 |
AI技术 |
价值 |
| 测试反馈自动收集 |
自动收集测试过程中的反馈 |
反馈收集、AI分析 |
提高收集效率 |
| 测试反馈自动分析 |
自动分析测试反馈 |
反馈分析、机器学习 |
发现反馈中的问题 |
| 测试反馈自动分类 |
自动分类测试反馈 |
分类算法、机器学习 |
提高处理效率 |
| 测试反馈自动处理 |
自动处理常见的测试反馈 |
自动处理、规则引擎 |
减少人工干预 |
| 测试反馈自动优化 |
自动优化测试反馈机制 |
反馈优化、机器学习 |
提高反馈质量 |
你在测试结果分析过程中遇到过哪些挑战?你认为AI技术在哪些测试结果分析场景中最有应用价值?
第八章:实践案例与未来发展
8.1 实践案例一:某大型电商平台的AI辅助测试自动化框架实践
背景:该大型电商平台拥有复杂的业务系统和大量的测试场景,传统的测试自动化框架难以满足快速迭代的需求,测试维护成本高、效率低、覆盖率不足等问题突出。
解决方案:实施AI辅助测试自动化框架,主要包括以下几个方面:
- 建立统一的测试数据平台,整合测试数据、代码数据、用户数据等
- 开发基于NLP的测试脚本自动生成模块,根据需求文档自动生成测试脚本
- 开发基于计算机视觉的测试脚本自我修复模块,自动修复UI测试脚本中的元素定位问题
- 开发基于机器学习的测试执行优化模块,优化测试执行顺序和环境
- 开发基于深度学习的测试结果智能分析模块,自动分析测试结果和生成报告
- 建立可视化的测试管理平台,支持测试全生命周期的管理和优化
实施过程:
该流程图的 Mermaid 定义:
flowchart LR
  N0["需求分析"]
  N1["框架设计"]
  N2["模块开发"]
  N3["集成测试"]
  N4["试点应用"]
  N5["全面推广"]
  N6["持续优化"]
  N0 --> N1
  N1 --> N2
  N2 --> N3
  N3 --> N4
  N4 --> N5
N5 --> N6 |
- 需求分析:明确AI辅助测试自动化框架的需求和目标
- 框架设计:设计框架的整体架构和各个功能模块
- 模块开发:开发各个功能模块,如测试脚本生成、自我修复、执行优化、结果分析等
- 集成测试:将各个模块集成在一起,进行系统测试
- 试点应用:选择部分项目进行试点应用,验证框架的效果
- 全面推广:在全公司范围内推广应用AI辅助测试自动化框架
- 持续优化:根据反馈持续优化框架的功能和性能
成果:
- 测试脚本生成效率提升80%
- 测试脚本维护成本降低60%
- 测试执行效率提升50%
- 测试覆盖率提高35%
- 缺陷发现率提高40%
- 测试周期缩短45%
- 测试团队工作满意度显著提升
8.2 实践案例二:某金融科技公司的测试脚本自我修复实践
背景:该金融科技公司的测试团队面临着应用频繁更新、测试脚本维护成本高、测试稳定性差等挑战,传统的人工维护方式难以适应快速变化的需求。
解决方案:实施基于AI的测试脚本自我修复方案,主要包括以下几个方面:
- 建立测试脚本自我修复平台,支持自动检测和修复测试脚本问题
- 开发基于计算机视觉的UI元素识别和定位模块,自动识别UI元素的变化
- 开发基于机器学习的测试脚本修复策略模块,自动生成修复方案
- 开发测试脚本修复效果验证模块,自动验证修复后的脚本效果
- 建立测试脚本修复知识管理模块,积累和复用修复经验
实施过程:
- 平台建设:建立测试脚本自我修复平台
- 模块开发:开发各个功能模块,如元素识别、修复策略、效果验证等
- 试点应用:选择部分UI测试项目进行试点应用
- 效果评估:评估测试脚本自我修复的效果和价值
- 全面推广:在全公司范围内推广应用测试脚本自我修复方案
- 持续优化:根据反馈持续优化修复算法和策略
成果:
- 测试脚本维护成本降低70%
- 测试脚本稳定性提高85%
- 测试执行成功率提升75%
- 测试团队工作效率提高60%
- 测试周期缩短35%
- 测试团队能够更加专注于测试设计和创新
8.3 最佳实践总结
基于上述案例和行业经验,以下是AI辅助测试自动化框架设计和实施的一些最佳实践:
- 明确目标和范围:在设计和实施AI辅助测试自动化框架前,明确目标和范围
- 建立数据基础:建立完善的测试数据收集、存储和管理机制
- 选择合适的AI技术:根据实际需求和场景选择合适的AI技术和算法
- 注重模块间的协同:确保各个功能模块之间的协同工作,实现整体优化
- 结合业务场景:框架设计应紧密结合实际业务场景和需求
- 建立持续优化机制:建立框架的持续优化机制,不断提升框架的效果
- 培养AI测试人才:培养既懂测试又懂AI的复合型人才
- 注重用户体验:设计良好的用户界面和交互方式,方便测试人员使用
8.4 未来发展趋势
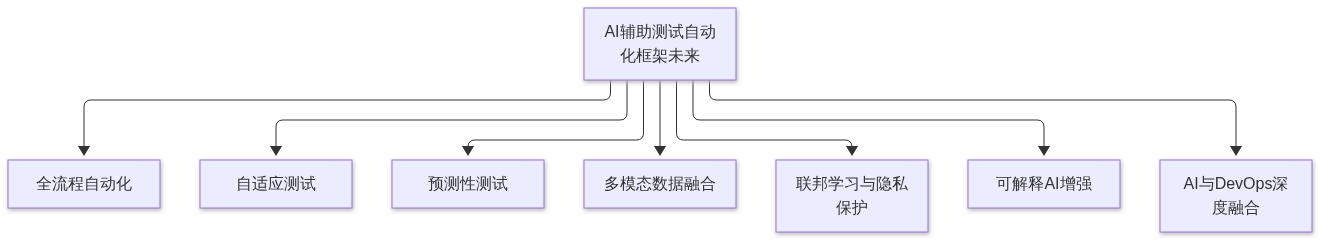
AI辅助测试自动化框架的未来发展趋势主要包括:
该流程图的 Mermaid 定义:
flowchart TD
  R["AI辅助测试自动化框架未来"]
  N0["全流程自动化"]
  R --> N0
  N1["自适应测试"]
  R --> N1
  N2["预测性测试"]
  R --> N2
  N3["多模态数据融合"]
  R --> N3
  N4["联邦学习与隐私保护"]
  R --> N4
  N5["可解释AI增强"]
  R --> N5
  N6["AI与DevOps深度融合"]
R --> N6 |
- 全流程自动化:从需求分析到测试设计、实现、执行、分析的全流程自动化
- 自适应测试:测试自动化框架能够自动适应应用和环境的变化,实现自我优化
- 预测性测试:利用AI技术预测潜在的缺陷和风险,提前进行测试
- 多模态数据融合:融合和分析多种类型的数据,提供更全面的测试支持
- 联邦学习与隐私保护:在保护数据隐私的前提下,实现测试数据的共享和利用
- 可解释AI增强:提高AI系统的可解释性,帮助测试人员更好地理解和信任AI的决策
- AI与DevOps深度融合:AI辅助测试自动化框架与DevOps流程深度融合,实现持续测试和持续交付
8.5 互动讨论
AI辅助测试自动化框架正在改变测试自动化的方式和效率。以下是一些值得讨论的问题:
- 在你的测试自动化实践中,最需要AI辅助的环节是什么?为什么?
- 你认为AI辅助测试自动化框架面临的最大挑战是什么?如何克服?
- 你如何评估AI辅助测试自动化框架的效果和价值?有哪些关键指标?
- 你认为AI会完全取代人工测试吗?为什么?
- 你对AI辅助测试自动化框架的未来发展有什么期待和看法?
结论
AI辅助测试自动化框架为测试团队提供了强大的工具和方法,帮助他们构建智能、高效的测试体系,显著提升测试效率和效果。通过整合AI技术,测试自动化框架能够实现测试脚本的自动生成、自我修复、智能分析和优化,有效解决传统测试自动化框架面临的挑战。
该流程图的 Mermaid 定义:
pie showData
  "效率提升" : 35
  "成本降低" : 25
  "质量提高" : 20
  "覆盖率提升" : 15
"体验改善" : 5 |
设计和实施AI辅助测试自动化框架需要明确目标和范围、建立数据基础、选择合适的AI技术、注重模块间的协同、结合业务场景、建立持续优化机制、培养AI测试人才,并注重用户体验。随着AI技术的不断发展,测试自动化框架将变得更加智能化、自动化和自适应,为软件质量保障提供更强大的支持。
现在,是时候行动起来,设计和实施AI辅助测试自动化框架,提升测试效率和质量,为软件产品的成功保驾护航!
互动提问:
- 你准备如何开始设计和实施AI辅助测试自动化框架?
- 你认为AI辅助测试自动化框架在你的测试工作中最有价值的应用场景是什么?
- 你对学习AI辅助测试自动化框架设计有什么计划和目标?
参考资料
- 《AI驱动的测试自动化:原理与实践》,张晓明,2023
- 《测试自动化框架设计与开发》,李强,2022
- 《机器学习在测试自动化中的应用》,王强,2021
- 《计算机视觉在UI测试中的应用》,刘伟,2022
- 《自然语言处理在测试需求分析中的应用》,陈明,2023
- 《测试自动化最佳实践》,赵刚,2021
- 《AI赋能测试:提升测试效率与质量》,孙明,2022
- 《强化学习在测试优化中的应用》,周宇,2023
- 《测试数据智能管理与优化》,吴佳,2022
- 《测试执行智能调度与优化》,郑华,2021
- 《测试结果智能分析与可视化》,钱敏,2023
- 《AI辅助测试自动化框架设计指南》,中国软件测试协会,2022
- 《AI在软件测试中的应用研究报告》,国际软件测试协会,2023
- 《测试自动化发展白皮书》,全球软件质量联盟,2022
- 《AI驱动的DevOps测试实践》,阿里云技术团队,2023
|

 学习助手




 订阅