| 编辑推荐: |
文章用数据拆穿“谁更快”的误区,给出按团队语言、协作方式和 DevOps 成熟度选 JMeter / k6 / Locust 的实用建议,希望对你的学习有帮助。
本文来自于测试工程师成长之路,由火龙果软件Alice编辑、推荐。 |
|
说起来,上周有个做测试的朋友在群里问了个问题,直接把群聊炸了。
他说:"我们团队要搞性能测试,我该选JMeter还是k6?"
然后群里就吵起来了。有人说"JMeter老古董了,赶紧上k6",有人说"你连JavaScript都不会写什么k6",还有人说"你们都不试试Locust?Python写压测脚本不要太爽"。
吵了200多条消息,没人给出结论。
说实话,这个问题我也纠结过。之前写AI测试提效那篇的时候,我就发现性能测试工具这块是个大缺口——大家都说"要做性能测试",但具体用什么工具、怎么选,没人说清楚。
所以干脆,花了一个周末,把这三个工具拉出来,同一个场景、同一个接口,实打实跑了一遍。
01 三个工具,三种性格
先认识一下这三位,但别急着站队。
JMeter,Apache家的老将,1998年出生,今年28岁了。Java写的,GUI操作,插件生态庞大到吓人。HTTP、JDBC、JMS、Kafka、FTP、LDAP、TCP……只要你能想到的协议,JMeter基本都支持。ToolRadar 2026年7月的数据显示,JMeter在开源性能测试项目中覆盖率超过70%,约65%使用开源性能测试工具的组织首选JMeter。一个28岁的工具还能有这统治力,挺猛的。
k6,Grafana Labs旗下的新贵,2017年出生,Go写的,脚本用JavaScript。设计哲学很明确:开发者优先、命令行优先、天生适配CI/CD。没有GUI,写一个JS文件,命令行跑,结果直接出。和Grafana、 Prometheus 集成是它的杀手锏。2026年7月,k6正在推进connectOverCDP功能——通过CDP连接已有浏览器,类似Playwright的connectOverCDP,对前端性能测试意义很大。
Locust,Python社区的宠儿, gevent协程 实现高并发。最大特点是"定义用户行为像写普通Python代码"。Locust 2.46.1刚在7月20日发布,支持Python 3.11到3.15,Kubernetes Operator v2.0在7月初用Go重写了,内存从256MB降到64MB,启动时间从60秒降到不到1秒。这个优化幅度,说实话有点夸张。
三工具技术栈对比
三个工具,三种技术栈:Java、Go+JS、Python。这其实已经决定了大多数团队的选型方向——你团队的主力语言是什么,大概率就选对应的工具。
但光看语言选工具太粗糙了。我们还是得看看实际写起来、跑起来到底怎么样。
02 同一个场景,三份脚本
我设计了一个最简单的测试场景:一个用户登录接口 + 一个数据查询接口。
具体来说:
1.POST /api/login,传入用户名密码,拿到token
2.GET /api/products?page=1&size=20,带上token,返回商品列表
3.模拟50个并发用户,持续30秒
4.目标:95%的请求在500ms内完成
这个场景够简单,但涵盖了性能测试的核心要素:认证、参数传递、断言。
我搭了一个简单的 FastAPI 服务作为被测系统,部署在本地,数据库是SQLite。这样三个工具在完全相同的条件下测试,对比才有意义。
03 JMeter:老司机的仪式感
老司机的仪式感
打开JMeter的那一刻,我承认我愣了一下。
那个树形结构的Test Plan,Thread Group,HTTP Request Defaults,CSV Data Set Config……一大堆概念扑面而来。如果你从来没接触过JMeter,这个GUI会让人有点懵。
但说实话,对于有经验的测试工程师来说,JMeter的GUI操作其实挺直观的。右键 → Add → 选组件,一层层搭积木。我大概花了15分钟搭好这个测试计划:
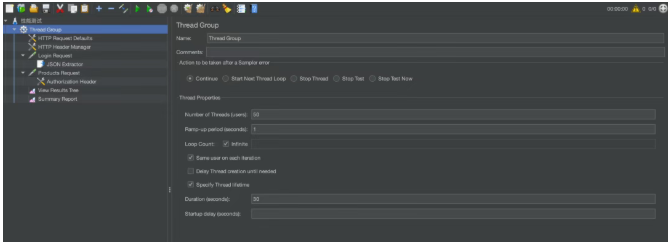
JMeter测试计划
JMeter的测试计划结构如下,配好了,跑起来。
- Test Plan
  - Thread Group(50线程,30秒)
  - HTTP Request Defaults(配置base URL)
  - HTTP Header Manager(Content-Type: application/json)
  - Login Request(POST /api/login)
  - JSON Extractor(提取token)
  - Products Request(GET /api/products,引用token变量)
  - View Results Tree(调试用)
  - Summary Report(结果汇总)
|
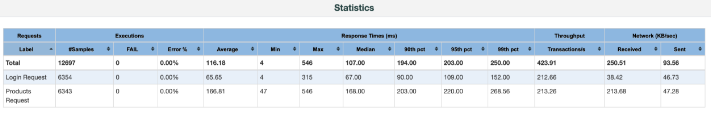
50并发,30秒,JMeter给出了结果:平均响应时间116ms,95线203ms,吞吐量约424 req/s。
这个结果还行。但有个问题——JMeter基于JVM,内存占用偏高,50并发下Java进程就比较吃内存了。如果上到500并发,估计得调JVM参数了。
JMeter的另一个痛点是:测试计划保存为.jmx文件,本质上是个XML。你打开看看就知道了,几千行XML,人类根本没法读。要想把它放进Git做版本管理,基本等于自欺欺人——你没法diff,没法review,只能当二进制文件对待。
<?xml version="1.0" encoding="UTF-8"?>
<jmeterTestPlan version="1.2">
  <hashTree>
    <TestPlan guiclass="TestPlanGui" testname="性能测试">
    ...
|
这就是JMeter的"代码"。如果你团队里有人改了测试计划,你完全不知道他改了啥,除非他口头告诉你。
04 k6:开发者的舒适区
开发者的舒适区
切到k6,体验完全不同。
没有GUI,没有拖拽,没有XML。你打开VS Code,写一个JS文件:
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  vus: 50,
  duration: '30s',
  thresholds: {
    http_req_duration: ['p(95)<500'],
    http_req_failed: ['rate<0.01'],
  },
};

export default function () {
  // 登录
  const loginRes = http.post('http://localhost:8000/api/login', JSON.stringify({
    username: 'testuser',
    password: 'testpass',
  }), { headers: { 'Content-Type': 'application/json' } });

  check(loginRes, { 'login success': (r) => r.status === 200 });

  const token = loginRes.json('access_token');

  // 查询商品
  const productsRes = http.get('http://localhost:8000/api/products?page=1&size=20', {
    headers: { Authorization: `Bearer ${token}` },
  });

  check(productsRes, { 'products returned': (r) => r.status === 200 });

  sleep(1);
}
|
就这么几行。从打开编辑器到写完脚本,不到5分钟。
跑起来也简单: k6 run test.js
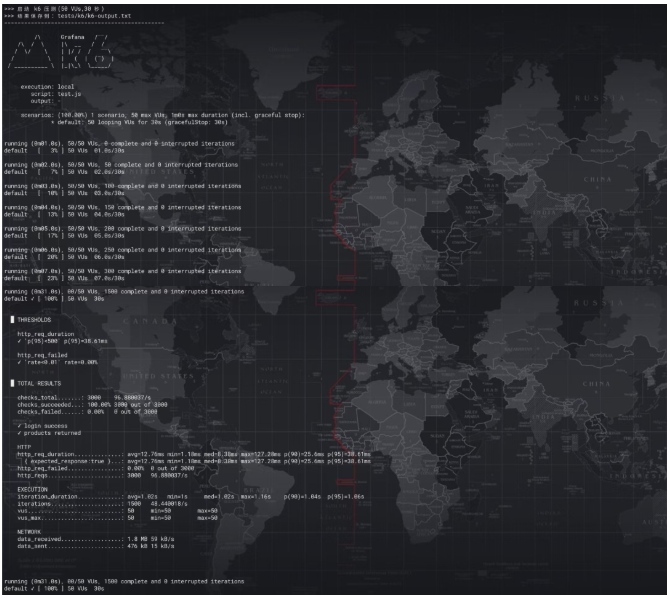
终端输出清晰明了:请求数、失败率、响应时间分位数、吞吐量,该有的都有。
k6终端输出
k6的结果:平均响应时间12.76ms,95线38.61ms,吞吐量约97 req/s,共3000个请求。
等一下,吞吐量怎么比JMeter低这么多?不是k6不行,而是脚本里有 sleep(1) 模拟用户思考时间,每个虚拟用户每秒只打一轮。而JMeter的测试计划里没加思考时间,50个线程全速循环打接口,所以请求数和吞吐量自然更高。去掉思考时间的话,k6基于Go的goroutine,并发能力同样很强,而且内存占用比JMeter低不少。
而且k6的结果可以直接输出到Grafana。如果你团队已经在用Grafana做监控,那性能测试数据和线上监控数据可以放在同一个dashboard里看,这个体验是JMeter给不了的。
k6的一个小遗憾是:它不是一个完整的Node.js运行时,你不能 npm install 然后 require 随便一个包。这意味着如果你有复杂的测试逻辑依赖第三方库,可能会受限。不过对于90%的性能测试场景,k6的built-in能力已经够用了。
05 Locust:Python党的快乐老家
PYTHON党的快乐老家
最后是Locust。作为一个经常写Python的人,Locust的体验是最舒服的。
from locust import HttpUser, task, between

class PerformanceTest(HttpUser):
    wait_time = between(1, 2)
    token = None

    def on_start(self):
        """登录获取token"""
        response = self.client.post("/api/login", json={
            "username": "testuser",
            "password": "testpass"
        })
        self.token = response.json()["access_token"]

    @task(3)
    def get_products(self):
        """查询商品列表(权重3)"""
        self.client.get(
            "/api/products?page=1&size=20",
            headers={"Authorization": f"Bearer {self.token}"}
        )

    @task(1)
    def get_product_detail(self):
        """查询商品详情(权重1)"""
        self.client.get(
            "/api/products/1",
            headers={"Authorization": f"Bearer {self.token}"}
        )
|
Locust的思路很妙:你把每个虚拟用户建模成一个Python类, @task 装饰器定义用户行为, wait_time 控制行为间隔。 on_start 相当于用户登录,每个虚拟用户只执行一次。
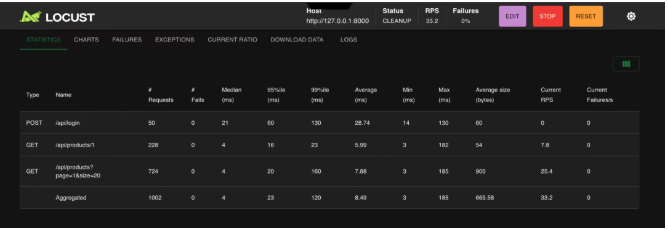
而且Locust自带一个Web UI,启动后打开浏览器,你可以实时看到 RPS 、响应时间、失败率,还能在测试运行中动态调整并发数。
Locust Web UI
Locust的结果:平均响应时间8.49ms,95线23ms,吞吐量约33 req/s,共1002个请求。
吞吐量最低,同样是脚本配置决定的—— wait_time = between(1, 2) 平均1.5秒打一轮,50个用户每秒大约33个请求,符合预期。Locust用gevent协程实现高并发,内存占用介于k6和JMeter之间,单个进程也能轻松撑起几千并发。
Locust最让我喜欢的一点是:因为测试脚本就是普通Python,你可以用任何Python库。想用Faker生成随机测试数据? pip install faker ,直接import。想用 Pandas 分析结果?随便写。这种灵活性在复杂场景下特别有用。
06 三组数据摆在一起
把同一场景下三个工具的实测数据拉出来看看:
| 维度 | JMeter | k6 | Locust |
| 脚本代码量 |
GUI操作,XML不可读 |
28行JS |
25行Python |
| 上手时间 |
~15分钟 |
~5分钟 |
~8分钟 |
| 50并发吞吐量 |
~424 req/s |
~97 req/s |
~33 req/s |
| 95线延迟 |
203ms |
38.61ms |
23ms |
| 平均响应时间 |
116ms |
12.76ms |
8.49ms |
| 总请求数 |
12,697 |
3,000 |
1,002 |
| 内存占用 |
较高(JVM) |
较低 |
中等 |
| CI/CD集成 |
可行但别扭 |
原生支持 |
原生支持 |
| 实时监控 |
需插件 |
Grafana原生 |
自带Web UI |
| 分布式支持 |
Master-Worker |
k6 Cloud付费 |
原生分布式 |
先说明一个关键前提:三组数据的脚本节奏不同,不能直接比吞吐量。JMeter的测试计划没加思考时间,50个线程全速循环打接口;k6脚本里有 sleep(1) ,Locust脚本里有 between(1, 2) ,都在模拟用户思考时间。所以JMeter的吞吐量(~424 req/s)远高于k6(~97 req/s)和Locust(~33 req/s),这是脚本配置决定的,不是工具本身的差距。30秒内JMeter打了12697个请求,k6打了3000个,Locust只打了1002个,差距主要来自这里。
真正能横向对比的是响应时间:JMeter平均116ms、95线203ms,明显高于k6(12.76ms/38.61ms)和Locust(8.49ms/23ms)。这部分差距一方面是因为JMeter全速打导致服务端压力更大(每秒400+请求 vs k6的97和Locust的33),另一方面也反映了JMeter本身基于JVM、线程模型相对 heavier 的特性。k6和Locust因为脚本里有间隔,服务端压力小,响应时间自然更低。
不过这里有个重要的前提得说清楚:吞吐量数据跟被测系统、网络环境、机器配置都有关。你跑出来的数字可能跟我不同。真正有意义的是相对差距,而不是绝对值。
07 别只看跑分,看团队
数据归数据,但选工具从来不只是看跑分。
我见过太多团队选工具时只看"谁更快",结果选了k6,团队里没人会写JS,两个月后脚本就没人维护了。也见过团队守着JMeter不肯换,但每次CI跑压测都要手动启动JMeter GUI,发版节奏被拖得要死。
说实话,选性能测试工具,比选框架更看团队基因。
JMeter适合你,如果团队QA为主、习惯GUI操作,测试场景复杂不止HTTP,插件生态是刚需,不介意XML管理和JVM调优。
k6适合你,如果团队以开发者为主、JS/TS是主力语言,已经在用Grafana做监控,压测脚本要进Git做Code Review,CI/CD流水线里跑性能测试是刚需。命令行就是最好的GUI。
Locust适合你,如果Python是团队主力语言,需要高度自定义的测试逻辑,想要一个轻量Web UI实时看数据,分布式压测是刚需且不想付费。
这个决策逻辑比"谁更快"有用得多。
08 最后
跑完这个周末,我最大的感受倒不是"k6好快"或者"JMeter好重"。
而是:性能测试工具的选型,本质上是在选"让谁舒服"。
选JMeter,QA舒服。选k6,开发者舒服。选Locust,Python程序员舒服。
没有谁绝对好,只有谁更适合你现在的团队。
但有一点是明确的:性能测试正在从"QA专属技能"变成"开发者的日常工具"。k6和Locust的崛起,背后是"测试左移"的大趋势——性能测试不再是一个独立阶段,而是CI/CD流水线里的一环。JMeter在这条路上走得比较吃力,GUI基因和XML格式跟现代DevOps流程确实有些格格不入。
当然,JMeter 5.6版本也加入了AI辅助场景生成和云端编排,28年的老将没那么容易倒下。
|
 学习助手




 订阅