| 编辑推荐: |
文章介绍了一款 JMeter 开源插件 jmeter-sse-llm-plugin,用于解决大模型 API 流式接口性能测试的难题,支持多种主流大模型协议,并提供图形化配置与实时指标监控,希望对你的学习有帮助。
本文来自于7dgroup-ai,由火龙果软件Alice编辑、推荐。 |
|
项目背景
随着大模型(LLM)的快速普及,性能测试成为验证系统承载能力的关键环节。然而,传统的 JMeter 测试大模型接口面临两大痛点:
- 协议复杂 :需要处理 SSE(Server-Sent Events)等实时流式协议
- 逻辑繁琐 :需要手动解析流式响应、计算 Token 速率等
jmeter-sse-llm-plugin 应运而生,专为解决这些痛点而设计。
什么是 jmeter-sse-llm-plugin?
一个基于 Apache JMeter 的 SSE 协议插件,支持主流大模型 API 格式,包括:
- OpenAI 兼容格式 (GPT-4, GPT-3.5 等)
- Dify API 格式
- Claude API 格式
- Gemini API 格式
插件通过 SSE 协议实时接收流式响应,并提供完整的性能指标采集能力。
核心功能
| 特性 | 说明 |
| SSE 流式接收 |
原生支持 Server-Sent Events 协议,实时接收模型响应 |
| 多协议支持 |
支持 OpenAI、Dify、Claude、Gemini 等主流格式 |
| 实时指标统计 |
Token 速率、响应时间、错误率实时监控 |
| 图形化配置 |
直观的 GUI 界面,无需手写复杂的 Groovy 脚本 |
| 自定义请求体 |
支持 JSON 模板、变量替换,灵活适配不同场景 |
快速上手
1. 安装插件
# 通过 Maven 构建
mvn clean package

# 将生成的 JAR 放入 JMeter 的 lib/ext 目录
# 重启 JMeter 使其生效
|
2. 配置 SSE-LLM Stream Sampler
在 JMeter 测试计划中:
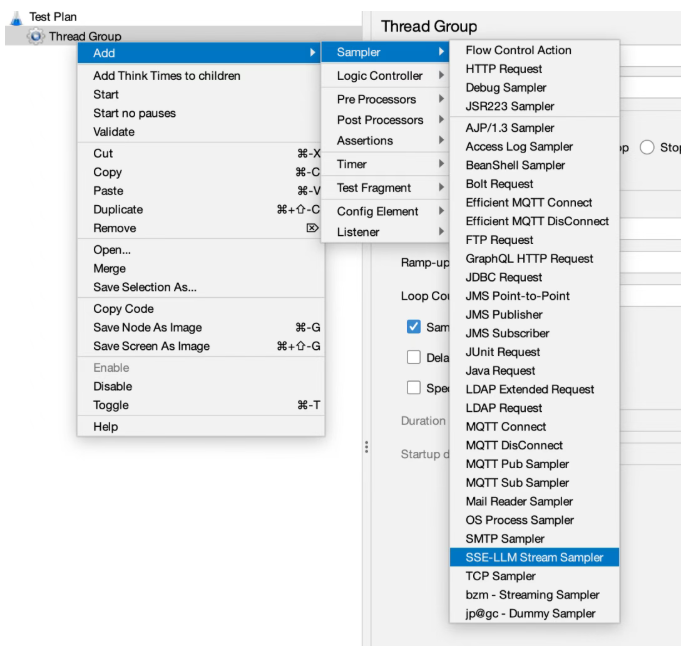
- 右键测试计划 -> 添加 -> SSE-LLM Stream Sampler (注意:JMeter 界面显示为此名称)
- 设置目标 URL (如 https://api.openai.com/v1/chat/completions )
- 选择 API 格式 (下拉菜单:OpenAI/Dify/Claude/Gemini)
- 配置认证信息 (API Key 等)
- 设置请求体模板 并启用变量替换
- 勾选 "Enable Stream Parse" 启用流式指标统计
关键点 :虽然 JMeter 界面显示为 "SSE-LLM Stream Sampler",但其底层 Java 类名为 SseStreamSampler (继承 AbstractSampler ),两者是一一对应的。文章后文提到的 SseStreamSampler 类名均指代这个 JMeter Sampler。
典型使用场景
场景一:压测 GPT-4 响应速度
目标 :验证GPT-4在不同并发下的Token生成速度。
配置示例 :
# Sampler配置
URL: https://api.openai.com/v1/chat/completions
API Format: OpenAI
Concurrent Users: 10, 50, 100 (分步测试)
Payload Template:
{
  "model": "gpt-4",
  "messages": [{"role": "user", "content": "${username}"}],
  "temperature": 0.7,
  "stream": true
}

# JMeter变量准备
# 在 CSV 文件中准备不同的 username 值
# 或使用 RandomString sampler 生成动态内容

# 期望指标关注
# - TTFT (首Token延迟) 随并发是否线性增长
# - Token/sec 是否在承受范围内
# - 错误率是否保持在可接受阈值以内
|
典型结果分析 :
| 并发数 | Avg TTFT (ms) | Avg Token/sec | Error Rate | Observation |
| 10 |
850 |
25 |
0% |
基线性能 |
| 50 |
920 |
23 |
0.5% |
轻微下降 |
| 100 |
1100 |
18 |
2.1% |
性能瓶颈显现 |
| 200 |
2100 |
12 |
8.5% |
触发阈值,需优化 |
从图中可以清晰看到:并发50左右是系统的最佳平衡点,超过该阈值性能呈指数级下降。这也提醒我们在规划容量时,需要预留一定的安全margin。
# 配置示例
URL: https://api.openai.com/v1/chat/completions
Model: gpt-4
Concurrent Users: 10-100
Payload: {
  "messages": [{"role": "user", "content": "${username}"}],
  "temperature": 0.7
}
|
场景二:Dify 工作流性能测试
目标 :测试Dify平台内置工作流的流式响应性能。
配置示例 :
# Sampler配置
URL: https://your-dify-instance.com/v1/run
API Format: Dify
Workflow ID: text-summary-workflow
Payload Template:
{
  "query": "${user_input}",
  "response_type": "stream",
  "user": "${user_id}",
  "files": []  // 如需上传文件
}

# 特殊配置
# Dify特有:支持 event 类型过滤
# 可在插件配置中过滤特定事件类型(如: "ChatMessage", "MessageDelta")

# 监控重点
# - 不同事件类型的响应时间差异
# - 文件上传场景下的带宽利用率
# - 工作流执行的完整耗时
|
Dify特有指标解析 :
Dify的SSE响应包含多种事件类型,插件支持实时统计:
| 事件类型 | 说明 | 关注指标 |
| ChatMessage |
完整的消息内容事件 |
Token总数, 响应时长 |
| MessageDelta |
消息增量事件(流式输出的核心) |
Token/sec, 每 delta 的 token 数 |
| ThreadStart |
线程开始事件 |
连接建立时间 |
| ThreadEnd |
线程结束事件 |
完整响应耗时 |
| Feedback |
用户反馈事件 |
业务层面的标记 |
实战技巧 :在压测Dify工作流时,可以通过过滤 MessageDelta 事件,专门监控 Token 生成的实时速率,这比单纯看总响应时间更能反映模型的输出流畅度。
URL: https://your-dify-instance/v1/run
Workflow ID: your-workflow-id
Input: {"question": "${user_input}"}
|
场景三:Claude 流式对话测试
目标 :评估Claude模型的对话流畅度和Token输出速率。
配置示例 :
# Sampler配置
URL: https://api.anthropic.com/v1/messages
API Format: Claude
Model: claude-3-5-sonnet-20240620
Payload Template:
{
  "model": "claude-3-5-sonnet-20240620",
  "max_tokens": 1024,
  "temperature": 0.5,
  "stream": true,
  "messages": [{"role": "user", "content": "${dialogue_prompt}"}]
}

# Claude特有特性
# - 支持 content block 的流式输出
# - 可监控每个 delta 的 token 变化
# - 特有的 stop reason 监控(如: end_turn, tool_use)

# 关键指标
# - 每轮对话的首Token延迟
# - 连续输出的平滑度(无明显卡顿)
# - Token成本与速率的平衡点
|
Claude协议细节 :
Claude的SSE响应结构与OpenAI有所不同,关键特性包括:
- Delta 结构 :每个 data: 事件包含 delta 对象,其中 delta.text 为实际的文本片段, delta.stop 表示是否为最后一段
- Content Block :支持多个 content block 同时流式输出,插件会对其进行拼接计算
- Stop Reason :响应结束时的 stop_reason 字段( end_turn , tool_use , max_tokens 等)可用于判断生成是否正常结束
监控建议 :在Claude测试中,重点关注 Time Between Deltas 指标,该值越接近恒定,说明模型输出的平滑度越高,用户体验更好。
URL: https://api.anthropic.com/v1/messages
Max Tokens: 1024
Temperature: 0.5
|
近期更新 (v1.0.0)
本次发布包含:
- ✅ 支持 OpenAI 兼容 API 格式
- ✅ 支持 Dify API 格式
- ✅ 支持 Claude API 格式
- ✅ 支持 Gemini API 格式
- ✅ SSE 协议流式解析
- ✅ 完整的性能指标统计
- ✅ 图形化配置面板
- ✅ Groovy 脚本移除,纯 Java 实现
关键改进 :移除了原有的 Groovy Sampler 文件,改用纯 Java 实现,提升稳定性和兼容性。同时插件内置了 15+ 维度的实时指标监控,无需手动后处理即可获取完整的性能数据。
最佳实践
1. 变量替换:动态测试不同输入
利用 JMeter 的 ${} 语法可以轻松实现动态测试。例如:
- ${username} :测试不同用户的对话内容
- ${prompt_content} :批量测试多种场景下的模型响应
- 通过 CSV Data Set Config 读取大规模测试数据集
- 结合 Random String Generator 生成随机参数,覆盖更多边缘情况
实战技巧 :在 SSE-LLM Stream Sampler (技术类名 SseStreamSampler ) 的请求体模板中,使用 ${VARIABLE_NAME} 语法自动填充,无需手动修改 JSON 结构。配合 JDBC Request 或 CSV File Reading, 可实现“一次配置,多轮变参”测试。
2. 分步测试策略:从单用户到大规模并发
性能测试应遵循“由简入繁”的原则:
| 测试阶段 | 目标 | 关注指标 |
| 阶段一:单用户验证 |
验证基本连接和响应 |
首Token延迟 (TTFT), 连接成功率, 基础Token速率 |
| 阶段二:并发逐步增加 |
发现性能瓶颈 |
Token/sec变化趋势, TTFT随并发的增长情况, 错误率上升临界点 |
| 阶段三:峰值负载测试 |
确定系统上限 |
最大支持并发数, 尾延迟 (P99) 效应, 资源耗尽前的警告信号 |
| 阶段四: 长时间稳定性 |
验证系统稳定性 |
内存泄漏迹象, 连接累积, 逐渐恶化的性能趋势 |
避坑指南 :
- 每个并发层级运行足够时间(建议5-10分钟),确保数据的显著性
- 留出安全 margin,实际生产负载建议预留 20% 性能头room
- 注意观察 SseMetrics 中的连接计数,防止连接泄漏
3. 阈值设置:及时发现接口抖动
合理的阈值配置是测试能否及时发现问题的关键。建议阈值设置参考:
| 指标 | 推荐阈值 | 触发警报阈值 | 严重阈值 |
| 错误率 |
< 1% |
> 3% |
> 5% |
| 首Token延迟 (TTFT) |
< 1000ms |
> 2000ms |
> 5000ms |
| Token速率 |
> 15 tokens/sec |
< 10 tokens/sec |
< 5 tokens/sec |
| 响应时长 |
< 3000ms |
> 5000ms |
> 10000ms |
实战技巧 :
- 在 JMeter 的 SseMetricsListenerGui 中配置颜色编码的阈值警报
- 设置 SseBackendListenerClient 的自动停止条件,避免异常时长跑测
- 结合过滤器,仅监控 MessageDelta 事件类型的核心指标,降噪分析
4. 日志分析:多维度排查问题
有效的问题排查需要同时关注 JMeter 侧和模型侧的日志:
JMeter 日志关注点 :
- SseStreamSampler (JMeter 显示名: SSE-LLM Stream Sampler ) 的 INFO 级别输出,包含连接建立、流式数据接收状态
- 查看 jmeter.log 中的 WARN / ERROR ,定位协议解析异常
- 监控 SseBackendListenerClient 的心跳日志,检测连接中断原因
模型侧日志关注点 :
- API 请求的完整原始日志,验证请求体是否符合预期
- Token 生成的计数日志,与 JMeter 采集的 Token 总数对比
- 错误码和 retry 机制的日志输出,确认是客户端还是服务端问题
排查思路 :
- 首先通过 SseMetricsListenerGui 定位性能瓶颈在哪个指标
- 查看对应模型的 API 文档,确认响应格式是否变更
- 检查网络环境是否有丢包、延迟波动
- 通过对比原始响应日志,确认是解析错误还是数据传输异常
5. JMeter 中配置插件详解
将 SSE-LLM Stream Sampler (技术类名 SseStreamSampler ) 集成到测试计划的完整步骤:
步骤 1:插件安装
# Maven 构建生成 JAR
mvn clean package

# 将 target/jmeter-sse-llm-plugin-1.0.0.jar 复制至 JMeter 的 lib/ext 目录
# 重启 Jmeter 使插件生效
|
步骤 2:配置面板展示
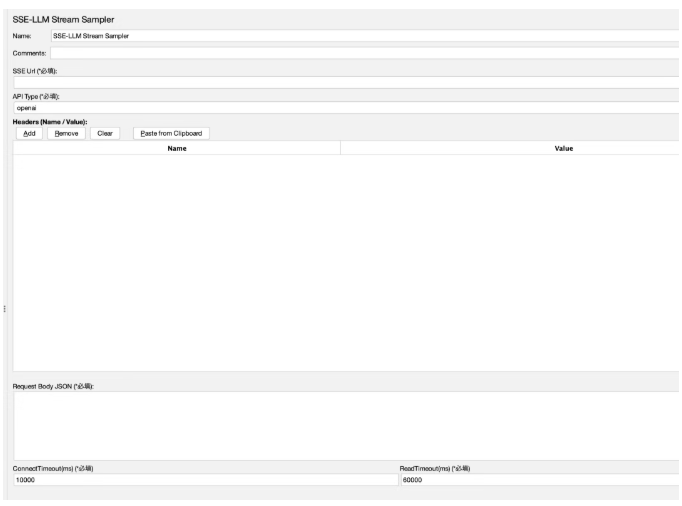
将 SSE-LLM Stream Sampler 添加到测试计划后,可以清晰看到插件的配置面板:
添加后,很清楚看到插件的配置面板
步骤 2:Sampler 配置面板关键参数 打开测试计划,右键添加 -> SSE-LLM Stream Sampler (JMeter 界面显示名称,对应类名 SseStreamSampler ) ,配置面板如下:
| 参数分类 | 关键配置 | 说明 |
| 基本设置 |
Server Name or IP |
目标 API 的主机地址 |
| Protocol |
通常留空,由 URL 决定 |
| Port |
API 服务端口,如 443 |
| Path |
完整请求路径,如 /v1/chat/completions |
| 认证信息 |
API Key |
直接在插件中输入,或通过 HTTP Header Manager 传递 |
| Auth Type |
选择 Bearer Token 等 |
| 请求体配置 |
API Format |
下拉选择:OpenAI / Dify / Claude / Gemini |
| Request Body Template |
JSON 模板,支持 ${variable} 变量替换 |
| Enable Stream Parse |
必填 :开启后才会统计 Token/秒等流式指标 |
| Timeout (s) |
超时时间,防止连接挂起,建议 60-120s |
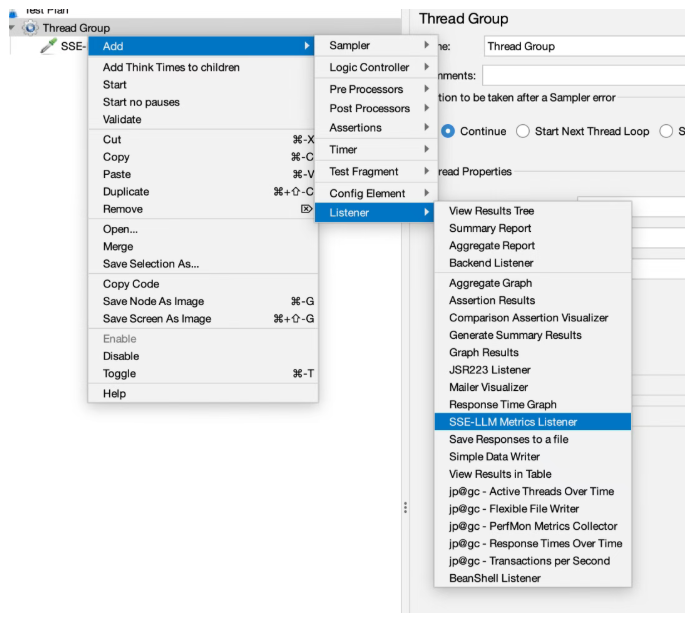
步骤 3:配套监控组件 为获得完整监控效果,建议在测试计划中添加:
- SseBackendListenerClient :后端监听器,负责采集 SSE 流数据
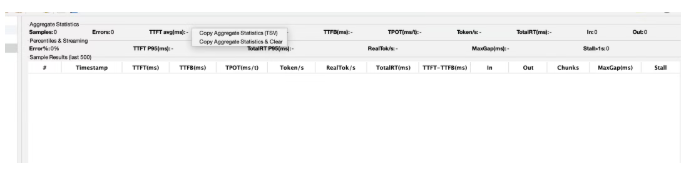
- SseMetricsListenerGui :可视化视图面板,实时展示 Token/sec, TTFT, 错误率等
- JSR223 Post Processor :可在采样器后添加自定义结果处理逻辑
配置示例截图描述 :
SseStreamSampler 配置面板展示了 API Format 选择、Request Body Template 输入框以及 Enable Stream Parse 选项开关。界面友好,无需编写 Groovy 脚本即可完成复杂的 SSE 协议配置。
6. 结果导出 Excel 两种方式
测试结束后,将结果导出 Excel 便于分析和报告:
方式一:右键菜单导出(最常用)
- 在 JMeter 左侧树中选中 Test Plan 或 Thread Group
- 点击右键,选择 Save Response Data 或 Save Sampler Data
- 在弹出的对话框中选择 Save as CSV 或 Save as XML
- 使用 Excel 打开 .csv 文件,或通过 Data -> From Text/CSV 导入
- 优点 :操作简单,适合快速查看关键指标
- 缺点 :大文件时可能存在性能损耗,格式需二次整理
方式二:结果收集器导出(适合大规模数据)
- 在测试计划中添加 CSV Result Service 或 JDBC Result Collector
- 配置输出路径和格式(逗号分隔、制表符分隔等)
- 测试运行完成后,结果文件将自动写入指定目录
- 使用 Python/Pandas 等工具进行深度分析:
import pandas as pd
df = pd.read_csv('jmeter-results.csv')
# 关键分析:df.groupby('合并指标').agg(['mean', 'max', 'count'])
|
- 优点 :适合自动化 CI/CD 流程,支持大数据量、自定义字段
- 缺点 :需要一定的技术成本配置和后处理脚本
方式二:结果收集器导出(适合大规模数据)
- 在测试计划中添加 CSV Result Service 或 JDBC Result Collector
- 配置输出路径和格式(逗号分隔、制表符分隔等)
- 测试运行完成后,结果文件将自动写入指定目录
- 使用 Python/Pandas 等工具进行深度分析:
import pandas as pd
df = pd.read_csv('jmeter-results.csv')
# 关键分析:df.groupby('合并指标').agg(['mean', 'max', 'count'])
|
- 优点 :适合自动化 CI/CD 流程,支持大数据量、自定义字段
- 缺点 :需要一定的技术成本配置和后处理脚本
实战建议 :
- 日常分析选用 右键菜单导出 CSV ,快速查看 TTFT、Token/sec 等核心指标变化
- 项目复盘或正式报告选用 CSV Result Collector ,结合 Python 脚本生成包含置信区间的统计图表
- 两种方式可结合使用:先用右键快速筛选异常样本,再用正式导出进行深入分析
获取与反馈
- GitHub : https://github.com/7dgroup-ai/jmeter-sse-llm-plugin
- Release : v1.0.0 (已发布,可直接下载 JAR)
- issues : 欢迎提交 Bug 和 feature request
结语
无论你是想进行大模型 API 的性能基准测试,还是需要验证自己的部署环境, jmeter-sse-llm-plugin 都能帮你事半功能。从今天开始,用 JMeter 来“体检”你的大模型服务吧!
|
 学习助手




 订阅